Logistic Regression چیست؟ آموزش کامل رگرسیون لجستیک در یادگیری ماشین
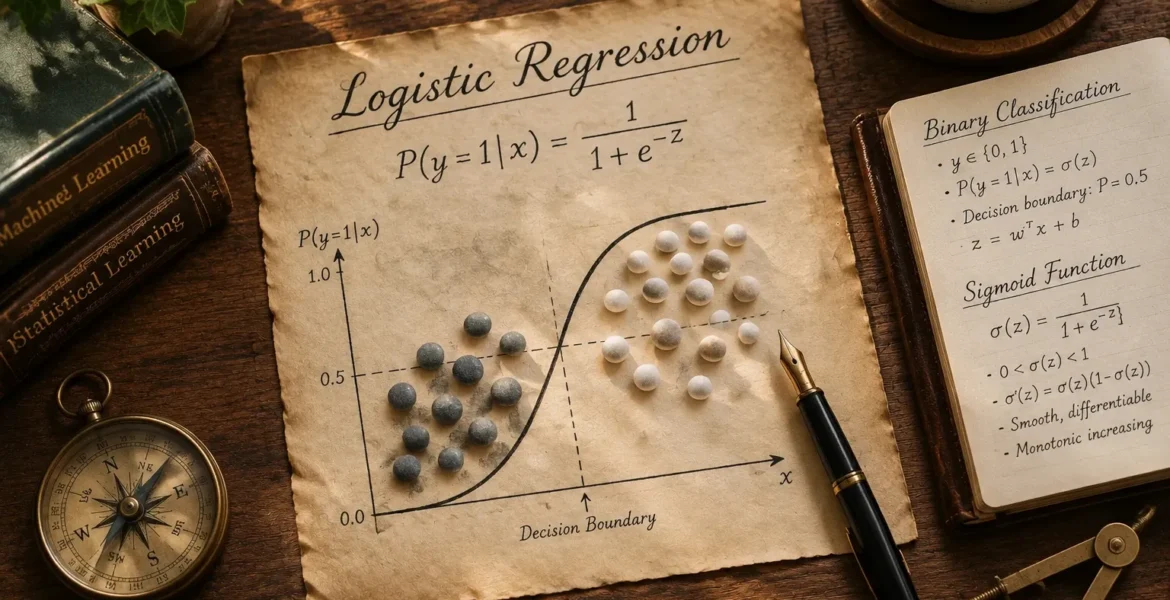
Logistic Regression چیست؟ آموزش کامل رگرسیون لجستیک در یادگیری ماشین
Logistic Regression چیست؟ آشنایی کامل با رگرسیون لجستیک در یادگیری ماشین
Logistic Regression یا رگرسیون لجستیک یکی از الگوریتمهای مهم و پرکاربرد در یادگیری ماشین است که بیشتر برای مسائل طبقهبندی (Classification) استفاده میشود. برخلاف چیزی که از نام آن ممکن است برداشت شود، Logistic Regression معمولاً برای پیشبینی یک مقدار عددی پیوسته مانند قیمت یا دما به کار نمیرود؛ بلکه هدف اصلی آن تعیین احتمال تعلق یک نمونه به یک کلاس و در نهایت دستهبندی آن است.
برای مثال، میتوان از رگرسیون لجستیک برای پاسخ به سؤالهایی مانند آیا یک ایمیل Spam است یا معمولی؟، آیا یک مشتری محصولی را خریداری میکند یا خیر؟، آیا یک تراکنش بانکی مشکوک است یا عادی؟ و آیا یک درخواست وام با ریسک نکول مواجه است یا خیر؟ استفاده کرد.
رگرسیون لجستیک به دلیل سادگی، سرعت مناسب، قابلیت تفسیر ضرایب و عملکرد قابلقبول در بسیاری از مسائل، همچنان یکی از مدلهای پایه و مهم در یادگیری ماشین محسوب میشود.
در این مقاله چه چیزهایی یاد میگیرید؟
-
Logistic Regression چیست و چه مسئلهای را حل میکند؟ -
تفاوت Regression و Classification و دلیل نامگذاری -
تابع Sigmoid، احتمال و Decision Boundary -
Odds، Log-Odds، ضرایب مدل و Odds Ratio -
آموزش مدل با Maximum Likelihood و Log Loss -
Regularization، Class Imbalance و Calibration مدل
فهرست مطالب
- Logistic Regression چیست؟
- جایگاه آن در یادگیری ماشین
- چرا به آن Logistic Regression میگوییم؟
- Logistic Regression چگونه کار میکند؟
- تابع Sigmoid و نقش آن
- Decision Boundary یا مرز تصمیم
- Odds و Log-Odds
- ضرایب مدل و Odds Ratio
- آموزش مدل و بهینهسازی
- فرضیات Logistic Regression
- Perfect Separation
- Class Imbalance و مدیریت آن
- Regularization، L1 و L2
- انواع Logistic Regression
- معیارهای ارزیابی
- Calibration و Threshold
- کاربردها، مزایا و محدودیتها
- مقایسه با Linear Regression و مدلهای دیگر
- پیادهسازی در Python و مراحل پروژه
- سوالات متداول
- جمعبندی
Logistic Regression چیست؟
Logistic Regression یک مدل آماری و الگوریتم یادگیری ماشین برای طبقهبندی است که از ترکیبی خطی از ویژگیهای ورودی استفاده میکند و سپس این مقدار را به کمک تابع Logistic یا Sigmoid به یک احتمال تبدیل میکند.
به زبان ساده، مدل ابتدا بررسی میکند که ویژگیهای یک نمونه چه مقدار با یک کلاس ارتباط دارند و سپس احتمال قرار گرفتن آن نمونه در یک کلاس را محاسبه میکند.
فرض کنید میخواهیم پیشبینی کنیم که آیا یک مشتری محصولی را خریداری میکند یا خیر. ویژگیهای ورودی میتوانند شامل مواردی مانند سن مشتری، درآمد، تعداد خریدهای قبلی، مدت زمان عضویت و تعداد بازدید از سایت باشند.
متغیر هدف نیز میتواند به شکل زیر تعریف شود:
y = 0 → خرید انجام نشده است
مدل به جای اینکه مستقیماً مقدار 0 یا 1 را پیشبینی کند، ابتدا احتمال کلاس 1 را محاسبه میکند.
برای مثال:
یعنی مدل بر اساس اطلاعات موجود، احتمال تعلق این نمونه به کلاس 1 را حدود 82 درصد برآورد کرده است.
سپس با استفاده از یک آستانه تصمیم (Threshold)، این احتمال به یک کلاس تبدیل میشود.
برای مثال، اگر آستانه را 0.5 در نظر بگیریم:
- احتمال 0.82 → کلاس 1
- احتمال 0.31 → کلاس 0
بنابراین، Logistic Regression را میتوان مدلی دانست که احتمال وقوع یک کلاس را تخمین میزند و بر اساس آن تصمیم طبقهبندی میگیرد.
Logistic Regression در کجای یادگیری ماشین قرار میگیرد؟
رگرسیون لجستیک معمولاً در دسته یادگیری نظارتشده (Supervised Learning) قرار میگیرد؛ زیرا برای آموزش مدل به دادههایی نیاز داریم که خروجی یا Label آنها مشخص باشد.
در یادگیری نظارتشده، مدل از نمونههایی شامل ورودی و خروجی واقعی یاد میگیرد و سپس برای دادههای جدید پیشبینی انجام میدهد.
چرا به آن Logistic Regression میگوییم؟
نام Logistic Regression ممکن است در ابتدا کمی گیجکننده باشد. چرا الگوریتمی که برای Classification استفاده میشود، Regression نام دارد؟
دلیل آن این است که مدل ابتدا یک ترکیب خطی از ویژگیها ایجاد میکند و سپس این مقدار را از طریق تابع Logistic به احتمال تبدیل میکند.
به عبارت دیگر، بخش خطی مدل به شکل زیر است:
اما مقدار z مستقیماً خروجی نهایی نیست. این مقدار وارد تابع Sigmoid میشود تا به بازه صفر تا یک تبدیل شود:
در نتیجه، Logistic Regression از یک ساختار خطی برای مدلسازی احتمال استفاده میکند. به همین دلیل، Logistic Regression معمولاً به عنوان یک مدل خطی برای Classification شناخته میشود.
Logistic Regression چگونه کار میکند؟
برای درک عملکرد Logistic Regression بهتر است فرآیند آن را مرحلهبهمرحله بررسی کنیم.
فرض کنید میخواهیم احتمال خرید یک محصول توسط مشتری را پیشبینی کنیم. مدل ابتدا ویژگیهای ورودی را دریافت میکند:
سپس یک ترکیب خطی ایجاد میکند:
بعد مقدار z وارد تابع Sigmoid میشود:
خروجی p عددی بین صفر و یک خواهد بود. برای مثال:
یعنی مدل احتمال کلاس 1 را 76 درصد تخمین زده است. در نهایت، با توجه به Threshold، کلاس نهایی مشخص میشود.
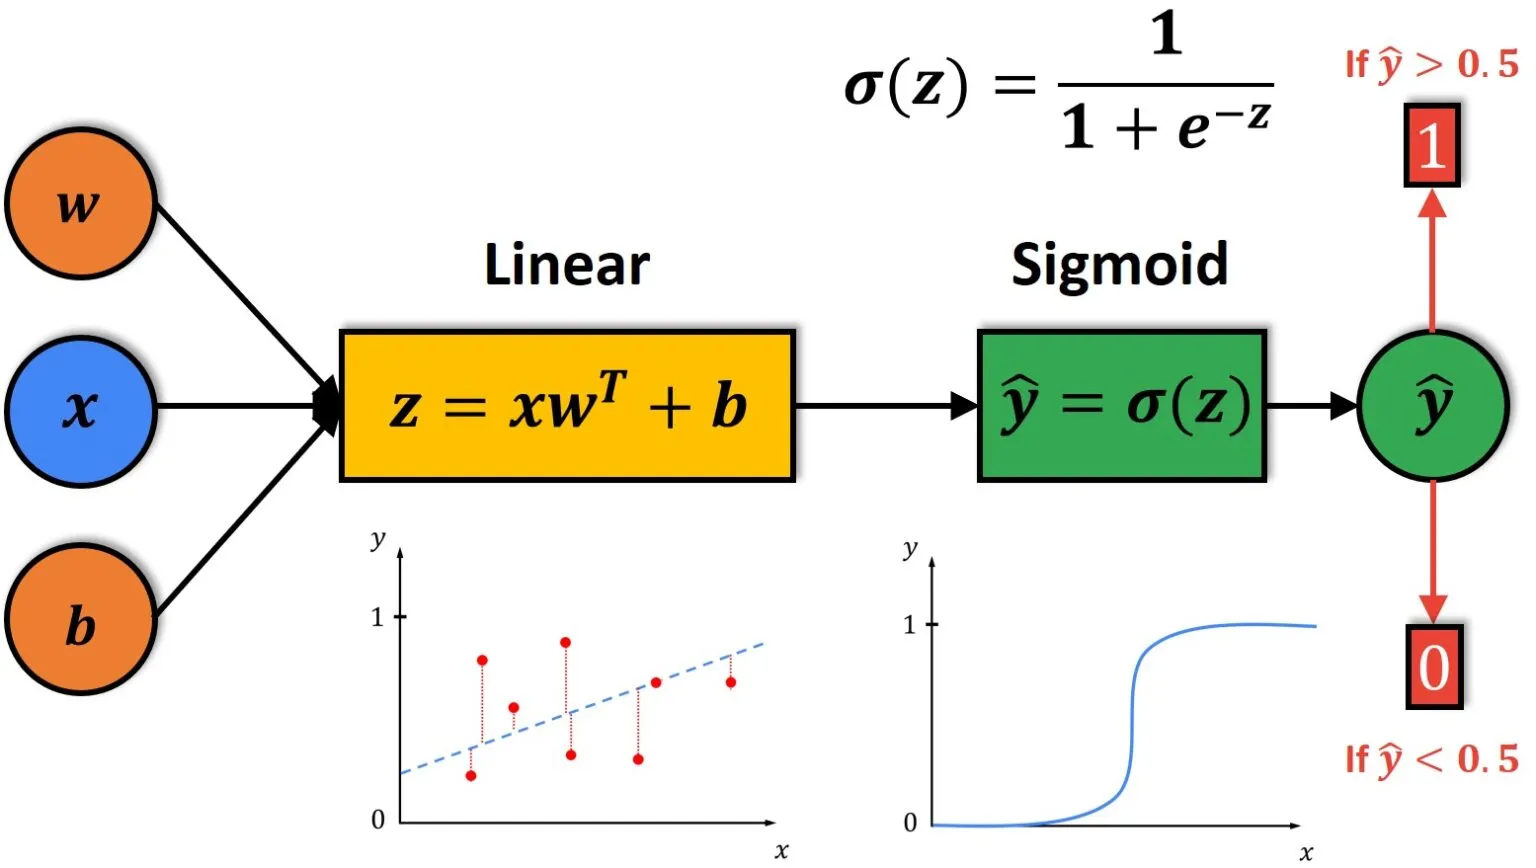
تابع Sigmoid چیست؟
مهمترین بخش Logistic Regression، تابع Sigmoid است. تابع Sigmoid به صورت زیر تعریف میشود:
این تابع هر مقدار عددی را به عددی بین 0 و 1 تبدیل میکند. برای مثال:
| مقدار z | خروجی Sigmoid |
|---|---|
| -5 | تقریباً 0 |
| -2 | تقریباً 0.12 |
| 0 | 0.50 |
| 2 | تقریباً 0.88 |
| 5 | تقریباً 0.99 |
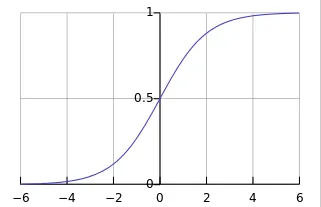
بنابراین هرچه z بزرگتر شود، خروجی Sigmoid به 1 نزدیکتر میشود و هرچه z کوچکتر شود، خروجی به صفر نزدیکتر خواهد شد. این ویژگی باعث میشود بتوانیم خروجی مدل را به عنوان احتمال تفسیر کنیم.
چرا Logistic Regression به Sigmoid نیاز دارد؟
اگر از یک مدل خطی ساده استفاده کنیم، خروجی میتواند هر مقدار عددی باشد؛ برای مثال:
اما احتمال باید بین 0 و 1 باشد. بنابراین نمیتوانیم خروجی خام یک مدل خطی را مستقیماً به عنوان احتمال تفسیر کنیم.
تابع Sigmoid این مشکل را حل میکند و بازه (∞- تا ∞+) را به بازه (0 تا 1) تبدیل میکند. در نتیجه، مدل میتواند خروجی خود را به شکل احتمال بیان کند.
مثال ساده از Logistic Regression
فرض کنید یک مدل میخواهد احتمال خرید یک محصول را بر اساس درآمد مشتری تخمین بزند. برای یک مشتری، مدل ممکن است به این نتیجه برسد:
اگر Threshold برابر 0.5 باشد، چون 0.83 > 0.5، مدل مشتری را در کلاس «خرید خواهد کرد» قرار میدهد.
برای مشتری دیگری ممکن است داشته باشیم:
چون 0.27 < 0.5، مدل او را در کلاس «خرید نخواهد کرد» قرار میدهد.
نکته مهم این است که 0.83 خودِ کلاس نیست؛ احتمال برآوردشده توسط مدل است.
Decision Boundary یا مرز تصمیم چیست؟
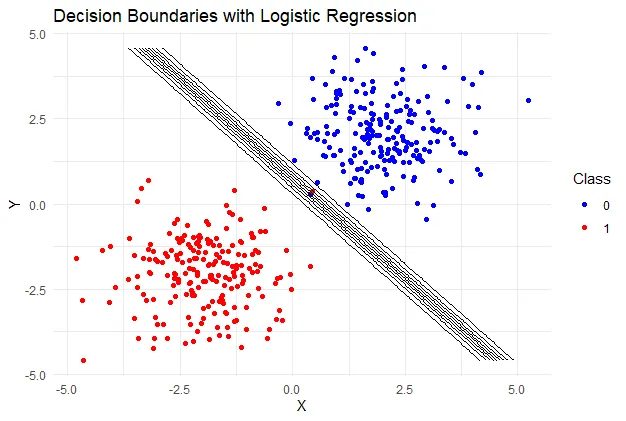
مرزی که در فضای ویژگیها کلاسهای مختلف را از یکدیگر جدا میکند، Decision Boundary نام دارد.
در حالت دودویی، اگر Threshold برابر 0.5 باشد، در نقطهای که P(y=1|X) = 0.5 قرار داریم. از آنجا که σ(z) = 0.5 زمانی اتفاق میافتد که z = 0، مرز تصمیم مدل از رابطه زیر به دست میآید:
در حالت دو ویژگی، این مرز معمولاً یک خط است. در فضای سهبعدی میتواند یک صفحه باشد و در ابعاد بالاتر، یک Hyperplane خواهد بود.
Odds و Log-Odds در Logistic Regression
یکی از مفاهیم مهم برای درک عمیقتر Logistic Regression، Odds است. اگر احتمال وقوع یک رویداد برابر p باشد، Odds به صورت زیر تعریف میشود:
برای مثال اگر p = 0.8 باشد، آنگاه:
یعنی شانس وقوع رویداد نسبت به عدم وقوع آن برابر 4 به 1 است.
در Logistic Regression، لگاریتم Odds یا Log-Odds به شکل یک رابطه خطی مدلسازی میشود:
این رابطه یکی از پایههای نظری مهم Logistic Regression است.
ضرایب Logistic Regression چه معنایی دارند؟
هر ویژگی در مدل یک ضریب دارد. برای مثال:
ضریب β₁ نشان میدهد تغییر x₁ چه اثری بر Log-Odds نتیجه دارد، در حالی که سایر ویژگیها ثابت نگه داشته شدهاند.
- اگر β₁ > 0 باشد: افزایش x₁ باعث افزایش Log-Odds کلاس 1 میشود.
- اگر β₁ < 0 باشد: افزایش x₁ باعث کاهش Log-Odds کلاس 1 میشود.
- اگر ضریب نزدیک صفر باشد: اثر خطی آن ویژگی بر Log-Odds نیز کوچکتر است.
تفسیر متغیرهای دستهای
در مورد متغیرهای دستهای، ضریب هر دسته باید نسبت به یک گروه مرجع (Reference Category) تفسیر شود.
برای مثال فرض کنید متغیر «نوع اشتغال» سه گروه داشته باشد: کارمند، آزاد، بیکار. اگر «کارمند» به عنوان گروه مرجع انتخاب شود، ضریب مربوط به «آزاد» اثر قرار گرفتن در گروه آزاد را در مقایسه با کارمند نشان میدهد، در حالی که سایر متغیرها ثابت نگه داشته شدهاند.
بنابراین برای تفسیر صحیح ضرایب متغیرهای دستهای، همیشه باید مشخص باشد که Reference Category کدام گروه است.
نسبت شانس یا Odds Ratio چیست؟
با گرفتن نمایی از ضریب میتوان به Odds Ratio رسید:
این مقدار تفسیر کاربردیتری از ضریب ارائه میدهد:
- اگر eβj > 1 باشد: افزایش ویژگی با افزایش Odds کلاس 1 همراه است.
- اگر eβj < 1 باشد: افزایش ویژگی با کاهش Odds کلاس 1 همراه است.
برای مثال اگر βj = 0.693 باشد، آنگاه e0.693 ≈ 2؛ یعنی با افزایش یک واحدی آن ویژگی، در شرایط ثابت بودن سایر متغیرها، Odds تقریباً دو برابر میشود.
Logistic Regression چگونه آموزش داده میشود؟
در زمان آموزش، مدل باید ضرایب مناسبی برای ویژگیها پیدا کند؛ یعنی باید مقادیر β₀، β₁، …، βₚ به گونهای انتخاب شوند که پیشبینیهای مدل تا حد امکان با مقادیر واقعی سازگار باشند.
یکی از دیدگاههای اصلی برای آموزش Logistic Regression، Maximum Likelihood Estimation یا MLE است. در این رویکرد، ضرایب به گونهای تخمین زده میشوند که احتمال مشاهده دادههای واقعی تحت مدل بیشینه شود.
در عمل، این مسئله به کمینهسازی منفی Log-Likelihood یا همان Log Loss / Cross-Entropy Loss تبدیل میشود. برای یک نمونه:
و برای مجموعه داده، Loss نمونهها در قالب تابع هدف کلی مدل قرار میگیرد.
Logistic Regression با چه روشهایی بهینه میشود؟
پس از تعریف تابع هدف، باید ضرایب مدل به صورت عددی پیدا شوند. بسته به پیادهسازی و solver مورد استفاده، روشهایی مانند موارد زیر به کار میروند:
- Gradient Descent
- L-BFGS
- Newton-CG
- SAG
- SAGA
در Logistic Regression، تابع Log Loss نسبت به پارامترهای مدل محدب (Convex) است. بنابراین در شرایط مناسب، مسئله بهینهسازی دارای یک بهینه کلی است و روشهای مناسب میتوانند به آن برسند.
اما یک استثنای مهم وجود دارد: Perfect Separation میتواند باعث شود برآورد ضرایب متناهی وجود نداشته باشد و مسئله MLE به یک جواب متناهی همگرا نشود.
فرضیات Logistic Regression چیست؟
برای استفاده صحیح و تفسیر مناسب Logistic Regression، فقط نباید به عملکرد مدل توجه کرد؛ بلکه برخی مفروضات و شرایط داده نیز باید بررسی شوند. مهمترین موارد عبارتاند از:
- خطی بودن رابطه با Log-Odds: یکی از مهمترین فرضها این است که رابطه بین متغیرهای عددی و Log-Odds تا حد مناسبی خطی باشد. این فرض با «نرمال بودن ویژگیها» متفاوت است.
- استقلال مشاهدات: مشاهدات باید تا حد مناسبی مستقل از یکدیگر باشند. برای مثال، اگر چندین رکورد مربوط به یک فرد باشند، فرض استقلال ممکن است نقض شود. در دادههای طولی، تکرارشونده، خوشهای یا وابسته، ممکن است به مدلهای تخصصیتر مانند Mixed-Effects Logistic Regression نیاز باشد.
- نبود همخطی شدید: اگر چند ویژگی اطلاعات تقریباً یکسانی ارائه دهند، با مشکل Multicollinearity مواجه میشویم. همخطی شدید میتواند باعث ناپایداری ضرایب، افزایش خطای استاندارد و دشواری تفسیر شود.
- نبود نقاط پرت تأثیرگذار: وجود Outlierها یا مشاهدات با Influence بالا میتواند ضرایب مدل را بهشدت تحت تأثیر قرار دهد.
- حجم نمونه کافی: Logistic Regression نیز مانند بسیاری از مدلهای آماری، برای تخمین پایدار پارامترها به اطلاعات کافی نیاز دارد. حجم نمونه مورد نیاز به عواملی مانند تعداد ویژگیها، تعداد نمونههای هر کلاس، نسبت کلاسها، اندازه اثر و میزان پیچیدگی مدل وابسته است.
- نبود Perfect Separation: اگر ترکیبی از ویژگیها بتواند کلاسها را به طور کامل از یکدیگر جدا کند، ممکن است ضرایب MLE به سمت مقادیر بسیار بزرگ میل کنند و مدل با مشکل عدم همگرایی مواجه شود.
Perfect Separation چیست؟
فرض کنید دادهها را بتوان با یک خط به شکلی جدا کرد که تمام نمونههای کلاس 0 در یک طرف خط و تمام نمونههای کلاس 1 در طرف دیگر قرار داشته باشند.
در این شرایط، مدل میتواند با افزایش اندازه ضرایب، احتمال پیشبینی صحیح را بیشتر و بیشتر کند. در نتیجه، ممکن است ضرایب به سمت مقادیر بسیار بزرگ میل کنند و MLE متناهی وجود نداشته باشد.
راهحلهای Perfect Separation
- Regularization: استفاده از L1 یا L2 میتواند از رشد بدون محدودیت ضرایب جلوگیری کند.
- حذف یا اصلاح متغیرهای مشکلدار: اگر یک ویژگی باعث ایجاد Separation غیرواقعی یا ناشی از خطای داده شده باشد، بررسی و اصلاح آن ضروری است.
- روش Firth: Firth Logistic Regression یک روش اصلاحشده برای کاهش سوگیری تخمین Maximum Likelihood است و در شرایطی مانند Separation میتواند مفید باشد.
Class Imbalance در Logistic Regression چیست؟
یکی دیگر از چالشهای مهم، عدم توازن کلاسها یا Class Imbalance است. فرض کنید 95٪ دادهها کلاس 0 باشند و فقط 5٪ دادهها کلاس 1 باشند. در این شرایط، مدل ممکن است تحت تأثیر کلاس اکثریت قرار گیرد.
برای مثال، مدلی که تقریباً همه نمونهها را کلاس 0 پیشبینی کند، ممکن است Accuracy بالایی داشته باشد؛ اما در شناسایی کلاس اقلیت بسیار ضعیف باشد. بنابراین در دادههای نامتوازن نباید تنها به Accuracy تکیه کرد.
چگونه Class Imbalance را مدیریت کنیم؟
- استفاده از Class Weight: در scikit-learn میتوان از
class_weight='balanced'استفاده کرد. این تنظیم وزن بیشتری به کلاسهایی میدهد که نمونه کمتری دارند. - Resampling: روشهایی مانند Oversampling، Undersampling و SMOTE میتوانند برای تغییر توزیع نمونهها استفاده شوند. البته Resampling باید فقط روی داده آموزشی انجام شود تا Data Leakage ایجاد نشود.
- استفاده از معیارهای مناسب: در دادههای نامتوازن، معیارهایی مانند Precision، Recall، F1-Score، PR-AUC، Balanced Accuracy و MCC میتوانند اطلاعات مناسبتری نسبت به Accuracy ارائه دهند.
Regularization در Logistic Regression چیست؟
یکی از مشکلات احتمالی در مدلهای یادگیری ماشین، Overfitting است؛ یعنی مدل به جای یادگیری الگوهای عمومی داده، بیش از حد به دادههای آموزشی وابسته شود. یکی از روشهای کنترل این مشکل، استفاده از Regularization است.
در Logistic Regression میتوان از جریمههایی مانند L1 Regularization، L2 Regularization و Elastic Net استفاده کرد.
L1 و L2 در Logistic Regression
L1 Regularization: در L1، قدرمطلق ضرایب به تابع هدف اضافه میشود:
یکی از ویژگیهای مهم L1 این است که میتواند برخی ضرایب را دقیقاً به صفر برساند. به همین دلیل، در برخی مسائل میتواند به نوعی Feature Selection نیز کمک کند.
L2 Regularization: در L2، مربع ضرایب جریمه میشود:
در این حالت معمولاً ضرایب کوچکتر میشوند، اما لزوماً دقیقاً صفر نمیشوند.
Elastic Net: Elastic Net ترکیبی از L1 و L2 است و میتواند مزایای هر دو نوع Regularization را ترکیب کند.
Regularization در scikit-learn چگونه تنظیم میشود؟
در LogisticRegression کتابخانه scikit-learn، تنظیمات Regularization به چند پارامتر وابسته است. پارامتر penalty نوع جریمه را مشخص میکند و در تنظیمات پیشفرض فعلی، مقدار آن l2 است.
پارامتر C نیز معکوس شدت Regularization است:
Cکوچکتر ← Regularization قویترCبزرگتر ← Regularization ضعیفتر
مقدار پیشفرض C برابر C=1.0 است. اگر بخواهیم Regularization را عملاً بسیار ضعیف کنیم، میتوان C را بسیار بزرگ در نظر گرفت؛ البته این با «حذف کامل و دقیق Regularization» یکسان نیست و رفتار آن به solver و سایر تنظیمات نیز وابسته است.
همچنین همه solverها از همه انواع penalty پشتیبانی نمیکنند. برای مثال، liblinear برای Multinomial Logistic Regression مناسب نیست و محدودیتهایی در نوع penalty و ساختار مسئله دارد. بنابراین هنگام تنظیم مدل باید penalty، solver، نوع مسئله و مقدار C را در کنار یکدیگر بررسی کرد.
انواع Logistic Regression
رگرسیون لجستیک را میتوان بر اساس تعداد و ماهیت کلاسها به شکلهای مختلف استفاده کرد.
1. Binary Logistic Regression
در این حالت فقط دو کلاس داریم. برای مثال:
- Spam / Not Spam
- بیمار / سالم
- خرید / عدم خرید
- تقلب / عدم تقلب
این رایجترین شکل Logistic Regression است.
2. Multinomial Logistic Regression
در این حالت متغیر هدف بیش از دو کلاس دارد و مدل میتواند احتمال هر کلاس را به صورت همزمان مدل کند. برای مثال: قرمز، آبی، سبز یا کمخطر، متوسط، پرخطر.
Multinomial Logistic Regression را میتوان با نام Softmax Regression نیز شناخت؛ زیرا برای چند کلاس، از ساختار Softmax برای تبدیل امتیازهای مدل به احتمالات کلاسها استفاده میشود.
3. One-vs-Rest
در روش One-vs-Rest یا OvR برای هر کلاس یک مدل در مقابل تمام کلاسهای دیگر ساخته میشود. برای مثال اگر سه کلاس A، B و C داشته باشیم:
- A در برابر B و C
- B در برابر A و C
- C در برابر A و B
سپس مدل بر اساس خروجی این طبقهبندها کلاس مناسب را انتخاب میکند.
4. One-vs-One
در روش One-vs-One یا OvO برای هر جفت از کلاسها یک طبقهبند جداگانه ساخته میشود. برای سه کلاس A، B و C خواهیم داشت:
- A در برابر B
- A در برابر C
- B در برابر C
این روش در برخی الگوریتمهای چندکلاسه استفاده میشود، اما Logistic Regression در بسیاری از کاربردهای چندکلاسه بیشتر با Multinomial یا One-vs-Rest مورد استفاده قرار میگیرد.
5. Ordinal Logistic Regression
گاهی کلاسها فقط متفاوت نیستند، بلکه ترتیب معناداری نیز دارند. برای مثال: ضعیف، متوسط، خوب، عالی.
در چنین شرایطی، استفاده از Ordinal Logistic Regression میتواند مناسب باشد؛ زیرا ترتیب بین کلاسها را در مدل لحاظ میکند. این مدل با Multinomial Logistic Regression متفاوت است، زیرا در Multinomial فرض خاصی درباره ترتیب کلاسها وجود ندارد.
Logistic Regression چه معیارهایی برای ارزیابی دارد؟
Accuracy تنها معیار مناسب برای ارزیابی Logistic Regression نیست. انتخاب معیار باید به هدف مسئله، هزینه خطاها و بهخصوص توزیع کلاسها وابسته باشد.
Accuracy
نسبت پیشبینیهای درست به کل نمونهها:
Accuracy زمانی میتواند گمراهکننده باشد که کلاسها نامتوازن باشند.
Precision
از میان نمونههایی که مدل مثبت پیشبینی کرده، چند مورد واقعاً مثبت بودهاند؟
Recall
از میان نمونههای واقعاً مثبت، مدل چند مورد را شناسایی کرده است؟
F1-Score
ترکیبی از Precision و Recall است:
ROC-AUC
ROC-AUC توانایی مدل برای تفکیک کلاسها را در Thresholdهای مختلف بررسی میکند. اما در دادههای بسیار نامتوازن، ROC-AUC ممکن است تصویر بیش از حد خوشبینانهای از عملکرد مدل ارائه دهد. در چنین شرایطی، PR-AUC معمولاً اطلاعات مفیدتری درباره عملکرد مدل روی کلاس مثبت ارائه میدهد.
PR-AUC
Precision-Recall AUC یا PR-AUC بر رابطه بین Precision و Recall در Thresholdهای مختلف تمرکز دارد. این معیار بهخصوص زمانی مفید است که کلاس مثبت نادر باشد. برای مثال در تشخیص تقلب، اگر فقط بخش بسیار کوچکی از تراکنشها تقلبی باشند، PR-AUC میتواند معیار مناسبتری از ROC-AUC برای ارزیابی عملکرد روی کلاس اقلیت باشد.
Balanced Accuracy
Balanced Accuracy میانگین Recall کلاسهاست. برای مسائل نامتوازن، این معیار میتواند نسبت به Accuracy تصویر منصفانهتری از عملکرد مدل ارائه دهد.
Matthews Correlation Coefficient
معیار MCC یا Matthews Correlation Coefficient از معیارهایی است که میتواند برای ارزیابی Classification، بهخصوص در شرایط نامتوازن، مفید باشد. مقدار آن معمولاً در بازه 1- تا 1 قرار میگیرد:
- مقدار نزدیک 1 → پیشبینی بسیار خوب
- مقدار نزدیک صفر → عملکرد نزدیک به حالت تصادفی
- مقدار منفی → رابطه معکوس بین پیشبینی و واقعیت
Log Loss
Log Loss کیفیت احتمالات پیشبینیشده مدل را ارزیابی میکند. برای یک نمونه:
مدلی که احتمالهای خود را با اطمینان بالا اما اشتباه پیشبینی کند، جریمه سنگینی دریافت میکند. بنابراین Log Loss فقط به درست یا غلط بودن کلاس نهایی توجه نمیکند، بلکه کیفیت احتمالهای پیشبینیشده را نیز در نظر میگیرد.
Brier Score
Brier Score نیز برای ارزیابی کیفیت احتمالهای پیشبینیشده در Classification استفاده میشود. در حالت دودویی:
هرچه Brier Score کمتر باشد، پیشبینی احتمالی بهتر است. این معیار علاوه بر Discrimination، اطلاعاتی درباره Calibration مدل نیز ارائه میدهد.
Calibration در Logistic Regression چیست؟
فرض کنید مدل برای 100 نمونه احتمال حدود 0.8 پیشبینی کند. اگر مدل به خوبی Calibrated باشد، تقریباً 80 درصد از این نمونهها باید واقعاً در کلاس مثبت قرار داشته باشند.
بنابراین Calibration به این سؤال پاسخ میدهد: آیا احتمالهایی که مدل پیشبینی میکند با فراوانی واقعی رخدادها سازگار هستند؟
این موضوع در کاربردهایی که خود احتمال اهمیت دارد، مانند پزشکی، اعتبارسنجی مالی، مدیریت ریسک و پیشبینی احتمال خرید، بسیار مهم است.
Calibration Curve چیست؟
Calibration Curve یا Reliability Diagram، احتمالهای پیشبینیشده را با نسبت واقعی رخدادها مقایسه میکند. اگر مدل کاملاً Calibrated باشد، نقاط نمودار باید تقریباً روی خط y = x قرار بگیرند. اگر مدل احتمالهای بیش از حد بالا یا پایین تولید کند، از این خط فاصله خواهد گرفت.
روشهای Calibration مدل چیست؟
- Platt Scaling: یک روش Calibration پارامتری است که خروجی مدل را با یک Logistic Model دیگر کالیبره میکند.
- Isotonic Regression: یک روش غیرپارامتری است که رابطهای یکنواخت بین خروجی خام مدل و احتمال واقعی یاد میگیرد. این روش انعطافپذیرتر از Platt Scaling است، اما در دادههای کم ممکن است خطر Overfitting بیشتری داشته باشد.
- Brier Score: برای سنجش کیفیت احتمالات مدل مورد استفاده قرار میگیرد و در ارزیابی Calibration اهمیت دارد.
بنابراین اگر هدف پروژه فقط پیشبینی Label نیست و احتمال پیشبینیشده نیز در تصمیمگیری استفاده میشود، بررسی Calibration اهمیت زیادی پیدا میکند.
Threshold در Logistic Regression چیست؟
یکی از ویژگیهای مهم Logistic Regression این است که مدل الزاماً به یک Threshold ثابت مانند 0.5 محدود نیست.
فرض کنید مدل احتمال زیر را تولید کند:
اگر Threshold برابر 0.5 باشد، چون 0.7 > 0.5، کلاس 1 انتخاب میشود. اما اگر Threshold را به 0.8 تغییر دهیم، چون 0.7 < 0.8، نمونه در کلاس 0 قرار میگیرد.
بنابراین Threshold میتواند بر Precision، Recall و سایر معیارهای ارزیابی تأثیر بگذارد. در کاربردهایی مانند تشخیص بیماری یا کشف تقلب، ممکن است انتخاب Threshold مناسب از استفاده از مقدار پیشفرض 0.5 مهمتر باشد.
Logistic Regression برای چه نوع دادهای مناسب است؟
Logistic Regression میتواند با انواع مختلفی از ویژگیها کار کند، اما آمادهسازی صحیح داده اهمیت زیادی دارد. ویژگیها میتوانند شامل موارد زیر باشند:
- متغیرهای عددی
- متغیرهای دودویی
- متغیرهای دستهای پس از Encoding
- ویژگیهای حاصل از مهندسی ویژگی
- دادههای با تعداد ویژگی زیاد
در دادههای دستهای، معمولاً لازم است قبل از آموزش مدل، متغیرهای Categorical به شکل عددی مناسب تبدیل شوند.
همچنین در برخی شرایط، مقیاسبندی ویژگیها میتواند برای بهبود رفتار بهینهسازی مفید باشد؛ بهخصوص برای solverهایی مانند sag و saga.
آیا Logistic Regression به نرمال بودن دادهها نیاز دارد؟
یکی از سوءبرداشتهای رایج این است که Logistic Regression حتماً به نرمال بودن ویژگیهای ورودی نیاز دارد. خیر؛ نرمال بودن تکتک ویژگیهای ورودی یک پیشفرض الزامی برای Logistic Regression نیست.
با این حال، موضوعاتی مانند شکل رابطه بین ویژگیها و Log-Odds، همخطی بین ویژگیها، دادههای پرت، مقیاس ویژگیها و کیفیت داده میتوانند روی عملکرد و تفسیر مدل تأثیر بگذارند.
بنابراین بهتر است پیشپردازش داده بر اساس ماهیت مسئله انجام شود، نه صرفاً با فرض اینکه همه ویژگیها باید نرمال باشند.
کاربردهای Logistic Regression
رگرسیون لجستیک در حوزههای مختلفی استفاده میشود.
تشخیص پزشکی
- احتمال وجود یک بیماری
- ریسک یک وضعیت پزشکی
- طبقهبندی بیماران
بازاریابی
- پیشبینی خرید یا عدم خرید
- پاسخ به کمپین
- ریزش مشتری
بانک و مالی
- ارزیابی ریسک اعتباری
- احتمال نکول وام
- شناسایی تراکنشهای مشکوک
تشخیص Spam
برای تعیین اینکه یک ایمیل Spam یا Not Spam است.
منابع انسانی
- احتمال ترک سازمان
- پاسخ به یک پیشنهاد شغلی
- طبقهبندی برخی نتایج استخدامی
البته استفاده از مدل در چنین حوزههایی نیازمند توجه جدی به کیفیت داده، سوگیری و تفسیر درست نتایج است.
مزایای Logistic Regression چیست؟
- ساده و قابل فهم است: ساختار مدل نسبتاً ساده است و درک رفتار آن آسانتر است.
- سرعت آموزش مناسب دارد: در بسیاری از مسائل، Logistic Regression میتواند با سرعت خوبی آموزش داده شود.
- قابلیت تفسیر مناسب: ضرایب مدل میتوانند اطلاعات مفیدی درباره جهت و شدت ارتباط ویژگیها با Log-Odds ارائه کنند.
- خروجی احتمالی تولید میکند: مدل فقط یک برچسب نهایی ارائه نمیدهد و میتواند احتمال کلاس را نیز در اختیار قرار دهد.
- Baseline بسیار خوبی است: در بسیاری از پروژههای Classification، Logistic Regression میتواند به عنوان یک Baseline Model استفاده شود.
- امکان استفاده از Regularization: Regularization میتواند به کنترل پیچیدگی مدل و بهبود تعمیم کمک کند.
- قابلیت استفاده در دادههای بزرگ: Logistic Regression ذاتاً محدود به مجموعهدادههای کوچک نیست و برای دادههای بسیار بزرگ میتوان از solverهای مبتنی بر Stochastic Gradient Descent استفاده کرد.
محدودیتهای Logistic Regression چیست؟
- روابط پیچیده را بهصورت مستقیم مدل نمیکند: مدل پایه یک رابطه خطی در فضای ویژگیها ایجاد میکند.
- به ویژگیهای مناسب وابسته است: مهندسی ویژگی مناسب میتواند تأثیر زیادی بر عملکرد Logistic Regression داشته باشد.
- به Multicollinearity حساس است: وجود همبستگی شدید بین ویژگیها میتواند تفسیر ضرایب را دشوار کند.
- نقاط پرت و مشاهدات تأثیرگذار میتوانند مشکلساز شوند: نمونههای بسیار تأثیرگذار ممکن است ضرایب مدل را تغییر دهند.
- Perfect Separation میتواند آموزش را دچار مشکل کند: در صورت جداسازی کامل کلاسها، برآورد بدون Regularization ممکن است به ضرایب نامتناهی و مشکل همگرایی منجر شود.
- در دادههای نامتوازن ممکن است عملکرد ظاهری گمراهکننده باشد: در Class Imbalance، معیارهایی مانند Accuracy یا حتی ROC-AUC به تنهایی ممکن است تصویر کاملی از عملکرد مدل ارائه نکنند.
Logistic Regression و Linear Regression چه تفاوتی دارند؟
یکی از مهمترین موضوعات هنگام یادگیری Logistic Regression، تفاوت آن با Linear Regression است.
| ویژگی | Linear Regression | Logistic Regression |
|---|---|---|
| هدف اصلی | پیشبینی مقدار پیوسته | Classification |
| خروجی | مقدار عددی | احتمال و کلاس |
| تابع اصلی | رابطه خطی | رابطه خطی + Sigmoid |
| خروجی محدود به 0 و 1 | خیر | احتمال بین 0 و 1 |
| کاربرد نمونه | پیشبینی قیمت | تشخیص Spam |
| تابع Loss رایج | MSE | Log Loss / Cross-Entropy |
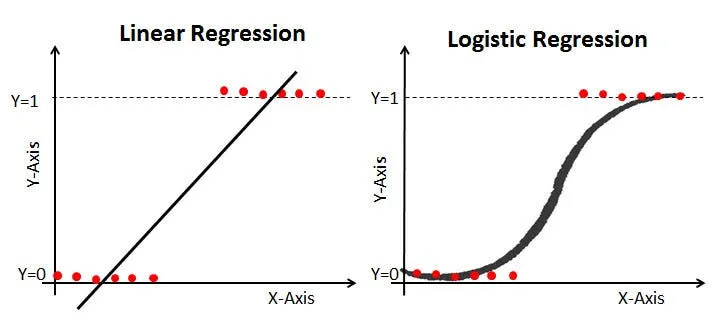
برای مثال:
بنابراین این دو مدل با وجود شباهت در بخش خطی، هدف و ساختار خروجی متفاوتی دارند.
Logistic Regression در برابر Decision Tree
هر دو الگوریتم میتوانند برای Classification استفاده شوند، اما رویکرد متفاوتی دارند. Logistic Regression یک رابطه خطی را در فضای ویژگیها مدل میکند، در حالی که Decision Tree داده را با مجموعهای از قواعد و تقسیمها تفکیک میکند.
اگر رابطه بین ویژگیها و کلاس نسبتاً ساده و قابل توضیح باشد، Logistic Regression میتواند انتخاب مناسبی باشد. اما اگر ساختار داده پیچیدهتر و غیرخطی باشد، Decision Tree و مدلهای مبتنی بر آن ممکن است عملکرد بهتری داشته باشند.
Logistic Regression در برابر Random Forest
Random Forest از مجموعهای از درختهای تصمیم استفاده میکند، در حالی که Logistic Regression یک مدل خطی است. به طور کلی:
- Logistic Regression → سادهتر و قابلتفسیرتر
- Random Forest → توانایی بیشتر در مدلسازی روابط غیرخطی
- Logistic Regression → معمولاً سبکتر
- Random Forest → میتواند روابط و تعاملات پیچیدهتری را یاد بگیرد
بنابراین انتخاب مدل باید بر اساس ماهیت داده و هدف پروژه انجام شود، نه صرفاً بر اساس پیچیدهتر بودن الگوریتم.
آیا Logistic Regression یک مدل خطی است؟
بله. نکته مهم این است که رابطه مدل با ویژگیها در فضای Log-Odds خطی است. در رابطه:
سمت راست یک ترکیب خطی از ویژگیهاست. بنابراین Logistic Regression در خانواده Linear Models قرار میگیرد، حتی اگر خروجی نهایی آن از طریق تابع Sigmoid به احتمال تبدیل شود.
اشتباه رایج: Logistic Regression یک الگوریتم Classification است
نکته مهم این است که Logistic Regression با وجود داشتن کلمه Regression، معمولاً برای Classification استفاده میشود و نباید آن را با Linear Regression یکی دانست. همچنین فرض نرمال بودن ویژگیهای ورودی، پیشفرض الزامی این مدل نیست.
چه زمانی استفاده از Logistic Regression انتخاب مناسبی است؟
- مسئله شما Classification باشد.
- به یک مدل نسبتاً ساده نیاز داشته باشید.
- تفسیرپذیری اهمیت داشته باشد.
- رابطه بین ویژگیها و Log-Odds تقریباً قابل مدلسازی به شکل خطی باشد.
- خروجی احتمالی برای شما ارزشمند باشد.
- به یک Baseline برای مقایسه با مدلهای پیچیدهتر نیاز داشته باشید.
نکته مهم این است که بزرگ بودن داده به خودی خود دلیلی برای کنار گذاشتن Logistic Regression نیست. برای دادههای بسیار بزرگ میتوان از روشهای مبتنی بر SGD یا سایر روشهای مقیاسپذیر استفاده کرد؛ با این حال، در برخی پروژهها مدلها یا معماریهای توزیعشده ممکن است مناسبتر باشند.
چه زمانی Logistic Regression انتخاب مناسبی نیست؟
اگر مسئله شما دارای روابط بسیار پیچیده و غیرخطی باشد، Logistic Regression پایه ممکن است نتواند ساختار داده را به خوبی یاد بگیرد. همچنین اگر:
- مرزهای تصمیم پیچیده باشند،
- تعاملات زیادی بین ویژگیها وجود داشته باشد،
- داده ساختار بسیار غیرخطی داشته باشد،
ممکن است مدلهایی مانند Decision Tree، Random Forest، Gradient Boosting یا شبکههای عصبی گزینههای مناسبتری باشند. البته میتوان با مهندسی ویژگی، Polynomial Features یا روشهای دیگر ظرفیت Logistic Regression را افزایش داد.
آیا Logistic Regression همیشه «احتمال واقعی» تولید میکند؟
خروجی Logistic Regression را میتوان به عنوان احتمال مدل تفسیر کرد، اما این به معنای آن نیست که این احتمال همیشه با احتمال واقعی در دنیای واقعی کاملاً منطبق است.
برای مثال P(y=1)=0.8 یعنی مدل احتمال 80 درصدی را برآورد کرده است. برای ارزیابی کیفیت این احتمالات، موضوع Probability Calibration اهمیت پیدا میکند.
معیارهایی مانند Brier Score و Log Loss و ابزارهایی مانند Calibration Curve میتوانند در این زمینه مورد استفاده قرار گیرند. اگر Calibration مدل مناسب نباشد، روشهایی مانند Platt Scaling و Isotonic Regression میتوانند برای اصلاح احتمالات پیشبینیشده استفاده شوند.
پیادهسازی Logistic Regression در Python
یکی از رایجترین ابزارها برای پیادهسازی Logistic Regression در Python، کتابخانه scikit-learn است.
from sklearn.linear_model import LogisticRegression
model = LogisticRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
y_prob = model.predict_proba(X_test)
در اینجا:
fit()مدل را آموزش میدهد.predict()کلاس پیشبینیشده را تولید میکند.predict_proba()احتمال تعلق نمونه به کلاسها را برمیگرداند.
در پروژههای نامتوازن نیز میتوان مثلاً از:
model = LogisticRegression(class_weight="balanced")
استفاده کرد. البته انتخاب class_weight باید بر اساس مسئله و معیار ارزیابی انجام شود و جایگزین بررسی دقیق داده و Threshold مناسب نیست.
آیا Logistic Regression برای دادههای چندکلاسه مناسب است؟
بله. اگر مسئله بیش از دو کلاس داشته باشد، میتوان از روشهایی مانند One-vs-Rest، Multinomial Logistic Regression و Softmax Regression استفاده کرد. اگر کلاسها دارای ترتیب ذاتی باشند، Ordinal Logistic Regression نیز گزینهای متفاوت و تخصصیتر است.
بنابراین قبل از انتخاب روش، باید مشخص شود که کلاسها فقط متفاوتاند یا ترتیب معناداری نیز دارند.
مراحل استفاده از Logistic Regression در یک پروژه واقعی
- تعریف مسئله: ابتدا باید مشخص کنیم چه چیزی قرار است پیشبینی شود.
- بررسی داده: ویژگیها، Label، دادههای گمشده، دادههای پرت، عدم توازن کلاسها و ساختار متغیرها بررسی میشوند.
- آمادهسازی داده: در صورت نیاز، Missing Value Handling، Encoding، Scaling و Feature Engineering انجام میشود.
- بررسی مفروضات: مواردی مانند Multicollinearity، Independence، Linearity in Log-Odds، Influential Observations و Perfect Separation بررسی میشوند.
- تقسیم داده: داده به مجموعههایی مانند Training، Validation و Test تقسیم میشود. در دادههای نامتوازن بهتر است تقسیمبندی به شکل Stratified انجام شود.
- آموزش مدل: Logistic Regression روی داده آموزشی Fit میشود.
- تنظیم Hyperparameterها: پارامترهایی مانند C، penalty و solver میتوانند تنظیم شوند.
- ارزیابی: مدل با معیارهایی مانند Accuracy، Precision، Recall، F1، PR-AUC، ROC-AUC، Balanced Accuracy، MCC، Log Loss و Brier Score ارزیابی میشود.
- بررسی Threshold: در صورت نیاز Threshold مناسب بر اساس هدف کسبوکار یا هزینه خطاها انتخاب میشود.
- بررسی Calibration: اگر احتمالهای مدل اهمیت داشته باشند، Calibration Curve و Brier Score بررسی میشوند.
- تفسیر مدل: ضرایب و Odds Ratioها بررسی میشوند و در مورد متغیرهای دستهای، Reference Category نیز در نظر گرفته میشود.
- ارزیابی نهایی: در نهایت عملکرد مدل روی دادهای که در فرآیند آموزش استفاده نشده است بررسی میشود.
سوالات متداول درباره Logistic Regression
Logistic Regression چیست و چه تفاوتی با Linear Regression دارد؟
چرا به آن Logistic Regression میگویند در حالی که برای Classification استفاده میشود؟
تابع Sigmoid چه نقشی در Logistic Regression دارد؟
Odds و Log-Odds در Logistic Regression چه معنایی دارند؟
Odds Ratio چیست و چگونه تفسیر میشود؟
Perfect Separation چیست و چرا مشکل ایجاد میکند؟
Class Imbalance چیست و چگونه مدیریت میشود؟
Regularization در Logistic Regression چه کاربردی دارد؟
آیا Logistic Regression به نرمال بودن دادهها نیاز دارد؟
Calibration در Logistic Regression چیست و چرا مهم است؟
چگونه Calibration مدل را بهبود دهیم؟
آیا Logistic Regression فقط برای دو کلاس مناسب است؟
چه زمانی Logistic Regression انتخاب مناسبی نیست؟
جمعبندی
Logistic Regression یکی از الگوریتمهای پایه اما بسیار مهم در یادگیری ماشین است که عمدتاً برای مسائل Classification استفاده میشود.
این مدل ابتدا یک ترکیب خطی از ویژگیها ایجاد میکند و سپس با استفاده از تابع Sigmoid آن را به یک مقدار بین صفر و یک تبدیل میکند. این مقدار میتواند به عنوان احتمال کلاس مورد نظر تفسیر شود و سپس با استفاده از یک Threshold، تصمیم نهایی گرفته شود.
از مفاهیم مهم مرتبط با Logistic Regression میتوان به Sigmoid Function، Probability، Decision Boundary، Odds، Log-Odds، Coefficients، Odds Ratio، Log Loss، Maximum Likelihood Estimation، Regularization، L1 و L2، Binary Classification، Multinomial / Softmax Regression، Ordinal Logistic Regression، One-vs-Rest، One-vs-One، Threshold، Class Imbalance، Precision و Recall، PR-AUC، ROC-AUC، Balanced Accuracy، MCC، Brier Score، Calibration Curve، Platt Scaling و Isotonic Regression اشاره کرد.
همچنین هنگام استفاده از Logistic Regression نباید فقط به Accuracy یا عملکرد مدل روی داده آموزشی توجه کرد. بررسی خطی بودن رابطه با Log-Odds، استقلال مشاهدات، Multicollinearity، نقاط پرت تأثیرگذار، حجم نمونه و Perfect Separation میتواند برای ساخت یک مدل قابل اعتماد ضروری باشد.
در دادههای نامتوازن نیز استفاده از روشهایی مانند class_weight='balanced' یا Resampling و انتخاب معیارهایی مانند F1، PR-AUC، Balanced Accuracy و MCC اهمیت پیدا میکند.
از طرف دیگر، اگر احتمالهای خروجی مدل مستقیماً در تصمیمگیری استفاده شوند، موضوع Calibration نیز باید بررسی شود. ابزارهایی مانند Calibration Curve و Brier Score و روشهایی مانند Platt Scaling و Isotonic Regression میتوانند در این زمینه مفید باشند.
یکی از مهمترین مزیتهای Logistic Regression، سادگی، سرعت و تفسیرپذیری مناسب آن است. از طرف دیگر، چون مدل پایه یک رابطه خطی در فضای Log-Odds ایجاد میکند، در مسائل دارای روابط بسیار پیچیده و غیرخطی ممکن است نسبت به مدلهای پیچیدهتر عملکرد ضعیفتری داشته باشد.
بنابراین، Logistic Regression را میتوان هم به عنوان یک مدل نهایی برای مسائل مناسب و هم به عنوان یک Baseline قدرتمند برای مقایسه با مدلهای پیچیدهتر در نظر گرفت.
اگر در مورد Logistic Regression، رگرسیون لجستیک یا معیارهای ارزیابی Classification سؤالی دارید یا تجربهای در این زمینه دارید، آن را در کامنت بنویسید. کدام بخش برایتان چالشبرانگیزتر بود؟