Feature در ماشین لرنینگ چیست؟ آشنایی با انواع ویژگی و کاربرد آنها
Feature در ماشین لرنینگ چیست؟ آشنایی با انواع ویژگی و کاربرد آنها
Feature در ماشین لرنینگ چیست؟ آشنایی با انواع ویژگی و Feature Engineering
در یادگیری ماشین، مدلها مستقیماً از مفاهیم انسانی مانند «سن»، «درآمد»، «شهر» یا «سابقه خرید» استفاده نمیکنند؛ بلکه این اطلاعات باید به شکلی ساختاریافته به مدل ارائه شوند. به هر متغیری که بهعنوان ورودی برای یادگیری و پیشبینی در اختیار مدل قرار میگیرد، Feature یا «ویژگی» گفته میشود.
Feature یکی از بنیادیترین مفاهیم در یادگیری ماشین است، زیرا کیفیت، نوع و نحوه نمایش ویژگیها میتواند مستقیماً بر عملکرد مدل تأثیر بگذارد. حتی یک الگوریتم قدرتمند نیز اگر با ویژگیهای نامناسب، ناقص یا دارای اطلاعات نشتکرده آموزش داده شود، الزاماً مدل خوبی ایجاد نمیکند.
در این مقاله از رهیارا، مفهوم Feature را از پایه بررسی میکنیم و با انواع ویژگیها، Feature Vector، Feature Engineering، Feature Selection، Feature Extraction، Feature Scaling و خطاهای رایج در استفاده از ویژگیها آشنا میشویم.
در این مقاله چه چیزهایی یاد میگیرید؟
-
Feature یا ویژگی در یادگیری ماشین چیست؟ -
تفاوت Feature با Label و Target چیست؟ -
انواع Feature در یادگیری ماشین کداماند؟ -
Feature Engineering چیست و چه تفاوتی با Feature Selection دارد؟
فهرست مطالب
- Feature در یادگیری ماشین چیست؟
- یک مثال ساده برای درک Feature
- تفاوت Feature، Label و Target
- Feature Vector چیست؟
- انواع Feature در یادگیری ماشین
- Feature Engineering چیست؟
- Feature Selection چیست؟
- Feature Extraction چیست؟
- تفاوت Feature Selection و Feature Extraction
- Feature Scaling و اهمیت آن
- Feature Interaction چیست؟
- Feature Leakage چیست؟
- یک Feature خوب چه ویژگیهایی دارد؟
- اهمیت Featureها چگونه بررسی میشود؟
- Feature در مدلهای مختلف یادگیری ماشین
- یک مثال کامل از Featureها در یک مسئله واقعی
- اشتباهات رایج در انتخاب و ساخت Feature
- سؤالات متداول
- جمعبندی
Feature در یادگیری ماشین چیست؟
Feature یا ویژگی، یک متغیر ورودی است که اطلاعاتی درباره هر نمونه از داده در اختیار مدل یادگیری ماشین قرار میدهد.
برای مثال، فرض کنید میخواهیم قیمت یک خانه را پیشبینی کنیم. اطلاعاتی مانند موارد زیر میتوانند Feature باشند:
- متراژ خانه
- تعداد اتاقها
- سن ساختمان
- فاصله تا مرکز شهر
- تعداد پارکینگ
- محله
در این مسئله، هرکدام از این متغیرها اطلاعاتی درباره خانه ارائه میکنند که مدل میتواند از آنها برای پیشبینی قیمت استفاده کند.
در منابع یادگیری ماشین، Feature معمولاً بهعنوان یک متغیر ورودی مدل تعریف میشود؛ یک نمونه میتواند از یک یا چند Feature تشکیل شده باشد.
البته Feature الزاماً همان چیزی نیست که در فایل خام داده مشاهده میکنیم. ممکن است یک ستون خام پس از تبدیل، کدگذاری یا ترکیب با ویژگیهای دیگر به یک Feature مناسب برای مدل تبدیل شود.
اگر تازه با یادگیری ماشین آشنا شدهاید و میخواهید ابتدا تصویر کلی این حوزه را بشناسید، پیشنهاد میکنیم مقاله زیر را مطالعه کنید:
یک مثال ساده برای درک Feature
فرض کنید دادههای مربوط به چند دانشجو را داریم:
| سن | معدل | تعداد ساعات مطالعه | وضعیت قبولی |
|---|---|---|---|
| 20 | 17.5 | 4 | قبول |
| 22 | 15.8 | 2 | قبول |
| 19 | 11.2 | 1 | مردود |
| 24 | 18.1 | 5 | قبول |
در این جدول:
- سن یک Feature است.
- معدل یک Feature است.
- تعداد ساعات مطالعه یک Feature است.
- وضعیت قبولی در صورتی که هدف پیشبینی باشد، Label یا Target است.
بنابراین اگر هدف مدل پیشبینی قبولی دانشجو باشد، مدل میتواند از سه Feature اول برای پیشبینی ستون آخر استفاده کند.
نکته مهم این است که یک ستون فقط به دلیل اینکه در جدول داده وجود دارد، الزاماً Feature مدل نیست. اینکه یک متغیر بهعنوان Feature استفاده شود به هدف مسئله، زمان پیشبینی و طراحی مدل بستگی دارد.
تفاوت Feature، Label و Target
یکی از اشتباهات رایج در شروع یادگیری ماشین، یکسان در نظر گرفتن Feature و Label است.
Feature
Feature ورودی مدل است. مثلاً برای پیشبینی قیمت خانه:
- متراژ
- تعداد اتاق
- سن ساختمان
- منطقه
میتوانند Feature باشند.
Label
Label پاسخ یا خروجی واقعی مربوط به نمونههای آموزشی است؛ اصطلاح Label بیشتر در مسائل یادگیری نظارتشده استفاده میشود.
Target
Target نیز به متغیر هدفی گفته میشود که مدل قصد پیشبینی آن را دارد.
برای مثال، اگر هدف پیشبینی قیمت خانه باشد:
Target → قیمت خانه
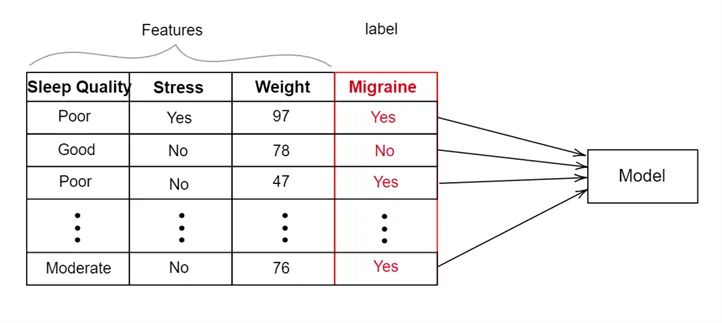
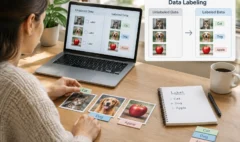
در این تصویر لیبل و فیچر در یک مجموعه داده مشخص شدهاند. Featureها بهعنوان متغیرهای ورودی (اطلاعات توصیفکننده هر نمونه) و Label بهعنوان متغیر هدف یا خروجی مدل در نظر گرفته میشود.
در یک مسئله طبقهبندی نیز ممکن است Featureها شامل سن، درآمد و سابقه خرید باشند و Target مشخص کند که آیا مشتری محصول را خریداری کرده است یا خیر.
Feature Vector چیست؟
مدلهای یادگیری ماشین معمولاً داده را به شکل یک Feature Vector دریافت میکنند.
Feature Vector مجموعهای از مقادیر مربوط به Featureهای یک نمونه است.
فرض کنید سه Feature داریم:
- سن
- درآمد
- تعداد خرید
برای یک مشتری ممکن است Feature Vector به شکل زیر باشد:
یعنی این نمونه:
- 32 سال سن دارد،
- درآمد او 45000 واحد پولی است،
- 12 خرید داشته است.
در عمل، Feature Vector همیشه شامل مقادیر خام نیست. دادههای خام ممکن است ابتدا به شکل عددی مناسب تبدیل شوند. برای مثال، یک ویژگی متنی یا دستهای باید به نمایش عددی تبدیل شود تا مدل بتواند از آن استفاده کند.
بنابراین میتوان مسیر کلی را به این شکل در نظر گرفت:
انواع Feature در یادگیری ماشین
Featureها را میتوان از جنبههای مختلف دستهبندی کرد. یکی از کاربردیترین دستهبندیها بر اساس نوع داده است.
مهمترین انواع Feature عبارتاند از:
- Feature عددی
- Feature دستهای
- Feature دودویی
- Feature ترتیبی
- Feature متنی
- Feature زمانی و تاریخی
- Featureهای مشتقشده
شناخت نوع Feature اهمیت زیادی دارد، زیرا روش آمادهسازی هر نوع داده متفاوت است.
Feature عددی چیست؟
Feature عددی مقداری عددی دارد و معمولاً به دو گروه اصلی تقسیم میشود.
ویژگی عددی گسسته
مقادیر قابل شمارش دارد. مثلاً:
- تعداد فرزندان
- تعداد خریدها
- تعداد اتاقها
- تعداد مراجعهها
ویژگی عددی پیوسته
میتواند در یک بازه مقادیر بسیار زیادی داشته باشد. مثلاً:
- وزن
- قد
- دما
- درآمد
- قیمت
- زمان
برای نمونه، «تعداد اتاق» معمولاً یک مقدار گسسته است، درحالیکه «متراژ خانه» میتواند یک مقدار پیوسته باشد. این تفاوت در برخی روشهای پیشپردازش و تحلیل داده اهمیت دارد.
Feature دستهای چیست؟
Feature دستهای یا Categorical Feature ویژگیای است که مقدار آن نشاندهنده یک دسته یا گروه مشخص است. مثلاً:
- جنسیت
- شهر
- نوع خودرو
- روش پرداخت
- نوع قرارداد
فرض کنید Feature مربوط به روش پرداخت شامل این مقادیر باشد:
- نقدی
- کارت بانکی
- آنلاین
مدل بسیاری از اوقات نمیتواند این مقادیر متنی را مستقیماً مانند یک عدد معمولی پردازش کند. بنابراین باید آنها را به نمایش عددی مناسب تبدیل کرد.
یکی از روشهای رایج، One-Hot Encoding است. برای مثال:
| روش پرداخت | نقدی | کارت | آنلاین |
|---|---|---|---|
| نقدی | 1 | 0 | 0 |
| کارت | 0 | 1 | 0 |
| آنلاین | 0 | 0 | 1 |
انتخاب روش مناسب برای تبدیل Featureهای دستهای به نوع مدل و ساختار داده بستگی دارد. روشهایی مانند One-Hot Encoding، Feature Hashing و Mean Encoding از روشهای مورد استفاده برای نمایش دادههای دستهای هستند.
Feature دودویی و ترتیبی چیست؟
Feature دودویی
Feature دودویی یا Binary Feature فقط دو حالت دارد. مثلاً:
- بله / خیر
- فعال / غیرفعال
- قبول / مردود
- خرید / عدم خرید
این نوع Feature معمولاً میتواند با مقادیر 0 و 1 نمایش داده شود.
Feature ترتیبی
در Feature ترتیبی یا Ordinal Feature، دستهها دارای ترتیب مشخص هستند. مثلاً سطح رضایت:
- کم
- متوسط
- زیاد
در اینجا ترتیب وجود دارد، اما فاصله بین دستهها الزاماً عددی و یکسان نیست. بنابراین نباید بدون توجه به ماهیت داده، هر Feature دستهای را صرفاً به اعداد 1، 2 و 3 تبدیل کرد؛ زیرا ممکن است مدل تصور کند فاصله میان دستهها معنی عددی مشخصی دارد.
Feature Engineering چیست؟
Feature Engineering یا مهندسی ویژگی، فرایند ایجاد، تبدیل و آمادهسازی Featureها به شکلی است که اطلاعات مفیدتری برای یادگیری مدل فراهم کنند.
در Feature Engineering ممکن است:
- Featureهای جدید ایجاد شوند.
- Featureهای موجود تبدیل شوند.
- دادههای خام به نمایش مناسب تبدیل شوند.
- چند Feature با یکدیگر ترکیب شوند.
- دادههای عددی مقیاسبندی شوند.
- دادههای دستهای کدگذاری شوند.
Feature Engineering یعنی تبدیل داده خام به ویژگیهایی که برای یادگیری ماشین مناسبتر و مفیدتر هستند.
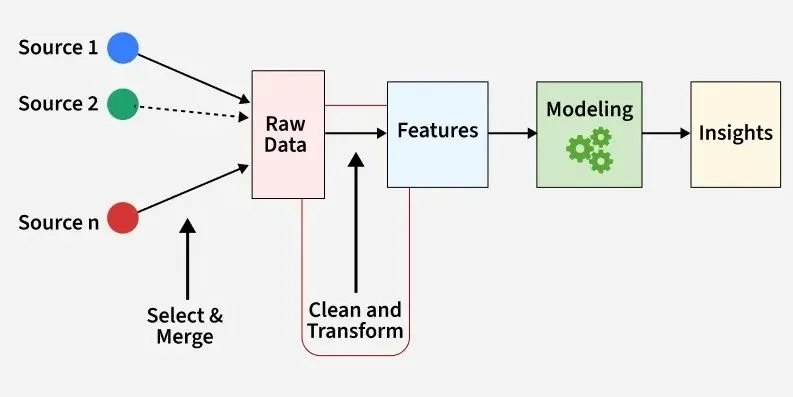
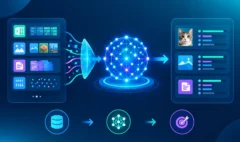
در این تصویر جایگاه Feature Engineering در فرایند کلی یادگیری ماشین نشان داده شده است؛ مرحلهای که در آن داده خام به ویژگیهای مناسب و مفید برای آموزش مدل تبدیل میشود.
برای مثال، اگر در یک دیتاست تاریخ خرید مشتری را داشته باشیم، میتوان از آن Featureهای جدیدی مانند:
- روز هفته
- ماه
- فصل
- فاصله از آخرین خرید
ایجاد کرد. در واقع، مدل به جای استفاده مستقیم از یک تاریخ خام، میتواند از اطلاعات استخراجشده از آن استفاده کند.
روشهای رایج Feature Engineering
Feature Engineering میتواند بسته به مسئله بسیار متفاوت باشد، اما چند روش کاربرد عمومی دارند.
تبدیل ویژگیهای عددی
گاهی یک ویژگی عددی خام مستقیماً برای مدل مناسب نیست و میتوان آن را تبدیل کرد. برای مثال:
- تبدیل مقیاس
- لگاریتمگیری
- تبدیل به بازههای مختلف
- تبدیل مقادیر به نسبت یا نرخ
ایجاد ویژگی نسبتها
گاهی نسبت دو متغیر اطلاعات بیشتری از خود آنها دارد. برای مثال، در تحلیل مالی:
ممکن است برای پیشبینی ریسک، اطلاعات مفیدتری نسبت به استفاده جداگانه از بدهی و درآمد ارائه دهد.
استخراج اطلاعات از تاریخ
از یک Feature مانند تاریخ میتوان ویژگیهای متعددی ایجاد کرد:
ترکیب ویژگیها
گاهی رابطه میان دو Feature اهمیت دارد. برای مثال:
در این حالت یک Feature جدید از ترکیب Featureهای قبلی ساخته شده است.
Binning
در روش Binning یک متغیر عددی به بازههایی تقسیم میشود. مثلاً سن:
- کمتر از 20
- 20 تا 30
- 30 تا 40
- بیشتر از 40
Binning یکی از روشهای شناختهشده برای تبدیل نمایش عددی Featureهاست.
Feature Selection چیست؟
Feature Selection یا انتخاب ویژگی یعنی انتخاب بخشی از Featureهای موجود و حذف ویژگیهایی که برای مدل ارزش کافی ندارند.
فرض کنید دیتاستی با 100 Feature داریم. ممکن است فقط 20 مورد از آنها واقعاً اطلاعات مفیدی برای مسئله موردنظر داشته باشند. در چنین شرایطی میتوان Featureهای کماهمیت یا نامرتبط را حذف کرد.
اهداف Feature Selection میتواند شامل موارد زیر باشد:
- کاهش پیچیدگی مدل
- کاهش حجم داده ورودی
- کاهش زمان آموزش
- حذف اطلاعات نامرتبط
- کاهش احتمال Overfitting
- بهبود تفسیرپذیری مدل
روشهای Feature Selection شامل روشهای آماری، روشهای مبتنی بر مدل و روشهای ترتیبی هستند. در کتابخانههایی مانند Scikit-learn نیز روشهایی مانند Sequential Feature Selection، RFE و SelectFromModel برای این هدف وجود دارند.
نکته مهم این است که Feature Selection با Feature Engineering یکی نیست. در Feature Engineering معمولاً به دنبال ساخت یا تبدیل ویژگیها هستیم، درحالیکه در Feature Selection بیشتر به دنبال انتخاب Featureهای موجود هستیم.
Feature Extraction چیست؟
Feature Extraction یا استخراج ویژگی به فرایندی گفته میشود که در آن از داده خام یا نمایش اولیه داده، ویژگیهای جدید و فشردهتری استخراج میکنیم.
برای مثال، فرض کنید یک تصویر تعداد بسیار زیادی پیکسل دارد. میتوان با استفاده از یک روش استخراج ویژگی، نمایش فشردهتری از اطلاعات تصویر ایجاد کرد.
در دادههای متنی نیز میتوان از متن خام، ویژگیهایی مانند موارد زیر استخراج کرد:
- تعداد کلمات
- فراوانی واژهها
- TF-IDF
- Embeddingها
در برخی کاربردها، Feature Extraction باعث میشود اطلاعات پیچیده داده به یک نمایش مناسبتر برای مدل تبدیل شود.
بنابراین:
تفاوت Feature Selection و Feature Extraction
این دو مفهوم شبیه به هم به نظر میرسند، اما یکسان نیستند.
| ویژگی | Feature Selection | Feature Extraction |
|---|---|---|
| هدف | انتخاب ویژگیهای موجود | ایجاد یا استخراج نمایشهای جدید |
| تغییرات | برخی Featureها حذف میشوند | ویژگیهای جدید ممکن است ساخته شوند |
| تعداد Featureها | تعداد Featureها کاهش پیدا میکند | داده به نمایش دیگری تبدیل میشود |
| تفسیر | تفسیر ویژگیها معمولاً سادهتر است | تفسیر Featureهای جدید ممکن است دشوارتر باشد |
| مثال | انتخاب 10 Feature از 50 Feature | تبدیل 50 متغیر به چند مؤلفه |
برای مثال، اگر 50 ستون داشته باشیم و 10 ستون مهم را نگه داریم، Feature Selection انجام دادهایم. اما اگر 50 ستون را به مجموعهای از مؤلفههای جدید تبدیل کنیم، وارد حوزه Feature Extraction شدهایم.
Feature Scaling و اهمیت آن
Featureهای عددی ممکن است مقیاسهای بسیار متفاوتی داشته باشند. مثلاً:
- سن: بین 18 تا 80
- درآمد: بین 10,000 تا 500,000
- تعداد خرید: بین 0 تا 100
در بعضی الگوریتمها این تفاوت مقیاس میتواند بر فرایند یادگیری اثر بگذارد. به همین دلیل از روشهایی مانند موارد زیر استفاده میشود:
- Standardization
- Min-Max Scaling
- Normalization
برای مثال در Standardization معمولاً مقدار هر Feature بر اساس میانگین و انحراف معیار آن تبدیل میشود. هدف این است که Featureها در مقیاس مناسبتری برای الگوریتم قرار بگیرند.
البته Scaling برای تمام الگوریتمها به یک اندازه ضروری نیست. برای مثال، برخی مدلهای مبتنی بر درخت تصمیم معمولاً مانند روشهای مبتنی بر فاصله به Scaling حساس نیستند. بنابراین Scaling باید بر اساس الگوریتم و ساختار مسئله انتخاب شود، نه اینکه بهصورت کورکورانه روی تمام Featureها اعمال شود.
Feature Interaction چیست؟
گاهی یک Feature بهتنهایی اطلاعات کاملی ارائه نمیکند و رابطه آن با Feature دیگری اهمیت دارد. به این رابطه Feature Interaction گفته میشود.
برای مثال، فرض کنید میخواهیم میزان فروش یک فروشگاه را پیشبینی کنیم. دو Feature داریم:
- قیمت
- میزان تخفیف
اثر تخفیف ممکن است به قیمت محصول وابسته باشد. بنابراین ترکیب یا تعامل این دو Feature میتواند اطلاعات بیشتری نسبت به بررسی مستقل آنها ارائه دهد.
یکی از شکلهای ایجاد تعامل میان ویژگیها، Feature Cross است. در این روش دو یا چند Feature ترکیب میشوند تا یک Feature جدید ایجاد شود. این روش بهویژه در برخی مدلهای خطی میتواند به مدل کمک کند روابط میان ویژگیها را بهتر یاد بگیرد.
البته ایجاد تعداد زیادی Feature Interaction میتواند تعداد ویژگیها را بهشدت افزایش دهد؛ بنابراین باید هدفمند انجام شود.
Feature Leakage چیست؟
یکی از مهمترین مشکلات مرتبط با Featureها، Feature Leakage یا نشت اطلاعات است.
Feature Leakage زمانی اتفاق میافتد که یک Feature اطلاعاتی را وارد مدل کند که در زمان واقعی پیشبینی در دسترس نیست یا مستقیماً یا غیرمستقیم اطلاعات Target را در خود دارد.
برای مثال فرض کنید هدف، پیشبینی اینکه آیا یک مشتری فردا خرید میکند یا خیر باشد. اگر Featureای داشته باشیم که تعداد خریدهای انجامشده در پایان فردا را نشان دهد، این Feature ممکن است ارتباط بسیار زیادی با Target داشته باشد؛ اما در زمان پیشبینی در دسترس نیست.
در نتیجه مدل ممکن است در ارزیابی عملکرد فوقالعادهای نشان دهد، اما در دنیای واقعی عملکرد ضعیفی داشته باشد.
در سیستمهای واقعی، هماهنگ بودن Featureهای زمان آموزش با Featureهای موجود هنگام استفاده از مدل اهمیت زیادی دارد؛ زیرا تفاوت میان این دو میتواند به مشکلاتی مانند Training-Serving Skew منجر شود.
یک Feature خوب چه ویژگیهایی دارد؟
یک Feature مناسب الزاماً Featureای نیست که فقط با Target همبستگی زیادی داشته باشد. یک Feature خوب معمولاً باید ویژگیهایی مانند موارد زیر داشته باشد:
مرتبط با مسئله باشد
Feature باید اطلاعاتی مرتبط با هدف پیشبینی ارائه دهد.
هنگام پیشبینی در دسترس باشد
نباید اطلاعات آینده یا اطلاعاتی که فقط بعد از وقوع Target مشخص میشود، وارد Featureها شود.
کیفیت داده مناسبی داشته باشد
Feature دارای خطا، مقدارهای غیرواقعی یا دادههای بسیار ناقص میتواند عملکرد مدل را کاهش دهد.
اطلاعات تکراری غیرضروری ایجاد نکند
وجود تعداد زیادی Feature بسیار مشابه ممکن است اطلاعات جدید چندانی به مدل اضافه نکند.
قابل نگهداری باشد
در پروژههای واقعی فقط دقت مدل مهم نیست. اگر جمعآوری یا محاسبه یک Feature بسیار پرهزینه باشد، باید ارزش آن در برابر هزینهاش بررسی شود. در سیستمهای تولیدی حتی توصیه میشود میزان فایده Feature در برابر هزینه نگهداری آن سنجیده شود.
اهمیت Featureها چگونه بررسی میشود؟
بعد از ساخت مدل، ممکن است بخواهیم بدانیم کدام Featureها نقش بیشتری در پیشبینی داشتهاند. این موضوع با مفهوم Feature Importance مرتبط است.
بسته به مدل، روشهای مختلفی برای بررسی اهمیت Featureها وجود دارد. برای مثال:
- Feature Importance در مدلهای درختی
- ضرایب مدلهای خطی
- Permutation Importance
- روشهای مبتنی بر SHAP
البته «اهمیت Feature» همیشه به معنی رابطه علت و معلولی نیست. اگر یک Feature اهمیت بالایی در مدل داشته باشد، نمیتوان صرفاً از این موضوع نتیجه گرفت که آن Feature علت ایجاد Target است. همچنین ممکن است دو Feature اطلاعات مشابهی داشته باشند و اهمیت میان آنها تقسیم شود. بنابراین تفسیر اهمیت Feature باید با توجه به نوع مدل و ساختار داده انجام شود.
Feature در مدلهای مختلف یادگیری ماشین
نحوه برخورد مدلها با Featureها یکسان نیست.
مدلهای خطی
در مدلهایی مانند Linear Regression و Logistic Regression، Featureها معمولاً به شکل ورودیهای عددی وارد مدل میشوند و ضرایب آنها میتوانند اطلاعاتی درباره رابطه مدل با Featureها ارائه دهند.
مدلهای درختی
مدلهایی مانند Decision Tree و Random Forest میتوانند روابط غیرخطی میان Featureها را یاد بگیرند و معمولاً به Scaling مانند مدلهای مبتنی بر فاصله وابسته نیستند.
مدلهای مبتنی بر فاصله
در الگوریتمهایی مانند K-Nearest Neighbors، مقیاس Featureها اهمیت بیشتری دارد؛ زیرا فاصله میان نمونهها تحت تأثیر مقیاس متغیرها قرار میگیرد.
شبکههای عصبی
در شبکههای عصبی نیز نحوه نمایش و مقیاس Featureها میتواند بر فرایند آموزش اثرگذار باشد. برای دادههای غیرعددی نیز معمولاً باید نمایش عددی مناسبی ایجاد شود.
یک مثال کامل از Featureها در یک مسئله واقعی
فرض کنید یک فروشگاه اینترنتی میخواهد پیشبینی کند که آیا یک مشتری در ماه آینده خرید خواهد کرد یا خیر. داده خام مشتری شامل اطلاعات زیر است:
| اطلاعات خام | نوع |
|---|---|
| سن | عددی |
| شهر | دستهای |
| تعداد خریدهای قبلی | عددی |
| مبلغ آخرین خرید | عددی |
| تاریخ آخرین خرید | تاریخی |
| نوع دستگاه | دستهای |
میتوان از این اطلاعات Featureهای مختلفی ایجاد کرد. مثلاً:
Featureهای اولیه:
- سن
- شهر
- تعداد خریدهای قبلی
- مبلغ آخرین خرید
- نوع دستگاه
Featureهای مهندسیشده:
- تعداد روز از آخرین خرید
- میانگین مبلغ خرید
- تعداد خرید در سه ماه اخیر
- ماه آخرین خرید
- نسبت خریدهای موبایلی به کل خریدها
در نهایت Target میتواند این باشد: آیا مشتری در ماه آینده خرید میکند؟
در این مثال، تاریخ خام الزاماً بهترین ورودی مدل نیست. تبدیل آن به ویژگیهایی مانند «تعداد روز از آخرین خرید» میتواند اطلاعاتی مستقیمتر و قابل استفادهتر ایجاد کند.
این مثال نشان میدهد که در یک پروژه واقعی، Feature فقط به معنی «ستون موجود در فایل Excel» نیست؛ بلکه میتواند نتیجه تبدیل و استخراج اطلاعات از دادههای خام باشد.
اشتباهات رایج در انتخاب و ساخت Feature
چند خطای رایج میتواند کیفیت مدل را بهشدت تحت تأثیر قرار دهد.
۱. استفاده از اطلاعات آینده
اگر Feature در زمان پیشبینی در دسترس نباشد، نباید بهعنوان ورودی مدل استفاده شود.
۲. استفاده از Featureهای نامرتبط
اضافه کردن تعداد زیادی Feature بدون بررسی ارتباط آنها با مسئله لزوماً مدل را بهتر نمیکند.
۳. تبدیل نادرست دادههای دستهای
تبدیل ساده دستهها به اعداد ممکن است برای برخی دادهها رابطه عددی مصنوعی ایجاد کند.
۴. Scaling اشتباه
Scaling باید با توجه به نوع الگوریتم و داده انجام شود.
۵. ایجاد Featureهای بسیار زیاد
Feature Engineering بیش از حد میتواند ابعاد داده را افزایش دهد و پیچیدگی مدل را بیشتر کند.
۶. انجام Feature Selection روی کل داده قبل از ارزیابی
اگر اطلاعات مجموعه آزمون وارد فرایند انتخاب Feature شود، ممکن است ارزیابی مدل دچار نشت اطلاعات شود.
۷. استفاده از Featureهایی که در محیط واقعی وجود ندارند
ممکن است یک Feature در دیتاست تاریخی وجود داشته باشد، اما هنگام استفاده واقعی از مدل قابل دریافت نباشد. چنین Featureای حتی اگر عملکرد مدل را در دادههای گذشته افزایش دهد، برای سیستم واقعی مناسب نیست.
به همین دلیل، مراحل آمادهسازی داده و Feature Selection باید به شکلی طراحی شوند که اطلاعات مجموعه آزمون وارد فرایند آموزش نشود. استفاده از Pipeline یکی از روشهای رایج برای منظمکردن این مراحل در پروژههای یادگیری ماشین است.
سؤالات متداول درباره Feature در ماشین لرنینگ
Feature در یادگیری ماشین چیست؟
آیا هر ستون در دیتاست یک Feature است؟
تفاوت Feature و Target چیست؟
Feature Engineering چیست؟
Feature Selection چیست؟
Feature Extraction چیست؟
آیا Featureهای بیشتر همیشه بهتر است؟
چرا Featureهای دستهای باید به عدد تبدیل شوند؟
آیا اهمیت بالای یک Feature به معنی رابطه علت و معلولی است؟
جمعبندی
Feature یکی از پایهایترین مفاهیم در یادگیری ماشین است. Featureها همان اطلاعات ورودی هستند که مدل از آنها برای یادگیری الگوها و تولید پیشبینی استفاده میکند.
اما استفاده از Feature فقط به انتخاب چند ستون از یک دیتاست محدود نمیشود. در یک پروژه واقعی ممکن است لازم باشد دادههای خام به Featureهای مناسب تبدیل شوند، Featureهای جدید ایجاد شوند، دادههای دستهای کدگذاری شوند، برخی Featureها مقیاسبندی شوند و Featureهای کمفایده حذف شوند.
در نهایت، هدف این نیست که بیشترین تعداد Feature را در اختیار مدل قرار دهیم؛ بلکه باید Featureهایی را انتخاب یا ایجاد کنیم که مرتبط، قابلدسترسی در زمان پیشبینی، باکیفیت و متناسب با مسئله و الگوریتم مورد استفاده باشند.
اگر در حال یادگیری یادگیری ماشین هستید، شناخت Featureها یکی از قدمهای مهم برای درک بهتر فرایند ساخت مدل است.
اگر در پروژههای یادگیری ماشین خود با چالش انتخاب یا ساخت Feature مواجه شدهاید، تجربهتان را در کامنت بنویسید. کدام Feature Engineering بیشترین تأثیر را روی بهبود مدل شما داشت؟