Linear Regression چیست؟ آموزش رگرسیون خطی، کاربردها و نحوه کار
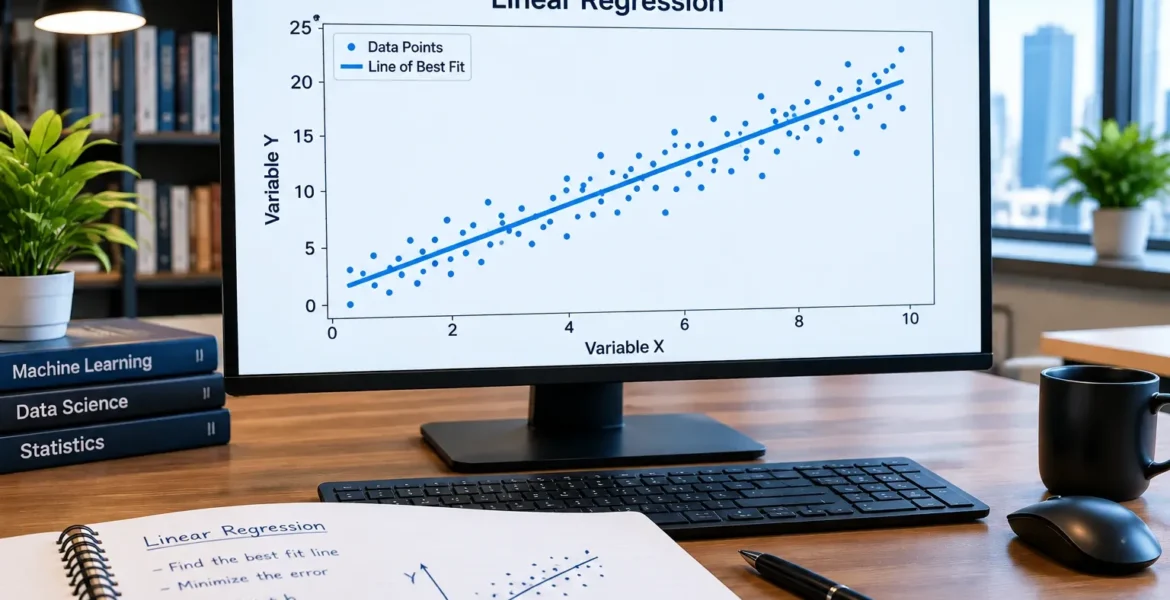
Linear Regression چیست؟ آموزش رگرسیون خطی، کاربردها و نحوه کار
Linear Regression چیست؟ راهنمای کامل رگرسیون خطی در یادگیری ماشین
Linear Regression یا رگرسیون خطی یکی از سادهترین و در عین حال مهمترین الگوریتمهای یادگیری ماشین برای پیشبینی یک مقدار عددی است. این الگوریتم تلاش میکند رابطه میان یک متغیر هدف و یک یا چند متغیر ورودی را با استفاده از یک رابطه خطی مدلسازی کند.
برای مثال، اگر اطلاعاتی مانند متراژ خانه، تعداد اتاقها، سن ساختمان و موقعیت مکانی را در اختیار داشته باشیم، میتوان از رگرسیون خطی برای پیشبینی قیمت خانه استفاده کرد.
رگرسیون خطی علاوه بر کاربرد مستقیم در مسائل پیشبینی، یکی از مفاهیم پایهای برای درک بسیاری از روشهای پیشرفتهتر در یادگیری ماشین و آمار است.
در این مقاله چه چیزهایی یاد میگیرید؟
-
Linear Regression چیست و چه مسئلهای را حل میکند؟ -
تفاوت Regression و Classification و کاربرد هرکدام -
رگرسیون خطی ساده و چندگانه و معادله آنها -
روش Least Squares، تابع هزینه و مفهوم Residual -
معیارهای ارزیابی MAE، MSE، RMSE و R² -
فرضهای مهم، Multicollinearity و پیادهسازی در Python
فهرست مطالب
- Linear Regression چیست؟
- چرا یک الگوریتم یادگیری ماشین است؟
- تفاوت Regression و Classification
- متغیر مستقل و متغیر وابسته
- رگرسیون خطی ساده و چندگانه
- مدل چگونه بهترین خط را پیدا میکند؟
- Least Squares و تابع هزینه
- ضرایب مدل و تفسیر آنها
- Residual یا باقیمانده چیست؟
- معیارهای ارزیابی رگرسیون خطی
- فرضهای مهم Linear Regression
- Multicollinearity چیست؟
- Regularization در رگرسیون خطی
- مزایا و محدودیتهای Linear Regression
- کاربردهای رگرسیون خطی
- مثال ساده و پیادهسازی در Python
- سوالات متداول
- جمعبندی
Linear Regression چیست؟
Linear Regression یا رگرسیون خطی یک الگوریتم یادگیری نظارتشده است که برای مدلسازی رابطه بین متغیرهای ورودی و یک متغیر هدف عددی استفاده میشود.
هدف مدل این است که بر اساس دادههای موجود، رابطهای میان ورودیها و خروجی پیدا کند و سپس از این رابطه برای پیشبینی مقادیر جدید استفاده شود.
فرض کنید اطلاعات مربوط به متراژ و قیمت تعدادی خانه را در اختیار داریم:
| متراژ | قیمت |
|---|---|
| 60 | 3 |
| 80 | 4 |
| 100 | 5 |
| 120 | 6 |
| 140 | 7 |
در این مثال، متراژ خانه یک Feature یا ویژگی ورودی و قیمت خانه Target یا متغیر هدف است.
رگرسیون خطی تلاش میکند رابطه میان این دو متغیر را به شکلی مانند یک خط نمایش دهد:
در این رابطه:
- β₀ مقدار عرض از مبدأ یا Intercept است.
- β₁ ضریب متغیر ورودی یا Coefficient است.
- متراژ متغیر ورودی است.
- قیمت متغیر هدف است.
مدل پس از یادگیری ضرایب، میتواند برای یک خانه جدید قیمت آن را تخمین بزند.
چرا Linear Regression یک الگوریتم یادگیری ماشین است؟
در رگرسیون خطی، مدل از دادههای موجود یاد میگیرد. در مرحله آموزش، دادههایی شامل ورودی و خروجی واقعی در اختیار مدل قرار میگیرد. مدل تلاش میکند ضرایبی را پیدا کند که باعث شوند پیشبینیهای آن تا حد امکان به مقادیر واقعی نزدیک باشند. به همین دلیل، Linear Regression در دسته Supervised Learning قرار میگیرد؛ زیرا در زمان آموزش، مقدار واقعی Target برای نمونههای آموزشی مشخص است.
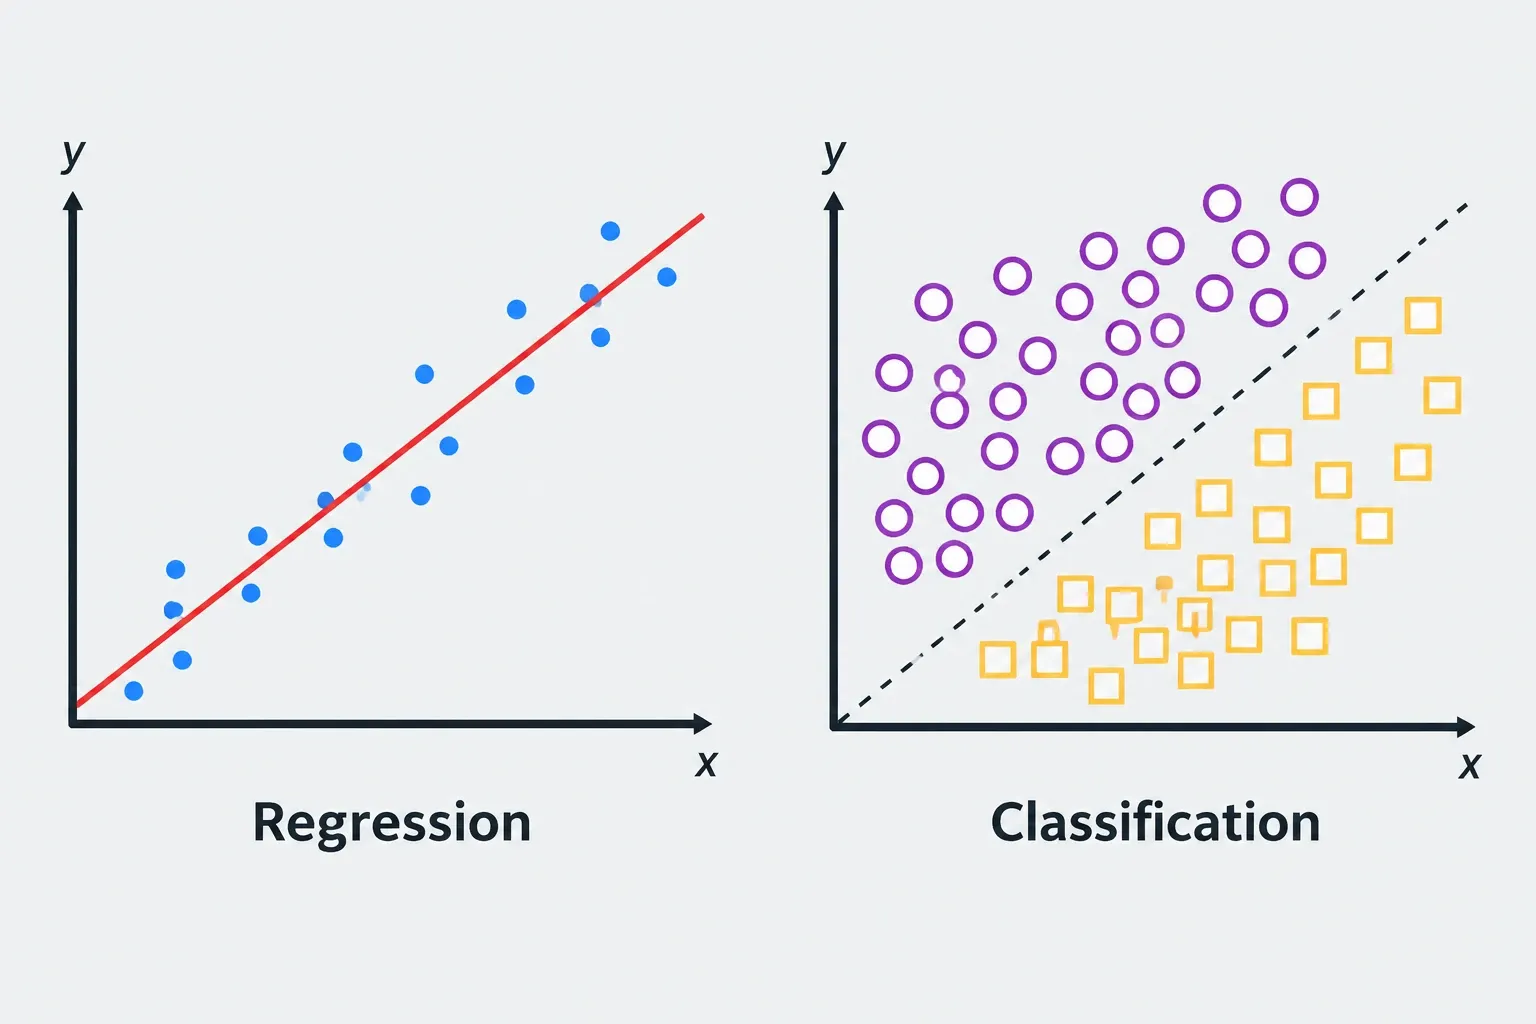
تفاوت Regression و Classification
در یادگیری ماشین، یکی از مهمترین تفاوتها به نوع خروجی مربوط میشود.
اگر هدف، پیشبینی یک مقدار عددی باشد، مسئله معمولاً در دسته مسائل Regression قرار میگیرد.
برای مثال:
- پیشبینی قیمت خانه
- پیشبینی میزان فروش
- پیشبینی مصرف برق
- پیشبینی درآمد
- پیشبینی دما
- پیشبینی میزان تقاضا
در مقابل، اگر هدف تعیین یک کلاس یا دسته باشد، با مسئله Classification مواجه هستیم.
برای مثال:
- تشخیص Spam یا غیر Spam
- تشخیص بیمار یا سالم
- تشخیص تقلبی یا واقعی
- تشخیص مشتری وفادار یا غیر وفادار
| ویژگی | Regression | Classification |
|---|---|---|
| نوع خروجی | عددی | دسته یا کلاس |
| مثال | قیمت خانه | گران/ارزان |
| مثال دیگر | میزان فروش | خرید/عدم خرید |
| هدف | پیشبینی مقدار | پیشبینی کلاس |
| نمونه الگوریتم | Linear Regression | Logistic Regression |
اشتباه رایج: Logistic Regression یک الگوریتم Classification است
نکته مهم این است که Logistic Regression با وجود داشتن کلمه Regression، معمولاً برای Classification استفاده میشود و نباید آن را با Linear Regression یکی دانست.
متغیر مستقل و متغیر وابسته چیست؟
برای درک رگرسیون خطی باید دو مفهوم را بشناسیم.
متغیر مستقل یا Independent Variable
متغیری است که از آن برای پیشبینی خروجی استفاده میکنیم.
برای مثال در پیشبینی قیمت خانه:
- متراژ
- تعداد اتاقها
- سن ساختمان
میتوانند متغیرهای مستقل باشند. در یادگیری ماشین معمولاً این متغیرها را با X نمایش میدهیم.
متغیر وابسته یا Dependent Variable
متغیری است که قصد داریم مقدار آن را پیشبینی کنیم. برای مثال: قیمت خانه متغیر وابسته یا Target است و معمولاً با y نمایش داده میشود.
یعنی مدل با استفاده از ویژگیهای X تلاش میکند مقدار y را پیشبینی کند.
رگرسیون خطی ساده و چندگانه
رگرسیون خطی ساده (Simple Linear Regression)
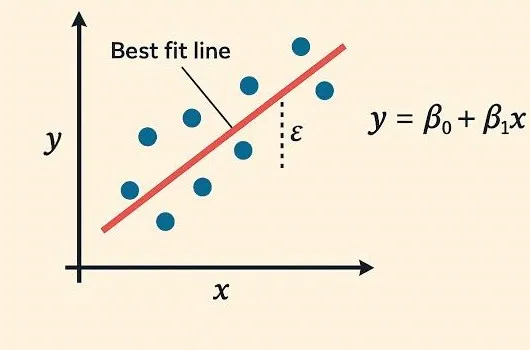
اگر مدل فقط یک متغیر ورودی داشته باشد، با Simple Linear Regression یا رگرسیون خطی ساده مواجه هستیم.
معادله آن به صورت زیر است:
در این رابطه:
- ŷ مقدار پیشبینیشده
- β₀ عرض از مبدأ
- β₁ ضریب متغیر X
- X متغیر ورودی
برای مثال: قیمت = 500 + 20 × متراژ
در این مدل، اگر متراژ افزایش پیدا کند، قیمت پیشبینیشده نیز بر اساس مقدار ضریب تغییر خواهد کرد.
رگرسیون خطی چندگانه (Multiple Linear Regression)
در مسائل واقعی معمولاً فقط یک ویژگی برای پیشبینی کافی نیست. برای مثال، قیمت خانه ممکن است به موارد مختلفی وابسته باشد:
- متراژ
- تعداد اتاقها
- سن ساختمان
- فاصله تا مرکز شهر
- تعداد پارکینگها
در این حالت از Multiple Linear Regression استفاده میشود. معادله کلی آن به صورت زیر است:
هر ضریب نشان میدهد که با تغییر یک ویژگی، مقدار پیشبینیشده Target، با در نظر گرفتن سایر متغیرهای مدل، چگونه تغییر میکند.
منظور از «خطی» در Linear Regression چیست؟
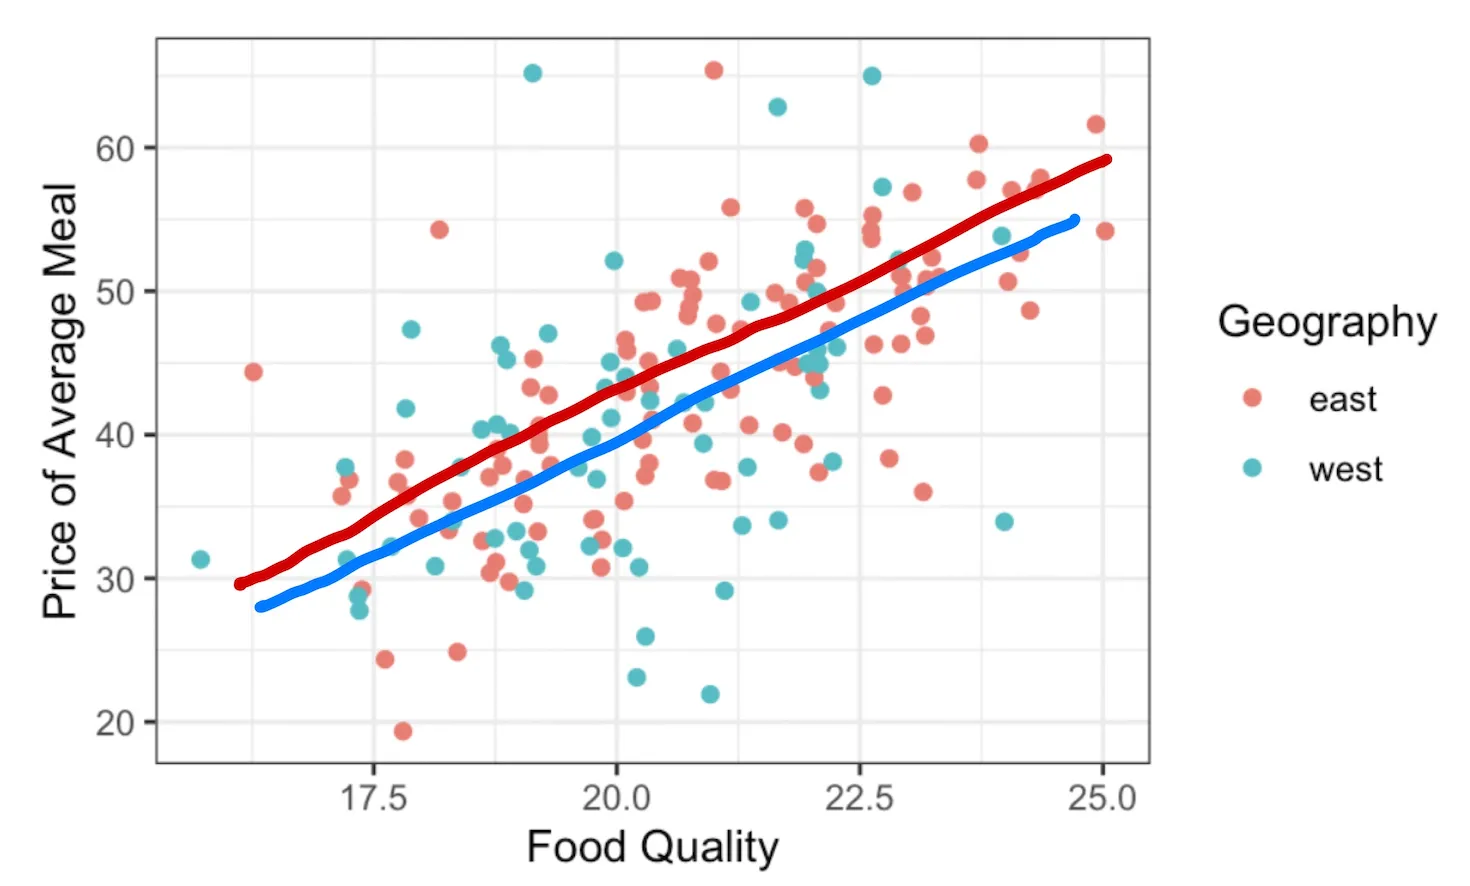
یکی از نکات مهم این است که Linear در Linear Regression به خطی بودن رابطه نسبت به پارامترهای مدل اشاره دارد.
در سادهترین حالت، اگر یک ویژگی داشته باشیم، مدل به شکل یک خط نمایش داده میشود. اما در حالت چندمتغیره، دیگر نمیتوان مدل را به صورت یک خط ساده در فضای دوبعدی نمایش داد؛ بلکه مدل یک Hyperplane در فضای ویژگیها ایجاد میکند.
Multiple Linear Regression → Hyperplane
مدل چگونه بهترین خط را پیدا میکند؟
فرض کنید نقاط داده روی نمودار قرار گرفتهاند. معمولاً هیچ خطی وجود ندارد که از تمام نقاط عبور کند. بنابراین مدل باید خطی را پیدا کند که تا حد امکان به نقاط واقعی نزدیک باشد.
برای این کار، اختلاف میان مقدار واقعی و مقدار پیشبینیشده بررسی میشود. این اختلاف را میتوان به صورت زیر نوشت:
که به آن باقیمانده یا Residual گفته میشود. مدل تلاش میکند مجموع خطاهای خود را تا حد امکان کاهش دهد.
روش Least Squares و تابع هزینه
روش Least Squares چیست؟
یکی از روشهای کلاسیک برای پیدا کردن ضرایب رگرسیون خطی، Ordinary Least Squares یا OLS است. در این روش، مربع خطاهای پیشبینی محاسبه و مجموع آنها کمینه میشود.
مدل ضرایب β را به گونهای انتخاب میکند که این مقدار حداقل شود.
چرا خطا را به توان دو میرسانیم؟ چون اگر خطاهای مثبت و منفی مستقیماً با یکدیگر جمع شوند، ممکن است یکدیگر را خنثی کنند. با مربع کردن خطاها، این مشکل برطرف میشود و خطاهای بزرگ نیز وزن بیشتری پیدا میکنند.
تابع هزینه در Linear Regression
یکی از رایجترین معیارها برای آموزش Linear Regression، Mean Squared Error یا MSE است.
هرچه MSE کمتر باشد، پیشبینیهای مدل به مقادیر واقعی نزدیکتر هستند. بنابراین میتوان فرآیند آموزش را به شکل ساده اینگونه تصور کرد:
مدل این فرآیند را تا رسیدن به ضرایب مناسب ادامه میدهد.
ضرایب مدل و تفسیر آنها
یکی از مزیتهای مهم Linear Regression، قابلیت تفسیر ضرایب مدل است.
فرض کنید مدل زیر را داشته باشیم:
ضریب Area برابر با 5 است. یعنی با ثابت در نظر گرفتن سایر متغیرهای مدل، افزایش یک واحد در Area با افزایش 5 واحد در مقدار پیشبینیشده Price همراه است.
بنابراین ضرایب فقط برای پیشبینی مهم نیستند؛ بلکه میتوانند اطلاعاتی درباره رابطه میان متغیرها نیز ارائه کنند. البته ضریب مدل لزوماً به معنای رابطه علت و معلولی نیست. مشاهده یک ضریب مثبت یا منفی به تنهایی اثبات نمیکند که متغیر موردنظر علت تغییر Target است.
علامت ضریب چه چیزی را نشان میدهد؟
- ضریب مثبت (β > 0): افزایش X با افزایش مقدار پیشبینیشده y همراه است، در شرایط ثابت بودن سایر متغیرها.
- ضریب منفی (β < 0): افزایش X با کاهش مقدار پیشبینیشده y همراه است.
- ضریب نزدیک به صفر: اگر ضریب بسیار کوچک باشد، اثر خطی آن ویژگی در مدل ممکن است کم باشد.
البته تفسیر ضریب باید با توجه به مقیاس متغیرها، سایر ویژگیهای مدل و ساختار داده انجام شود.
Residual یا باقیمانده چیست؟
Residual اختلاف میان مقدار واقعی و مقدار پیشبینیشده است:
برای مثال اگر مقدار واقعی فروش 100 واحد و مقدار پیشبینیشده 90 واحد باشد، Residual برابر با 10 خواهد بود.
بررسی Residualها فقط برای محاسبه خطا نیست؛ بلکه برای تشخیص مشکلات مدل نیز اهمیت دارد. اگر الگوی مشخصی در Residualها مشاهده شود، ممکن است نشان دهد که رابطه واقعی میان متغیرها به خوبی توسط مدل خطی نمایش داده نشده است.
معیارهای ارزیابی Linear Regression
بعد از آموزش مدل، باید بررسی کنیم که مدل چقدر خوب عمل میکند. چند معیار مهم عبارتاند از:
MAE یا Mean Absolute Error
به صورت میانگین قدرمطلق خطاها را محاسبه میکند:
مزیت مهم MAE این است که تفسیر آن ساده است و با واحد متغیر هدف بیان میشود.
MSE یا Mean Squared Error
میانگین مربع خطاها را محاسبه میکند. این معیار نسبت به خطاهای بزرگ حساستر است؛ زیرا خطا به توان دو میرسد.
RMSE یا Root Mean Squared Error
ریشه دوم MSE است:
مزیت مهم RMSE این است که در همان واحد متغیر هدف قرار دارد.
R² یا ضریب تعیین
R² نشان میدهد مدل چه مقدار از تغییرپذیری متغیر هدف را در چارچوب تعریف این معیار توضیح میدهد.
مقدار بالاتر R² معمولاً نشاندهنده برازش بهتر مدل نسبت به خط مبناست، اما نباید R² را به تنهایی معیار کافی برای ارزیابی مدل در نظر گرفت.
آیا R² هرچه بیشتر باشد همیشه بهتر است؟
خیر. R² بالاتر لزوماً به معنی مناسبتر بودن مدل برای استفاده عملی نیست. یکی از محدودیتهای مهم R² این است که با افزودن ویژگیهای جدید به مدل، مقدار R² کاهش پیدا نمیکند و معمولاً افزایش مییابد؛ حتی اگر ویژگی جدید اطلاعات مفیدی برای مدل نداشته باشد. به همین دلیل، زمانی که مدلهای دارای تعداد متفاوتی از ویژگیها را با یکدیگر مقایسه میکنیم، استفاده از Adjusted R² یا R² تعدیلشده میتواند مناسبتر باشد.
برای ارزیابی مدل باید مواردی مانند:
- عملکرد روی دادههای آزمون
- MAE یا RMSE
- R² و در صورت نیاز Adjusted R²
- وجود Overfitting
- توزیع Residualها
- کیفیت داده
نیز بررسی شوند. بهخصوص نباید فقط بر اساس عملکرد مدل روی دادههای Training تصمیم گرفت.
فرضهای مهم Linear Regression
برای اینکه مدل خطی و بهخصوص استنباط آماری حاصل از آن قابل اتکا باشد، چند فرض مهم مورد توجه قرار میگیرد.
- Linearity: رابطه موردنظر باید به اندازه کافی با ساختار خطی مدل سازگار باشد.
- Independence: خطاهای مدل نباید با یکدیگر همبستگی داشته باشند. این موضوع بهخصوص در دادههای سری زمانی اهمیت زیادی دارد؛ زیرا ممکن است خطای یک مشاهده به خطای مشاهده قبلی یا بعدی وابسته باشد. این وضعیت را خودهمبستگی (Autocorrelation) مینامند.
- Homoscedasticity: پراکندگی خطاها در سطوح مختلف مقادیر پیشبینیشده نباید به شکل نامناسب تغییر کند.
- نبود Multicollinearity شدید: ویژگیهای ورودی نباید به شکل شدیدی اطلاعات تکراری داشته باشند.
- بررسی توزیع Residualها: در برخی کاربردهای استنباطی، رفتار توزیعی Residualها اهمیت بیشتری پیدا میکند.
این فرضها باید متناسب با هدف استفاده از مدل بررسی شوند؛ زیرا شرایط لازم برای پیشبینی با شرایط موردنیاز برای استنباط آماری کاملاً یکسان نیستند.
آیا Linear Regression به نرمال بودن دادهها نیاز دارد؟
این موضوع یکی از سوءبرداشتهای رایج درباره رگرسیون خطی است. برای استفاده از Linear Regression و بهدست آوردن پیشبینی، لزوماً لازم نیست خود متغیرهای ورودی یا Target دارای توزیع نرمال باشند.
فرض نرمال بودن در رگرسیون خطی، در صورت نیاز، بیشتر به خطاها یا Residuals مربوط میشود، نه به توزیع خود متغیرهای ورودی یا متغیر هدف.
نرمال بودن Residualها بهخصوص در برخی کاربردهای استنباط آماری، مانند آزمون فرض درباره ضرایب و ساخت فواصل اطمینان، اهمیت پیدا میکند.
از طرف دیگر، در نمونههای بزرگ، نقض فرض نرمال بودن خطاها معمولاً تأثیر کمتری بر نتایج استنباط آماری دارد؛ زیرا با افزایش حجم نمونه، نتایج بسیاری از روشهای آماری نسبت به این نقض مقاومتر میشوند. به عنوان یک قاعده سرانگشتی، در برخی منابع نمونههایی با بیش از حدود ۱۰ مشاهده به ازای هر متغیر نسبتاً مناسب تلقی میشوند، اما این عدد یک قانون قطعی و مستقل از شرایط داده نیست.
در مقابل، فرضهایی مانند همسانی واریانس (Homoscedasticity) و استقلال خطاها (Independence of Errors) حتی در نمونههای بزرگ نیز اهمیت خود را حفظ میکنند و نقض آنها میتواند بر اعتبار نتایج و استنباط آماری تأثیر بگذارد.
Multicollinearity چیست؟
یکی از مشکلات مهم در رگرسیون خطی Multicollinearity یا همخطی چندگانه است.
فرض کنید دو ویژگی مدل اطلاعات بسیار مشابهی ارائه دهند:
- متراژ بر حسب متر مربع
- متراژ بر حسب سانتیمتر مربع
این دو متغیر اطلاعات بسیار مشابهی دارند. در چنین شرایطی، تخمین ضرایب میتواند ناپایدار شود و تفسیر آنها دشوارتر شود.
چگونه Multicollinearity را تشخیص دهیم؟
یکی از روشهای رایج برای بررسی شدت همخطی چندگانه، استفاده از VIF یا Variance Inflation Factor است. VIF نشان میدهد واریانس برآوردشده یک ضریب تا چه اندازه به دلیل ارتباط آن ویژگی با سایر ویژگیهای مدل افزایش یافته است.
بهطور معمول:
- VIF نزدیک به 1: نشانهای از همخطی قابل توجه نیست.
- VIF بالاتر از 5: میتواند نشانه وجود همخطی باشد.
- VIF بالاتر از 10: معمولاً به عنوان نشانهای جدیتر از Multicollinearity در نظر گرفته میشود.
این آستانهها قوانین قطعی نیستند و باید با توجه به حوزه مسئله و هدف مدل تفسیر شوند.
چگونه Multicollinearity را کاهش دهیم؟
یکی از راهحلها حذف یا ترکیب متغیرهایی است که اطلاعات بسیار مشابهی ارائه میکنند. همچنین میتوان از روشهای Regularization استفاده کرد. برای مثال، Ridge Regression با اعمال جریمه L2 میتواند به پایدارتر شدن ضرایب در شرایط وجود همخطی کمک کند.
در نتیجه، Multicollinearity لزوماً به این معنی نیست که مدل هیچ کاربردی ندارد؛ اما میتواند تفسیر ضرایب و پایداری آنها را تحت تأثیر قرار دهد.
Outlierها چه تأثیری بر Linear Regression دارند؟
رگرسیون خطی، بهخصوص وقتی از معیارهای مبتنی بر مربع خطا استفاده میشود، میتواند نسبت به برخی Outlierها حساس باشد.
فرض کنید بیشتر دادهها نشاندهنده رابطهای مشخص باشند، اما چند نقطه بسیار دور از سایر دادهها قرار گرفته باشند. به دلیل مربع شدن خطا، این نقاط میتوانند تأثیر قابل توجهی بر مدل داشته باشند.
بنابراین قبل از آموزش مدل بهتر است دادهها بررسی شوند و در صورت وجود نقاط پرت، علت آنها مشخص شود. حذف خودکار Outlierها همیشه راهحل درست نیست. ممکن است یک نقطه پرت، یک خطای ثبت داده باشد یا واقعاً یک رخداد مهم در دنیای واقعی را نشان دهد.
آیا باید دادهها را Scale کنیم؟
در Linear Regression کلاسیک، Scaling ویژگیها برای محاسبه پیشبینیها از نظر ریاضی الزامی نیست. اما Scaling میتواند در شرایط خاص مفید باشد؛ برای مثال:
- مقایسه ضرایب ویژگیها
- استفاده از روشهای منظمسازی مانند Ridge و Lasso
- بهبود رفتار برخی روشهای بهینهسازی
بنابراین نباید گفت: «Linear Regression همیشه به Standardization نیاز دارد.» نیاز به Scaling به روش آموزش و هدف تحلیل بستگی دارد.
Regularization در رگرسیون خطی
وقتی تعداد ویژگیها زیاد شود یا مدل با مشکل پیچیدگی، ضرایب بزرگ یا Multicollinearity مواجه شود، میتوان از روشهای Regularization استفاده کرد. سه روش مهم عبارتاند از:
Ridge Regression
در Ridge یک جریمه بر اساس مربع ضرایب به تابع هدف اضافه میشود. این روش میتواند به کاهش اندازه ضرایب و کنترل اثر Multicollinearity کمک کند.
Lasso Regression
در Lasso از جریمهای مبتنی بر قدرمطلق ضرایب استفاده میشود. Lasso در برخی شرایط میتواند ضرایب برخی ویژگیها را به صفر برساند و از این طریق به انتخاب ویژگی نیز کمک کند.
Elastic Net
Elastic Net ترکیبی از دو نوع جریمه L1 و L2 را استفاده میکند و در واقع برخی ویژگیهای Ridge و Lasso را با یکدیگر ترکیب میکند.
به همین دلیل، Elastic Net میتواند در شرایطی که تعداد ویژگیها زیاد است و برخی ویژگیها نیز با یکدیگر همبستگی دارند، گزینه مناسبی باشد. این روش میتواند هم از مزیت Shrinkage در Ridge و هم از قابلیت ایجاد ضرایب صفر در Lasso بهره ببرد.
این روشها نسخههای منظمسازیشده رگرسیون خطی هستند و نباید آنها را صرفاً الگوریتمهای کاملاً متفاوت از مفهوم رگرسیون خطی در نظر گرفت.
مزایا و محدودیتهای Linear Regression
مزایای Linear Regression
- ساده و قابل فهم است: ساختار مدل نسبت به بسیاری از الگوریتمهای پیچیده سادهتر است.
- سرعت آموزش بالا است: در بسیاری از مسائل، آموزش آن سریع و کمهزینه است.
- قابلیت تفسیر دارد: ضرایب مدل میتوانند اطلاعات قابل توجهی درباره رابطه ویژگیها با Target ارائه کنند.
- یک Baseline مناسب است: در بسیاری از پروژههای یادگیری ماشین میتوان ابتدا Linear Regression را به عنوان یک مدل پایه اجرا کرد.
- مبنای درک مدلهای پیشرفتهتر است: مفاهیمی مانند ضرایب، تابع هزینه، Residual، Regularization و ارزیابی مدل در بسیاری از روشهای دیگر نیز اهمیت دارند.
محدودیتهای Linear Regression
- روابط غیرخطی پیچیده را بهخوبی مدل نمیکند: اگر رابطه واقعی میان ویژگیها و Target بسیار پیچیده باشد، یک مدل خطی ساده ممکن است عملکرد مناسبی نداشته باشد.
- به برخی دادههای پرت حساس است: بهخصوص هنگام استفاده از معیارهای مبتنی بر مربع خطا.
- Multicollinearity میتواند مشکلساز شود: ویژگیهای بسیار همبسته میتوانند تفسیر ضرایب را دشوار کنند.
- کیفیت داده اهمیت زیادی دارد: وجود خطا، Missing Value، اندازهگیری نامناسب و ویژگیهای نامرتبط میتواند عملکرد مدل را کاهش دهد.
- رابطه آماری را نباید با رابطه علّی اشتباه گرفت: وجود ضریب مثبت یا منفی به تنهایی اثباتکننده علت و معلول نیست.
کاربردهای رگرسیون خطی
رگرسیون خطی در طیف گستردهای از مسائل استفاده میشود.
پیشبینی قیمت
مانند قیمت خانه، قیمت خودرو و قیمت کالا.
پیشبینی فروش
با استفاده از عواملی مانند قیمت، تبلیغات، فصل و تعداد مشتریان.
پیشبینی مصرف انرژی
برای مثال میتوان از ویژگیهایی مانند دما، ساعت، روز هفته و مصرف گذشته برای پیشبینی مصرف انرژی استفاده کرد.
پیشبینی تقاضا
شرکتها میتوانند برای تخمین میزان تقاضای آینده از مدلهای رگرسیونی استفاده کنند.
تحلیل رابطه میان متغیرها
رگرسیون خطی فقط برای پیشبینی نیست و میتواند در تحلیل روابط میان متغیرها نیز مورد استفاده قرار گیرد.
چه زمانی Linear Regression انتخاب مناسبی است؟
- Target عددی باشد.
- رابطه میان متغیرها تا حد قابل قبولی خطی باشد.
- تفسیرپذیری اهمیت داشته باشد.
- یک مدل ساده و سریع نیاز داشته باشیم.
- به یک Baseline برای مقایسه مدلها نیاز داشته باشیم.
- تعداد ویژگیها و ساختار داده با مدل سازگار باشد.
چه زمانی بهتر است از Linear Regression استفاده نکنیم؟
اگر رابطه میان متغیرها بسیار غیرخطی و پیچیده باشد، Linear Regression ساده ممکن است گزینه مناسبی نباشد. همچنین اگر داده دارای موارد زیر باشد، ممکن است مدلهای دیگری عملکرد بهتری داشته باشند:
- تعاملات پیچیده
- روابط غیرخطی شدید
- Outlierهای بسیار اثرگذار
- ویژگیهای بسیار زیاد و همبسته
- ساختارهای پیچیده
البته این به معنی کنار گذاشتن Linear Regression نیست؛ معمولاً بهتر است ابتدا یک مدل پایه ایجاد شود و سپس عملکرد مدلهای دیگر با آن مقایسه شود.
یک مثال ساده و پیادهسازی در Python
فرض کنید هدف، پیشبینی قیمت خانه بر اساس متراژ باشد. دادهها به شکل زیر هستند:
| متراژ | قیمت |
|---|---|
| 50 | 200 |
| 70 | 280 |
| 90 | 360 |
| 110 | 440 |
مدل میتواند رابطهای مانند زیر یاد بگیرد:
اگر متراژ خانه جدید 100 باشد:
بنابراین مدل قیمت 400 را پیشبینی میکند. البته در یک مسئله واقعی، دادهها کاملاً منظم نیستند و مدل باید ضرایب را از روی تعداد زیادی مشاهده تخمین بزند.
پیادهسازی Linear Regression در Python
برای پیادهسازی رگرسیون خطی در Python میتوان از کتابخانههایی مانند Scikit-learn استفاده کرد. یک نمونه ساده:
from sklearn.linear_model import LinearRegression
X = [[50], [70], [90], [110]]
y = [200, 280, 360, 440]
model = LinearRegression()
model.fit(X, y)
prediction = model.predict([[100]])
print(prediction)
در این مثال:
Xویژگی ورودی است.yمقدار هدف است.fit()مدل را آموزش میدهد.predict()برای داده جدید پیشبینی انجام میدهد.
در یک پروژه واقعی، قبل از آموزش مدل باید مراحل مختلفی مانند آمادهسازی داده، تقسیم Train/Test، بررسی دادههای پرت، انتخاب ویژگیها و ارزیابی مدل نیز انجام شود.
آیا Linear Regression همان خطی است که روی نمودار رسم میکنیم؟
در رگرسیون خطی ساده، بله، میتوان مدل را به شکل یک خط روی نمودار دوبعدی نمایش داد. اما در رگرسیون چندگانه، وقتی چندین Feature داشته باشیم، مدل دیگر یک خط دوبعدی نیست؛ بلکه یک سطح یا Hyperplane در فضای چندبعدی ایجاد میکند.
به همین دلیل مفهوم Linear Regression فقط به «کشیدن یک خط روی نمودار» محدود نمیشود.
تفاوت Correlation و Linear Regression چیست؟
Correlation و Regression هر دو میتوانند درباره رابطه میان متغیرها اطلاعات بدهند، اما هدف آنها یکسان نیست.
- Correlation → سنجش شدت و جهت ارتباط بین متغیرها
- Regression → مدلسازی رابطه و پیشبینی مقدار یک متغیر
البته این دو مفهوم با یکدیگر ارتباط دارند و در تحلیل داده میتوانند مکمل یکدیگر باشند.
آیا Linear Regression فقط برای یک Feature است؟
خیر. دو حالت اصلی داریم:
- Simple Linear Regression: یک Feature دارد.
- Multiple Linear Regression: چند Feature دارد.
بنابراین نام Linear Regression به معنای داشتن تنها یک متغیر ورودی نیست.
سوالات متداول درباره Linear Regression
آیا Linear Regression فقط برای مسائل خطی مناسب است؟
آیا Linear Regression به نرمال بودن دادهها نیاز دارد؟
تفاوت Regression و Classification چیست؟
آیا R² هرچه بیشتر باشد همیشه بهتر است؟
Multicollinearity چیست و چه تأثیری دارد؟
آیا باید دادهها را قبل از Linear Regression Scale کنیم؟
Outlierها چه تأثیری بر Linear Regression دارند؟
روش Least Squares چیست و چرا از مربع خطا استفاده میشود؟
جمعبندی
Linear Regression یا رگرسیون خطی یکی از پایهایترین الگوریتمهای یادگیری ماشین و آمار برای پیشبینی متغیرهای عددی است.
در این روش، مدل تلاش میکند رابطه میان ویژگیهای ورودی و Target را با استفاده از یک رابطه خطی نمایش دهد. در سادهترین حالت، این رابطه به شکل یک خط و در حالت چندمتغیره به شکل یک Hyperplane نمایش داده میشود.
مفاهیمی مانند Coefficient، Intercept، Residual، Least Squares، MSE، MAE، RMSE و R² بخش مهمی از درک این الگوریتم هستند.
از طرف دیگر، برای استفاده صحیح از Linear Regression باید مواردی مانند خطی بودن رابطه، Multicollinearity، Outlierها، Overfitting و رفتار Residualها نیز مورد توجه قرار گیرند.
با وجود ظهور الگوریتمهای بسیار پیچیدهتر، Linear Regression همچنان اهمیت زیادی دارد؛ زیرا هم یک الگوریتم کاربردی برای پیشبینی است و هم یک مدل پایه، سریع و قابل تفسیر برای مقایسه با روشهای پیچیدهتر محسوب میشود.
اگر میخواهید یادگیری ماشین را از پایه دنبال کنید، Linear Regression یکی از مفاهیمی است که درک درست آن مسیر یادگیری الگوریتمهای بعدی را بسیار سادهتر میکند.
اگر در مورد Linear Regression، رگرسیون خطی یا معیارهای ارزیابی آن سؤالی دارید یا تجربهای در این زمینه دارید، آن را در کامنت بنویسید. کدام بخش برایتان چالشبرانگیزتر بود؟