داده آموزشی، اعتبارسنجی و تست چیست؟ تفاوت Train، Validation و Test
داده آموزشی، اعتبارسنجی و تست چیست؟ تفاوت Train، Validation و Test
داده آموزشی، اعتبارسنجی و تست چه تفاوتی دارند؟
در یک پروژه یادگیری ماشین، داشتن داده زیاد بهتنهایی تضمین نمیکند که مدل خوبی ساخته شود. یکی از مهمترین تصمیمها این است که دادهها چگونه بین مجموعه آموزشی (Training Set)، مجموعه اعتبارسنجی (Validation Set) و مجموعه آزمون (Test Set) تقسیم شوند.
اگر تمام دادهها برای آموزش مدل استفاده شوند، نمیتوان بهدرستی فهمید مدل روی دادههای جدید چگونه عمل میکند. از طرف دیگر، اگر داده آزمون در مراحل مختلف انتخاب مدل یا تنظیم پارامترها وارد فرآیند شود، ارزیابی نهایی دیگر قابل اعتماد نخواهد بود.
به همین دلیل، تفکیک درست دادهها یکی از پایههای اصلی طراحی یک پروژه یادگیری ماشین است.
در این مقاله چه چیزهایی یاد میگیرید؟
-
داده آموزشی، اعتبارسنجی و تست چیست و هر کدام چه وظیفهای دارند؟ -
تفاوت Training، Validation و Test و دلیل استفاده از هر کدام چیست؟ -
Data Leakage چیست و چگونه از آن جلوگیری کنیم؟ -
اشتباهات رایج در تقسیم دادهها و روش صحیح تقسیم داده در مسائل مختلف
فهرست مطالب
- داده آموزشی، اعتبارسنجی و تست چیست؟
- چرا دادهها را به چند مجموعه تقسیم میکنیم؟
- داده آموزشی (Training Set) چیست؟
- داده اعتبارسنجی (Validation Set) چیست؟
- داده تست (Test Set) چیست؟
- تفاوت Training، Validation و Test در یک نگاه
- یک مثال ساده برای درک تفاوت سه مجموعه
- دادهها را با چه نسبتی تقسیم کنیم؟
- آیا همیشه به داده اعتبارسنجی نیاز داریم؟
- Cross-Validation چیست و چه تفاوتی با Validation دارد؟
- تفاوت Holdout و Cross-Validation
- تقسیم داده در مسائل Classification
- تقسیم داده در دادههای نامتوازن
- تقسیم داده در مسائل Regression
- تقسیم داده در سریهای زمانی
- Data Leakage چیست؟
- چگونه از نشت اطلاعات جلوگیری کنیم؟
- نقش پیشپردازش داده در تقسیم صحیح Dataset
- اشتباهات رایج در تقسیم دادهها
- یک فرآیند استاندارد برای تقسیم داده در پروژههای یادگیری ماشین
- سؤالات متداول
- جمعبندی
۱. داده آموزشی، اعتبارسنجی و تست چیست؟
در یک پروژه یادگیری ماشین، معمولاً یک Dataset در اختیار داریم که شامل نمونههایی برای ساخت و ارزیابی مدل است. بهجای اینکه تمام این دادهها را مستقیماً برای آموزش استفاده کنیم، آنها را به چند بخش تقسیم میکنیم.
سه بخش اصلی عبارتاند از:
| مجموعه داده | نام انگلیسی | وظیفه اصلی |
|---|---|---|
| داده آموزشی | Training Set | یادگیری مدل |
| داده اعتبارسنجی | Validation Set | انتخاب و تنظیم مدل |
| داده تست | Test Set | ارزیابی نهایی مدل |
به زبان ساده:
-
Training
مدل یاد میگیرد -
Validation
تصمیم میگیریم کدام مدل یا تنظیمات بهتر است -
Test
در پایان بررسی میکنیم مدل واقعاً چقدر خوب عمل میکند
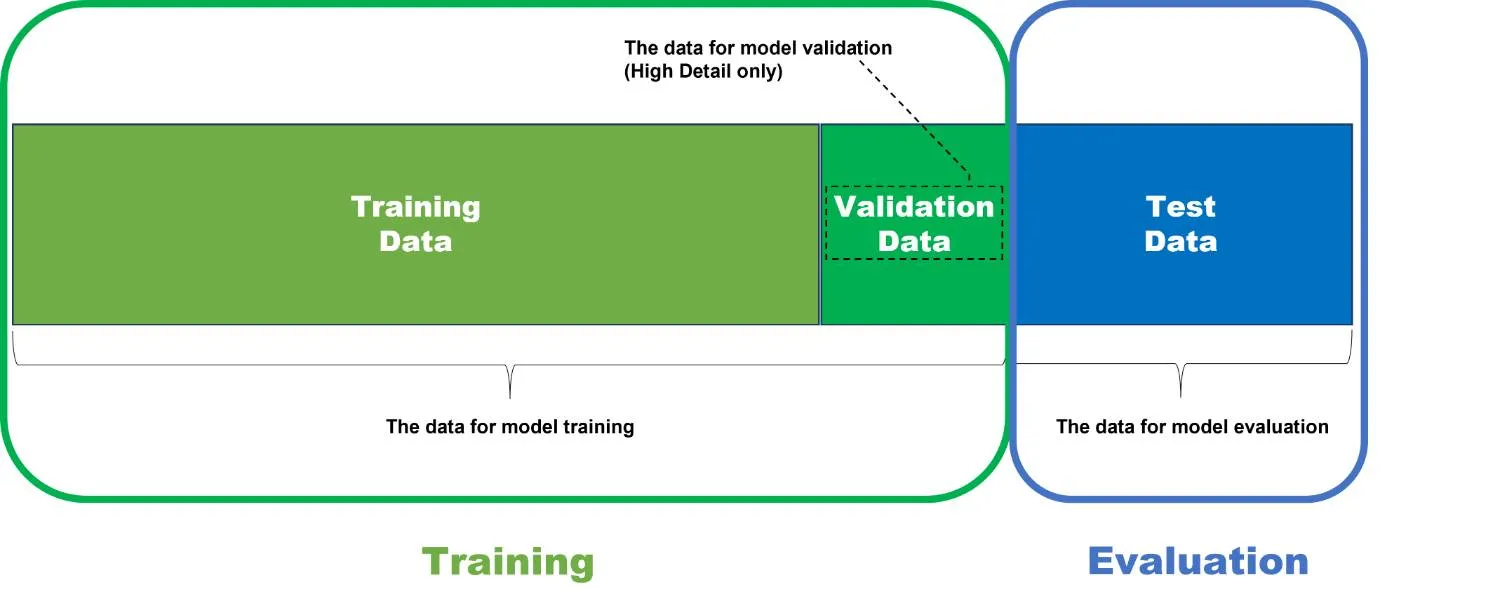
تقسیم Dataset به سه مجموعه Training، Validation و Test؛ هر بخش نقش متفاوتی در فرآیند ساخت و ارزیابی مدل ایفا میکند.
این سه مجموعه نباید با یکدیگر اشتباه گرفته شوند، زیرا هرکدام نقش متفاوتی در فرآیند توسعه مدل دارند.
۲. چرا دادهها را به چند مجموعه تقسیم میکنیم؟
هدف اصلی یادگیری ماشین این نیست که مدل فقط نمونههایی را که قبلاً دیده است بهخوبی پیشبینی کند، هدف این است که مدل بتواند روی دادههای جدید و دیدهنشده نیز عملکرد مناسبی داشته باشد. فرض کنید ۱۰ هزار رکورد در اختیار داریم و تمام آنها را برای آموزش مدل استفاده میکنیم. اگر مدل روی همین ۱۰ هزار رکورد عملکرد بسیار خوبی داشته باشد، هنوز نمیدانیم آیا واقعاً الگوی عمومی داده را یاد گرفته است یا فقط به نمونههای آموزشی وابسته شده است. این مسئله به مفهوم تعمیمپذیری (Generalization) مربوط میشود. مدلی که Generalization مناسبی دارد، الگوهای قابل تعمیم را یاد میگیرد و میتواند روی دادههایی که قبلاً ندیده است نیز عملکرد مناسبی داشته باشد. به همین دلیل، دادههای کنارگذاشتهشده برای ارزیابی نقش بسیار مهمی دارند.
۳. داده آموزشی (Training Set) چیست؟
داده آموزشی بخشی از Dataset است که مدل مستقیماً از آن برای یادگیری استفاده میکند.
در این مرحله، الگوریتم تلاش میکند رابطه میان ویژگیهای ورودی و خروجی هدف را پیدا کند.
برای مثال، فرض کنید میخواهیم قیمت خانه را پیشبینی کنیم.
ویژگیهای داده میتوانند شامل موارد زیر باشند:
- متراژ
- تعداد اتاقها
- سن ساختمان
- تعداد پارکینگ
- موقعیت مکانی
و متغیر هدف، قیمت خانه باشد.
مدل با استفاده از دادههای آموزشی تلاش میکند رابطه میان این ویژگیها و قیمت را یاد بگیرد.
در فرآیند آموزش، پارامترهای مدل بر اساس خطایی که روی داده آموزشی ایجاد میشود، بهروزرسانی میشوند.
بنابراین:
اما یک نکته مهم وجود دارد: عملکرد مدل روی Training Set بهتنهایی معیار مناسبی برای قضاوت درباره کیفیت واقعی مدل نیست.
ممکن است مدلی روی داده آموزشی عملکرد بسیار خوبی داشته باشد، اما روی دادههای جدید ضعیف عمل کند.
۴. داده اعتبارسنجی (Validation Set) چیست؟
Validation Set مجموعهای از دادههاست که برای انتخاب، تنظیم و مقایسه مدلها استفاده میشود.
این دادهها در آموزش مستقیم پارامترهای مدل وارد نمیشوند، اما در فرآیند توسعه مدل نقش مهمی دارند.
برای مثال، فرض کنید میخواهیم بین سه مدل تصمیم بگیریم:
- Decision Tree
- Random Forest
- XGBoost
مدلها را روی Training Set آموزش میدهیم و عملکرد آنها را روی Validation Set مقایسه میکنیم.
فرض کنید نتایج به این صورت باشند:
| مدل | دقت روی Validation |
|---|---|
| Decision Tree | ۸۷% |
| Random Forest | ۹۱% |
| XGBoost | ۹۳% |
در این شرایط، میتوانیم XGBoost را بهعنوان گزینه مناسبتر انتخاب کنیم.
Validation Set همچنین برای تنظیم Hyperparameterها استفاده میشود.
برای مثال:
- عمق درخت تصمیم
- تعداد درختها در Random Forest
- نرخ یادگیری در Boosting
- مقدار K در KNN
- پارامترهای مختلف SVM
بنابراین:
۵. داده تست (Test Set) چیست؟
Test Set برای ارزیابی نهایی مدل استفاده میشود.
این مجموعه باید تا حد امکان در طول فرآیند توسعه مدل دستنخورده باقی بماند.
پس از اینکه مدل انتخاب شد و تنظیمات آن نهایی شد، مدل نهایی روی Test Set اجرا میشود.
در این مرحله میتوان معیارهایی مانند موارد زیر را محاسبه کرد:
- Accuracy
- Precision
- Recall
- F1-score
- MAE
- MSE
- RMSE
- R²
هدف Test Set این است که یک برآورد نسبتاً بیطرفانه از عملکرد مدل روی دادههای جدید ارائه کند.
نکته مهم این است که Test Set نباید به ابزاری برای انتخاب مدل تبدیل شود.
اگر چندین مدل را روی Test Set امتحان کنیم و بر اساس نتیجه آنها مدل نهایی را انتخاب کنیم، Test Set عملاً بخشی از فرآیند انتخاب مدل شده است.
در این حالت، دیگر نمیتوان آن را یک آزمون کاملاً مستقل در نظر گرفت.
۶. تفاوت Training، Validation و Test در یک نگاه
تفاوت اصلی این سه مجموعه را میتوان در جدول زیر خلاصه کرد:
| ویژگی | Training | Validation | Test |
|---|---|---|---|
| هدف | آموزش مدل | انتخاب و تنظیم مدل | ارزیابی نهایی |
| مدل از آن یاد میگیرد؟ | بله | بهصورت مستقیم خیر | خیر |
| برای تنظیم Hyperparameter استفاده میشود؟ | معمولاً خیر | بله | خیر |
| برای انتخاب مدل استفاده میشود؟ | خیر | بله | خیر |
| باید در پایان دستنخورده باقی بماند؟ | خیر | خیر | بله |
| استفاده اصلی | یادگیری | توسعه مدل | گزارش عملکرد نهایی |
پس میتوان این سه مرحله را به شکل زیر تصور کرد:
۷. یک مثال ساده برای درک تفاوت سه مجموعه
فرض کنید یک Dataset شامل ۱۰ هزار نمونه داریم.
میتوانیم دادهها را به این شکل تقسیم کنیم:
- ۷۰۰۰ نمونه برای Training
- ۱۵۰۰ نمونه برای Validation
- ۱۵۰۰ نمونه برای Test
فرآیند کار:
مرحله اول: آموزش
مدل با ۷۰۰۰ نمونه Training آموزش داده میشود.
مرحله دوم: انتخاب مدل
چند مدل یا چند تنظیم مختلف را بررسی میکنیم و عملکرد آنها را روی ۱۵۰۰ نمونه Validation مقایسه میکنیم.
مرحله سوم: انتخاب مدل نهایی
بهترین مدل و Hyperparameterهای مناسب انتخاب میشوند.
مرحله چهارم: ارزیابی نهایی
مدل نهایی فقط یک بار یا در تعداد بسیار محدودی از دفعات، روی ۱۵۰۰ نمونه Test ارزیابی میشود.
در پایان، عملکرد روی Test Set بهعنوان نتیجه نهایی مدل گزارش میشود.
۸. دادهها را با چه نسبتی تقسیم کنیم؟
هیچ نسبت ثابتی وجود ندارد که برای تمام پروژههای یادگیری ماشین بهترین باشد.
نسبت تقسیم داده به عواملی مانند موارد زیر بستگی دارد:
- حجم Dataset
- نوع مسئله
- پیچیدگی مدل
- تعداد ویژگیها
- میزان تنوع داده
- وجود یا نبود داده کافی
- روش ارزیابی مدل
نسبتهای متداول عبارتاند از:
| Training | Validation | Test |
|---|---|---|
| ۷۰% | ۱۵% | ۱۵% |
| ۸۰% | ۱۰% | ۱۰% |
| ۸۰% | ۲۰% | – |
| ۶۰% | ۲۰% | ۲۰% |
اما این اعداد قانون قطعی نیستند.
برای Datasetهای بسیار بزرگ، حتی بخش کوچکی از داده میتواند برای Validation و Test کافی باشد.
برای Datasetهای کوچک نیز ممکن است جدا کردن یک Validation Set بزرگ باعث شود داده کمی برای آموزش مدل باقی بماند. در چنین شرایطی، روشهایی مانند Cross-Validation میتوانند گزینه مناسبتری باشند.
۹. آیا همیشه به داده اعتبارسنجی نیاز داریم؟
خیر.
در برخی پروژهها میتوان از روشهای Cross-Validation استفاده کرد و یک Validation Set ثابت و جداگانه نداشت.
برای مثال، در K-Fold Cross-Validation دادهها به K بخش تقسیم میشوند و مدل چندین بار آموزش و ارزیابی میشود.
در این حالت، بخشهای مختلف داده در نقش Validation قرار میگیرند.
یک ساختار رایج برای Datasetهای کوچک میتواند چنین باشد:
در این حالت، Test Set همچنان باید از فرآیند انتخاب مدل جدا بماند.
۱۰. Cross-Validation چیست و چه تفاوتی با Validation دارد؟
Cross-Validation یک روش برای ارزیابی مدل و انتخاب تنظیمات مناسب است که در آن دادهها به چند بخش تقسیم میشوند.
در K-Fold Cross-Validation، دادهها به K Fold تقسیم میشوند.
برای مثال، اگر K برابر ۵ باشد:
- Fold 1 برای Validation و چهار Fold دیگر برای Training
- Fold 2 برای Validation و چهار Fold دیگر برای Training
- Fold 3 برای Validation و چهار Fold دیگر برای Training
- Fold 4 برای Validation و چهار Fold دیگر برای Training
- Fold 5 برای Validation و چهار Fold دیگر برای Training
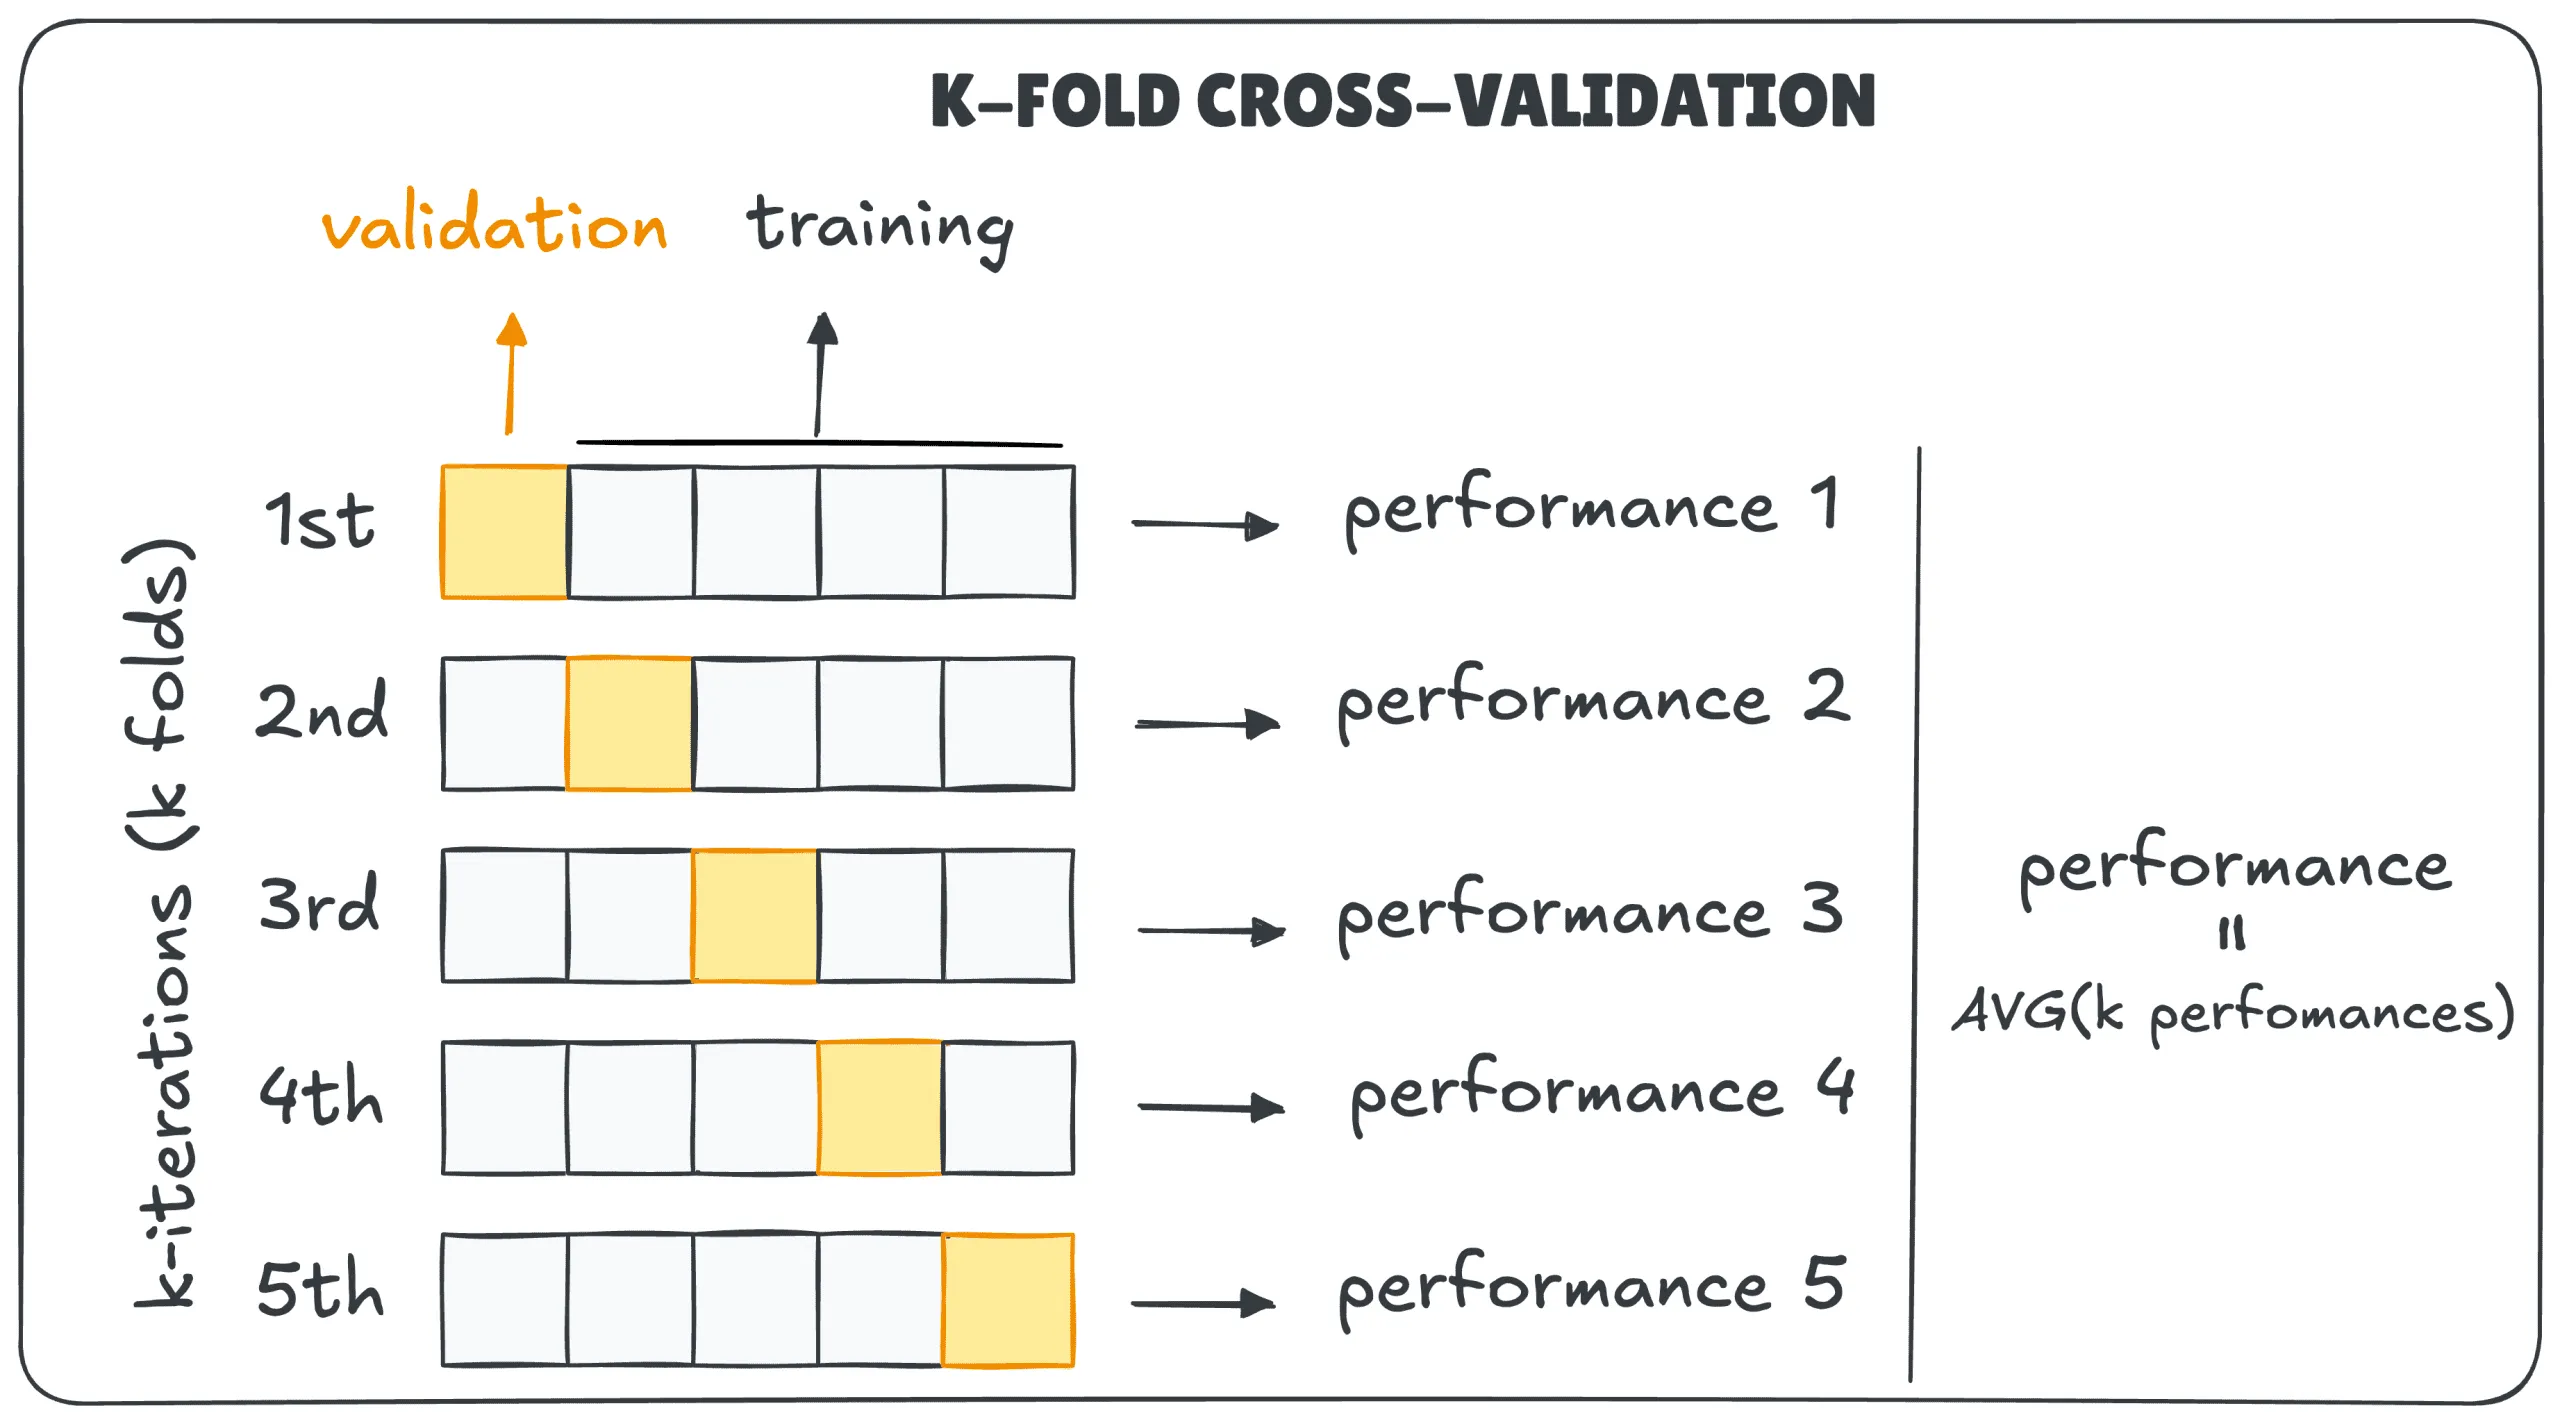
نمایش K-Fold Cross-Validation با K = ۵؛ در هر تکرار، یک Fold بهعنوان Validation و چهار Fold دیگر بهعنوان Training استفاده میشوند و در پایان نتایج همه تکرارها با یکدیگر ترکیب میشوند.
در پایان، عملکرد مدل در Foldهای مختلف با یکدیگر ترکیب میشود.
مزیت اصلی این روش این است که از داده موجود برای آموزش و اعتبارسنجی به شکل کارآمدتری استفاده میشود.
این ویژگی بهخصوص زمانی اهمیت دارد که Dataset کوچک باشد.
۱۱. تفاوت Holdout و Cross-Validation
دو روش رایج برای اعتبارسنجی مدل عبارتاند از Holdout Validation و Cross-Validation.
در Holdout، بخشی از داده یکبار برای Validation کنار گذاشته میشود.
برای مثال:
اما در Cross-Validation، چند تقسیم مختلف ایجاد میشود و مدل چندین بار ارزیابی میشود.
| ویژگی | Holdout | Cross-Validation |
|---|---|---|
| تعداد ارزیابیها | معمولاً یکبار | چندین بار |
| سرعت | بیشتر | کمتر |
| مناسب برای Dataset کوچک | محدودتر | مناسبتر |
| استفاده از داده | ساده | کارآمدتر |
| هزینه محاسباتی | پایینتر | بالاتر |
اگر Dataset بسیار بزرگ باشد، Holdout میتواند کاملاً کافی باشد.
اگر Dataset کوچک باشد، Cross-Validation معمولاً اطلاعات پایدارتری درباره عملکرد مدل ارائه میکند.
۱۲. تقسیم داده در مسائل Classification
در مسائل Classification باید توجه داشت که توزیع کلاسها در مجموعههای مختلف بیش از حد تغییر نکند.
فرض کنید Dataset شامل دو کلاس باشد:
- ۹۰% کلاس A
- ۱۰% کلاس B
اگر تقسیم داده بهصورت تصادفی و بدون توجه به نسبت کلاسها انجام شود، ممکن است یکی از مجموعهها تعداد بسیار کمی از نمونههای کلاس B داشته باشد.
برای جلوگیری از این مشکل معمولاً از Stratified Split استفاده میشود.
در تقسیم Stratified، نسبت کلاسها تا حد امکان در مجموعههای Training، Validation و Test حفظ میشود.
مثلاً:
| مجموعه | کلاس A | کلاس B |
|---|---|---|
| Training | ۹۰% | ۱۰% |
| Validation | ۹۰% | ۱۰% |
| Test | ۹۰% | ۱۰% |
این روش بهخصوص برای Datasetهای نامتوازن اهمیت زیادی دارد.
۱۳. تقسیم داده در دادههای نامتوازن
در Datasetهای نامتوازن، یک کلاس تعداد بسیار بیشتری نمونه نسبت به کلاس دیگر دارد.
مثلاً:
- ۹۵۰۰ نمونه سالم
- ۵۰۰ نمونه بیمار
اگر دادهها بدون توجه به این وضعیت تقسیم شوند، ممکن است مدل روی کلاس اکثریت عملکرد خوبی داشته باشد اما کلاس اقلیت را بهدرستی شناسایی نکند.
در چنین پروژههایی، تنها نگاه کردن به Accuracy میتواند گمراهکننده باشد.
معیارهایی مانند موارد زیر نیز باید بررسی شوند:
- Precision
- Recall
- F1-score
- ROC-AUC
- PR-AUC
- Confusion Matrix
نکته مهمتر این است که عملیاتهایی مانند Oversampling، SMOTE یا Undersampling نباید قبل از تقسیم داده روی کل Dataset انجام شوند.
ابتدا باید داده به مجموعههای مناسب تقسیم شود و سپس عملیات مربوط به افزایش یا کاهش نمونهها فقط روی Training Set انجام شود.
در غیر این صورت احتمال Data Leakage ایجاد میشود.
۱۴. تقسیم داده در مسائل Regression
در Regression، متغیر هدف معمولاً عددی و پیوسته است.
برای مثال:
- قیمت خانه
- فروش
- مصرف انرژی
- درآمد
- دما
در این مسائل نیز تقسیم داده باید به شکلی انجام شود که مجموعههای مختلف تا حد امکان نماینده توزیع واقعی مسئله باشند.
اگر Dataset دارای مقادیر بسیار دورافتاده یا توزیع نامتوازن در Target باشد، یک تقسیم کاملاً تصادفی ممکن است باعث شود Validation یا Test نماینده مناسبی از داده واقعی نباشد.
بنابراین قبل از تقسیم داده، باید توزیع متغیر هدف و ساختار Dataset بررسی شود.
در برخی پروژهها میتوان از روشهایی برای ایجاد Foldهای متوازنتر نسبت به توزیع Target استفاده کرد، اما انتخاب روش مناسب باید با توجه به ماهیت مسئله انجام شود.
۱۵. تقسیم داده در سریهای زمانی
یکی از مهمترین مواردی که نباید با تقسیم تصادفی معمولی انجام شود، Time Series Data است.
فرض کنید میخواهیم فروش ماه آینده را پیشبینی کنیم.
اگر دادههای سالهای ۱۴۰۲، ۱۴۰۳ و ۱۴۰۴ را داشته باشیم، نمیتوانیم بدون توجه به زمان، رکوردها را کاملاً تصادفی بین Training و Test پخش کنیم.
چرا؟
زیرا در دنیای واقعی، مدل قرار است از گذشته برای پیشبینی آینده استفاده کند.
ساختار مناسبتر میتواند چنین باشد:
مثلاً:
| بازه زمانی | کاربرد |
|---|---|
| ۱۴۰۱ تا پایان ۱۴۰۲ | Training |
| ۱۴۰۳ | Validation |
| ۱۴۰۴ | Test |
در این شرایط، مدل اطلاعات آینده را برای یادگیری گذشته دریافت نمیکند.
این اصل در پیشبینی فروش، قیمت، مصرف انرژی، تقاضا، بازارهای مالی و بسیاری از مسائل زمانی اهمیت بسیار زیادی دارد.
۱۶. Data Leakage چیست؟
Data Leakage یا نشت اطلاعات زمانی اتفاق میافتد که اطلاعاتی که نباید در زمان آموزش در اختیار مدل باشند، بهصورت مستقیم یا غیرمستقیم وارد فرآیند آموزش شوند.
Data Leakage یکی از خطرناکترین خطاهای طراحی پروژههای یادگیری ماشین است، زیرا میتواند باعث شود عملکرد مدل در آزمایش بسیار خوب به نظر برسد، در حالی که در استفاده واقعی عملکرد آن بهشدت افت کند.
یک مثال ساده:
فرض کنید میخواهیم بیماری یک بیمار را پیشبینی کنیم.
اگر یکی از ویژگیهای Dataset اطلاعاتی باشد که بعد از تشخیص بیماری ثبت شده است، استفاده از آن ویژگی میتواند باعث شود مدل اطلاعاتی از آینده دریافت کند.
مدل ممکن است در Dataset عملکرد بسیار خوبی داشته باشد، اما هنگام استفاده واقعی چنین اطلاعاتی قبل از پیشبینی در دسترس نیست.
۱۷. چگونه از نشت اطلاعات جلوگیری کنیم؟
برای جلوگیری از Data Leakage چند اصل مهم باید رعایت شود.
اصل اول: Test Set را جدا نگه دارید
Test Set نباید در انتخاب مدل یا تنظیم Hyperparameterها استفاده شود.
اصل دوم: پیشپردازش را فقط بر اساس Training انجام دهید
اگر میانگین، انحراف معیار، مقادیر جایگزین برای دادههای گمشده یا سایر پارامترهای پیشپردازش از کل Dataset محاسبه شوند، اطلاعات Validation یا Test ممکن است وارد فرآیند آموزش شوند.
اصل سوم: Oversampling را قبل از Split انجام ندهید
روشهایی مانند SMOTE باید فقط روی Training Set اعمال شوند.
اصل چهارم: ویژگیهای آینده را وارد مدل نکنید
در مسائل پیشبینی، باید بررسی شود که هر Feature در لحظه پیشبینی واقعاً در دسترس است یا خیر.
اصل پنجم: Test Set را برای تصمیمگیری استفاده نکنید
اگر نتیجه Test باعث شود مدل یا Hyperparameterها را تغییر دهیم، دیگر Test کاملاً مستقل نیست.
۱۸. نقش پیشپردازش داده در تقسیم صحیح Dataset
یکی از اشتباهات رایج این است که ابتدا تمام Dataset را Preprocess کنیم و سپس آن را به Training و Test تقسیم کنیم.
برای مثال، فرض کنید میخواهیم دادهها را Standardize کنیم.
اگر میانگین و انحراف معیار را از کل Dataset محاسبه کنیم، اطلاعات Test نیز در این محاسبات وارد شده است.
روش صحیح این است:
سپس:
و:
برای مثال، اگر StandardScaler استفاده شود:
- میانگین و انحراف معیار از Training محاسبه میشوند.
- سپس همان مقادیر برای تبدیل Validation و Test استفاده میشوند.
این موضوع درباره روشهایی مانند موارد زیر نیز اهمیت دارد:
- Standardization
- Normalization
- Imputation
- Feature Selection
- Dimensionality Reduction
- Feature Engineering
به همین دلیل، در یک Pipeline استاندارد، مراحل پیشپردازش و مدلسازی باید بهصورت کنترلشده به یکدیگر متصل شوند.
۱۹. اشتباهات رایج در تقسیم دادهها
اشتباه اول: آموزش روی کل Dataset
اگر تمام داده برای Training استفاده شود، ارزیابی مستقل از مدل دشوار خواهد شد.
اشتباه دوم: استفاده از Test برای انتخاب مدل
اگر مدلها را روی Test مقایسه کنیم و بهترین را انتخاب کنیم، Test دیگر کاملاً مستقل نیست.
اشتباه سوم: انجام SMOTE قبل از تقسیم داده
این کار میتواند باعث شود اطلاعات نمونههای مشابه بین Training و Test منتقل شود.
اشتباه چهارم: انجام Scaling روی کل Dataset
محاسبه پارامترهای Scaling از کل داده میتواند باعث Leakage شود.
اشتباه پنجم: تقسیم تصادفی دادههای زمانی
در Time Series، تقسیم Random ممکن است اطلاعات آینده را وارد Training کند.
اشتباه ششم: نادیده گرفتن نسبت کلاسها
در Classification نامتوازن، تقسیم نامناسب میتواند باعث شود یک مجموعه نماینده مناسبی از مسئله واقعی نباشد.
اشتباه هفتم: انتخاب مدل بر اساس Training Accuracy
Training Accuracy بالا لزوماً به معنی مدل بهتر نیست.
مدل باید بتواند روی دادههای خارج از Training نیز عملکرد مناسبی داشته باشد.
۲۰. یک فرآیند استاندارد برای تقسیم داده در پروژههای یادگیری ماشین
یک Workflow مناسب را میتوان به شکل زیر خلاصه کرد:
مرحله ۱: بررسی اولیه Dataset
ابتدا حجم داده، نوع متغیرها، توزیع Target، دادههای گمشده، دادههای پرت و ساختار زمانی بررسی میشود.
مرحله ۲: جدا کردن Test Set
بخشی از داده برای ارزیابی نهایی کنار گذاشته میشود.
مرحله ۳: تقسیم Training و Validation
در صورت نیاز، Training به بخشهای آموزشی و اعتبارسنجی تقسیم میشود.
مرحله ۴: انجام Preprocessing
پارامترهای Preprocessing فقط با استفاده از Training یاد گرفته میشوند.
مرحله ۵: آموزش مدل
مدل با Training Set آموزش داده میشود.
مرحله ۶: تنظیم Hyperparameterها
تنظیمات مختلف مدل با استفاده از Validation یا Cross-Validation بررسی میشوند.
مرحله ۷: انتخاب مدل نهایی
مدل مناسب بر اساس معیارهای تعریفشده انتخاب میشود.
مرحله ۸: ارزیابی روی Test
در نهایت، مدل نهایی روی Test Set ارزیابی میشود.
۲۱. سؤالات متداول
آیا Training و Test باید از یک Dataset باشند؟
بله، معمولاً هر دو از یک Dataset اولیه تشکیل میشوند، اما باید بهصورت مناسب از یکدیگر جدا شوند تا Test بتواند ارزیابی مستقلتری از مدل ارائه کند.
آیا Validation همان Test است؟
خیر.
Validation برای انتخاب مدل و تنظیم Hyperparameterها استفاده میشود، در حالی که Test برای ارزیابی نهایی مدل پس از پایان فرآیند توسعه در نظر گرفته میشود.
آیا همیشه باید داده را به سه بخش تقسیم کنیم؟
خیر.
در Datasetهای کوچک میتوان از Cross-Validation برای اعتبارسنجی استفاده کرد و یک Test Set مستقل را برای ارزیابی نهایی نگه داشت.
آیا میتوان Test Set را چند بار استفاده کرد؟
از نظر فنی میتوان مدل را چند بار روی Test اجرا کرد، اما اگر نتایج آن در تصمیمهای بعدی درباره مدل تأثیر بگذارد، استقلال Test کاهش پیدا میکند.
بهترین نسبت Train، Validation و Test چیست؟
نسبت ثابتی برای همه پروژهها وجود ندارد. نسبت مناسب به حجم داده، نوع مسئله، روش اعتبارسنجی و هدف پروژه بستگی دارد.
آیا برای Time Series میتوان از تقسیم تصادفی استفاده کرد؟
در بسیاری از مسائل پیشبینی زمانی، تقسیم تصادفی مناسب نیست؛ زیرا ممکن است اطلاعات آینده وارد Training شود. معمولاً ترتیب زمانی باید در تقسیم داده حفظ شود.
آیا Scaling باید قبل از تقسیم داده انجام شود؟
خیر. پارامترهای Scaling باید از Training یاد گرفته شوند و سپس همان تبدیل روی Validation و Test اعمال شود.
آیا SMOTE را باید قبل از Train-Test Split اجرا کرد؟
خیر. برای جلوگیری از Data Leakage، روشهایی مانند SMOTE باید فقط روی Training Data اعمال شوند.
اگر Dataset خیلی بزرگ باشد، آیا Validation و Test لازم هستند؟
حتی در Datasetهای بزرگ نیز وجود یک روش معتبر برای ارزیابی مدل ضروری است. ممکن است نسبت Validation و Test کوچکتر شود، اما نیاز به ارزیابی مستقل همچنان وجود دارد.
۲۲. جمعبندی
Training، Validation و Test سه نقش متفاوت در فرآیند ساخت یک مدل یادگیری ماشین دارند.
Training Set برای یادگیری مدل استفاده میشود.
Validation Set برای انتخاب مدل، مقایسه روشها و تنظیم Hyperparameterها کاربرد دارد.
Test Set باید در پایان فرآیند برای ارزیابی نهایی مدل استفاده شود.
نکته مهم این است که کیفیت تقسیم داده فقط به انتخاب یک نسبت مانند ۷۰/۱۵/۱۵ یا ۸۰/۱۰/۱۰ محدود نمیشود. نوع مسئله نیز اهمیت زیادی دارد.
در Classification باید به توزیع کلاسها توجه کرد. در Datasetهای نامتوازن باید مراقب روشهایی مانند SMOTE و Oversampling بود. در مسائل Regression باید توزیع Target بررسی شود و در سریهای زمانی، ترتیب زمانی دادهها حفظ شود.
از طرف دیگر، Data Leakage یکی از مهمترین خطاهایی است که میتواند نتایج یک پروژه را غیرواقعی کند. استفاده نادرست از Test Set، انجام Preprocessing روی کل Dataset، اجرای SMOTE قبل از تقسیم داده و وارد کردن اطلاعات آینده از مهمترین نمونههای این مشکل هستند.
بنابراین یک پروژه یادگیری ماشین موفق فقط به انتخاب الگوریتم مناسب وابسته نیست. نحوه تقسیم داده، روش اعتبارسنجی، جلوگیری از نشت اطلاعات و طراحی صحیح فرآیند ارزیابی، بخش جداییناپذیر ساخت یک مدل قابل اعتماد هستند.