Reinforcement Learning چیست؟ آشنایی با یادگیری تقویتی و کاربردهای آن
یادگیری تقویتی چیست؟ آشنایی با Reinforcement Learning، نحوه کار و کاربردها
یادگیری تقویتی یا Reinforcement Learning (RL) یکی از مهمترین رویکردهای یادگیری ماشین برای حل مسائل تصمیمگیری متوالی است. در این روش، یک عامل هوشمند بهجای اینکه پاسخ درست هر مسئله را مستقیماً از دادههای آموزشی دریافت کند، با یک محیط تعامل میکند، اقدام انجام میدهد و بر اساس نتیجه آن اقدام بازخورد دریافت میکند.
هدف عامل این است که از تجربههای خود یاد بگیرد و بهتدریج سیاستی پیدا کند که در بلندمدت بیشترین پاداش ممکن را به دست آورد.
به همین دلیل، یادگیری تقویتی بیشتر از آنکه صرفاً به «پیشبینی» مربوط باشد، به تصمیمگیری و انتخاب بهترین اقدام در شرایط مختلف مربوط است.
در این مقاله چه چیزهایی یاد میگیرید؟
-
مفهوم Reinforcement Learning را به زبان ساده و علمی توضیح دهید. -
مفهوم Agent، Environment، State، Action و Reward را بشناسید. -
با Q-Learning، SARSA و روشهای Policy Gradient آشنا شوید. -
تشخیص دهید چه مسئلهای برای یادگیری تقویتی مناسب است.
فهرست مطالب
- یادگیری تقویتی چیست؟
- یادگیری تقویتی در میان انواع یادگیری ماشین
- یادگیری تقویتی چگونه کار میکند؟
- اجزای اصلی یادگیری تقویتی
- یک مثال ساده از یادگیری تقویتی
- مفهوم پاداش و پاداش تجمعی
- سیاست یا Policy چیست؟
- تفاوت Exploration و Exploitation
- یادگیری تقویتی اپیزودیک و پیوسته
- الگوریتمهای مهم یادگیری تقویتی
- کاربردهای یادگیری تقویتی
- مزایا و محدودیتهای یادگیری تقویتی
- چه زمانی از یادگیری تقویتی استفاده کنیم؟
- جمعبندی
یادگیری تقویتی چیست؟
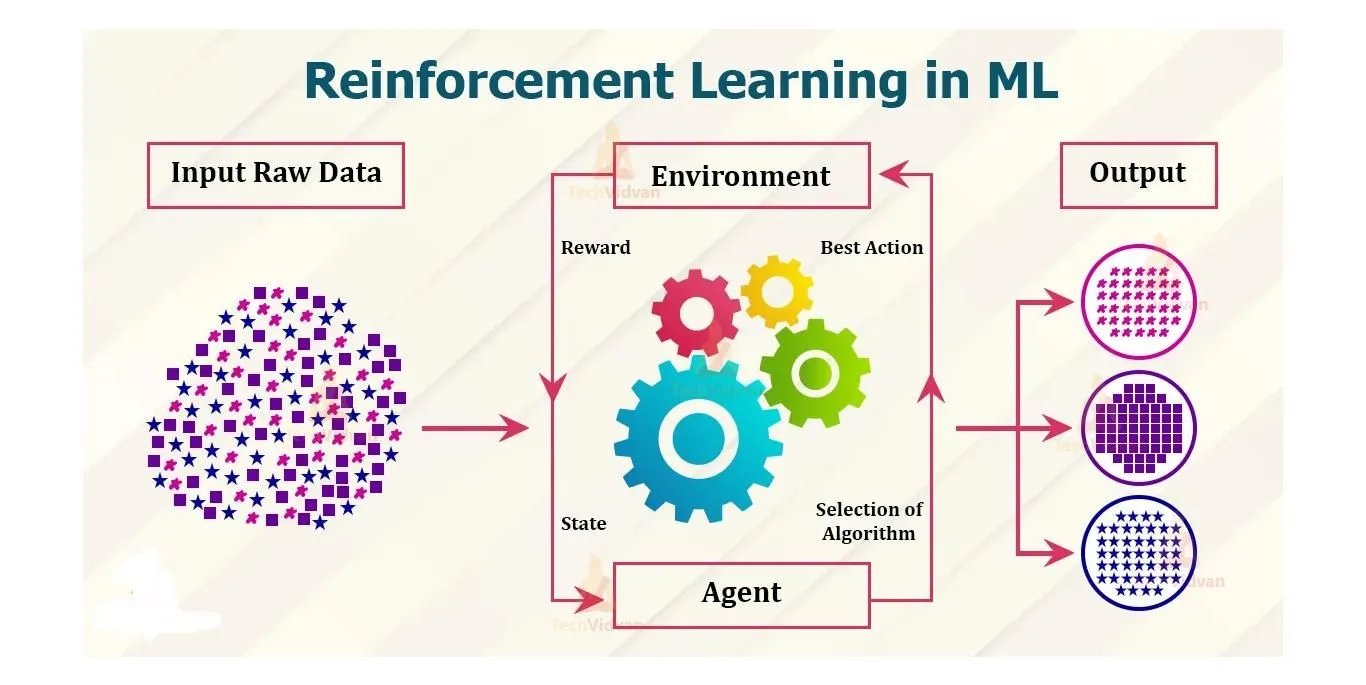
یادگیری تقویتی روشی از یادگیری ماشین است که در آن یک عامل (Agent) با یک محیط (Environment) تعامل میکند و با انجام اقدامات مختلف و دریافت پاداش یا جریمه، یاد میگیرد چه تصمیمهایی در شرایط مختلف بگیرد.
در اینجا برخلاف یادگیری نظارتشده، معمولاً مجموعهای از نمونهها با پاسخ صحیح در اختیار مدل قرار نمیگیرد.
عامل باید خودش تجربه کسب کند.
فرآیند را میتوان به شکل ساده زیر در نظر گرفت:
یعنی:
- عامل وضعیت فعلی را مشاهده میکند.
- یک اقدام انتخاب میکند.
- محیط در پاسخ به آن اقدام، پاداشی ارائه میدهد.
- محیط به وضعیت جدیدی منتقل میشود.
- عامل از این تجربه برای تصمیمهای آینده استفاده میکند.
هدف فقط گرفتن یک پاداش بزرگ در یک لحظه نیست؛ بلکه عامل باید یاد بگیرد چگونه مجموع پاداشهای آینده را نیز بیشینه کند.
این ویژگی، یادگیری تقویتی را برای مسائل تصمیمگیری چندمرحلهای بسیار مناسب میکند.
یادگیری تقویتی در میان انواع یادگیری ماشین
برای درک جایگاه Reinforcement Learning، ابتدا باید بدانیم یادگیری ماشین تنها یک روش یادگیری نیست و رویکردهای مختلفی دارد.
در یادگیری نظارتشده (Supervised Learning)، مدل از دادههایی استفاده میکند که پاسخ یا برچسب آنها مشخص است. برای مثال، اگر بخواهیم ایمیلها را به دو گروه «اسپم» و «غیراسپم» تقسیم کنیم، مدل از نمونههایی استفاده میکند که برچسب آنها مشخص شده است.
در یادگیری بدوننظارت (Unsupervised Learning)، هدف معمولاً کشف ساختارها و الگوهای موجود در داده بدون داشتن برچسب مشخص است؛ برای مثال، گروهبندی مشتریان بر اساس ویژگیهای رفتاری.
همچنین در یادگیری نیمهنظارتشده (Semi-Supervised Learning)، از ترکیبی از دادههای برچسبدار و بدونبرچسب استفاده میشود.
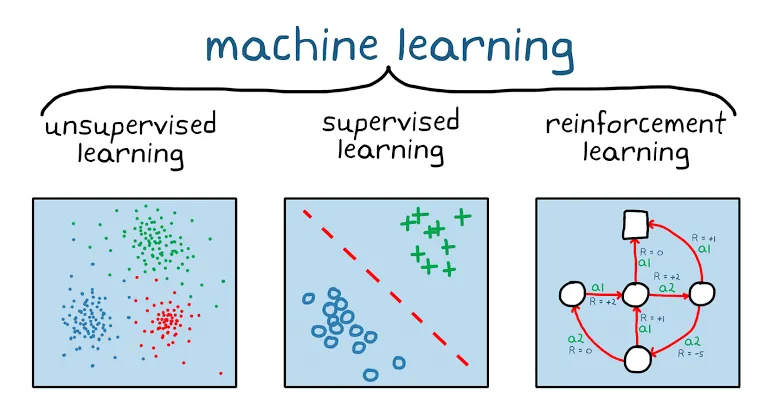
اما در یادگیری تقویتی، مسئله متفاوت است.
اینجا معمولاً سؤال اصلی این نیست که:
«این داده متعلق به کدام کلاس است؟»
بلکه سؤال این است:
«در این وضعیت، چه اقدامی انجام دهم تا در بلندمدت بهترین نتیجه را بگیرم؟»
بنابراین، RL بیشتر یک چارچوب برای یادگیری تصمیمگیری از طریق تعامل و بازخورد است.
یادگیری تقویتی چگونه کار میکند؟
فرض کنید یک ربات باید در یک محیط حرکت کند و به یک نقطه مشخص برسد.
ربات در هر لحظه وضعیت محیط را مشاهده میکند. سپس میتواند مثلاً یکی از چهار اقدام زیر را انتخاب کند:
- حرکت به بالا
- حرکت به پایین
- حرکت به چپ
- حرکت به راست
اگر ربات به هدف نزدیک شود، ممکن است پاداش دریافت کند و اگر با مانع برخورد کند، جریمه شود.
در ابتدا ربات نمیداند کدام مسیر بهترین است.
بنابراین اقدامات مختلف را امتحان میکند و از نتایج آنها یاد میگیرد.
پس از تعداد زیادی تعامل، ممکن است متوجه شود که بعضی مسیرها معمولاً به پاداش بیشتری منجر میشوند.
در نهایت، هدف این است که ربات بتواند برای هر وضعیت، اقدام مناسبی را انتخاب کند.
این فرآیند اساس یادگیری تقویتی است.
اجزای اصلی یادگیری تقویتی
برای فهم RL باید چند مفهوم اصلی را بهخوبی بشناسیم.
۱. عامل (Agent)
Agent موجودیتی است که تصمیم میگیرد و اقدام انجام میدهد.
عامل میتواند یک نرمافزار، ربات، سیستم کنترل یا هر سیستم تصمیمگیرنده دیگری باشد.
برای مثال:
- بازیکن هوشمند در یک بازی
- ربات
- سیستم کنترل خودرو
- سیستم مدیریت منابع
- یک برنامه معاملهگر
همگی میتوانند در قالب Agent تعریف شوند.
۲. محیط (Environment)
محیط سیستمی است که عامل در آن فعالیت میکند.
محیط اقدامات عامل را دریافت میکند و وضعیت جدید و پاداش را در اختیار عامل قرار میدهد.
برای یک ربات، محیط میتواند یک فضای فیزیکی باشد.
برای یک بازی کامپیوتری، محیط همان دنیای بازی است.
برای یک مسئله مدیریت موجودی، محیط میتواند سیستم موجودی و تقاضای مشتریان باشد.
۳. حالت (State)
State اطلاعاتی است که وضعیت فعلی مسئله را توصیف میکند.
مثلاً در یک بازی شطرنج، موقعیت مهرهها میتواند وضعیت بازی باشد.
در یک سیستم مدیریت موجودی، وضعیت میتواند شامل مواردی مانند:
- مقدار موجودی فعلی
- میزان تقاضای اخیر
- زمان باقیمانده
- سفارشهای در حال ارسال
باشد.
کیفیت نمایش State اهمیت زیادی دارد؛ زیرا اگر اطلاعات ضروری از وضعیت سیستم در اختیار عامل نباشد، تصمیمگیری مناسب دشوار میشود.
۴. اقدام (Action)
Action کاری است که عامل میتواند در یک وضعیت انجام دهد.
برای مثال در یک خودرو:
- افزایش سرعت
- کاهش سرعت
- تغییر مسیر
میتوانند Action باشند.
مجموع اقدامهای ممکن، Action Space نامیده میشود.
فضای اقدام میتواند گسسته یا پیوسته باشد.
برای مثال، انتخاب یکی از سه مسیر یک فضای اقدام گسسته است؛ اما انتخاب مقدار دقیق نیروی واردشده به موتور یک فضای پیوسته محسوب میشود.
۵. پاداش (Reward)
Reward سیگنالی است که محیط برای ارزیابی نتیجه یک اقدام به عامل میدهد.
پاداش میتواند مثبت، منفی یا صفر باشد.
مثلاً در یک بازی:
- رسیدن به هدف: +10
- انجام یک حرکت معمولی: +1
- برخورد با مانع: -5
- شکست: -20
نکته مهم این است که پاداش همان هدف نهایی نیست؛ بلکه سیگنالی است که هدف را برای عامل تعریف میکند.
بنابراین طراحی تابع پاداش یکی از مهمترین بخشهای طراحی یک سیستم RL است.
اگر پاداش به شکل نامناسبی طراحی شود، عامل ممکن است رفتاری پیدا کند که از نظر عددی پاداش زیادی دارد اما با هدف واقعی مسئله سازگار نیست.
یک مثال ساده برای درک یادگیری تقویتی
فرض کنید میخواهیم به یک عامل یاد بدهیم در یک جدول از نقطه شروع به نقطه هدف برسد.
عامل در ابتدا هیچ اطلاعی از مسیر مناسب ندارد.
در هر مرحله:
فرض کنید رسیدن به هدف +100 امتیاز داشته باشد و برخورد با دیوار -10 امتیاز.
در ابتدا عامل ممکن است مسیرهای مختلف را امتحان کند.
برخی مسیرها به شکست منجر میشوند و برخی دیگر به هدف.
با تکرار تجربهها، عامل اطلاعات بیشتری درباره پیامد اقدامات مختلف به دست میآورد.
پس از مدتی، میتواند یاد بگیرد که در یک وضعیت مشخص، کدام اقدام احتمالاً نتیجه بهتری دارد.
این دقیقاً همان ایدهای است که الگوریتمهای مختلف RL آن را به شکل ریاضی و محاسباتی پیادهسازی میکنند.
مفهوم پاداش تجمعی چیست؟
یکی از مهمترین تفاوتهای یادگیری تقویتی با تصمیمگیریهای ساده این است که عامل فقط به پاداش فعلی توجه نمیکند.
فرض کنید دو انتخاب داریم:
- انتخاب A: همین الان پاداش 10 میدهد.
- انتخاب B: همین الان پاداش 2 میدهد اما در مراحل بعدی میتواند پاداشهای بسیار بیشتری ایجاد کند.
یک عامل RL مناسب باید بتواند گزینه B را انتخاب کند.
به همین دلیل، مفهوم Cumulative Reward یا پاداش تجمعی اهمیت زیادی دارد.
در بسیاری از مسائل، پاداشهای آینده نیز با یک ضریب Discount Factor یا γ وزندهی میشوند.
بهصورت ساده:
هرچه γ بزرگتر باشد، عامل اهمیت بیشتری برای پاداشهای آینده قائل میشود.
این موضوع یکی از پایههای ریاضی بسیاری از الگوریتمهای یادگیری تقویتی است.
Policy یا سیاست چیست؟
Policy را میتوان استراتژی تصمیمگیری عامل در نظر گرفت.
به زبان ساده:
اگر وضعیت را با S و اقدام را با A نمایش دهیم، سیاست میتواند رابطهای میان این دو برقرار کند.
برای مثال:
اگر وضعیت خودرو این باشد که فاصله با خودروی جلویی کم شده است، Policy ممکن است اقدام «کاهش سرعت» را انتخاب کند.
هدف یادگیری تقویتی در بسیاری از مسائل، پیدا کردن سیاستی است که بتواند در طول زمان بیشترین بازده را ایجاد کند.
Policy میتواند:
- قطعی (Deterministic)
- احتمالی (Stochastic)
باشد.
در سیاست قطعی، برای هر وضعیت یک اقدام مشخص انتخاب میشود.
در سیاست احتمالی، برای اقدامات مختلف احتمال در نظر گرفته میشود.
Exploration و Exploitation چیست؟
یکی از مسائل مهم در یادگیری تقویتی، انتخاب بین دو رفتار است:
Exploration؛ اکتشاف
عامل اقدامهایی را امتحان میکند که هنوز اطلاعات زیادی درباره آنها ندارد.
هدف، پیدا کردن گزینههای بهتر است.
Exploitation؛ بهرهبرداری
عامل از اطلاعاتی که قبلاً یاد گرفته استفاده میکند و اقدامهایی را انتخاب میکند که تاکنون عملکرد خوبی داشتهاند.
این دو مفهوم یک تعارض مهم ایجاد میکنند.
اگر عامل فقط از گزینههای شناختهشده استفاده کند، ممکن است هرگز یک راهحل بهتر را کشف نکند.
اگر هم دائماً به دنبال گزینههای جدید باشد، ممکن است از راهحلهای خوبی که قبلاً پیدا کرده استفاده نکند.
بنابراین یک RL مناسب باید بین Exploration و Exploitation تعادل ایجاد کند.
یکی از روشهای ساده برای این کار، ε-greedy است که در آن عامل با احتمال مشخصی یک اقدام تصادفی و در غیر این صورت بهترین اقدام شناختهشده را انتخاب میکند.
یادگیری تقویتی اپیزودیک و پیوسته
مسائل RL را میتوان از نظر ساختار زمانی نیز بررسی کرد.
مسائل اپیزودیک
در این مسائل، فرآیند از یک نقطه شروع میشود و پس از رسیدن به یک وضعیت پایانی تمام میشود.
بازیهایی مانند شطرنج یا یک مرحله از یک بازی کامپیوتری نمونهای از این نوع مسائل هستند.
مسائل پیوسته
در برخی مسائل، پایان مشخصی برای فرآیند وجود ندارد.
برای مثال، یک سیستم کنترل ترافیک میتواند بهصورت مداوم در حال تصمیمگیری باشد.
این تفاوت روی نحوه تعریف پاداش، ارزیابی عملکرد و انتخاب الگوریتم تأثیر میگذارد.
الگوریتمهای مهم یادگیری تقویتی
یادگیری تقویتی فقط یک الگوریتم نیست؛ بلکه مجموعهای از روشها و خانوادههای الگوریتمی است.
Q-Learning
Q-Learning یکی از معروفترین الگوریتمهای کلاسیک RL است.
ایده اصلی آن یادگیری مقدار Q برای زوجهای State-Action است.
این مقدار نشان میدهد انجام یک اقدام مشخص در یک وضعیت، با در نظر گرفتن پاداشهای آینده، تا چه اندازه مطلوب است.
در نهایت عامل میتواند برای هر State، اقدامی را انتخاب کند که Q-value بیشتری دارد.
Q-Learning برای مسائل با فضای حالت و اقدام نسبتاً کوچک بسیار مناسب است.
SARSA
SARSA نیز یک الگوریتم مبتنی بر Value Function است.
نام SARSA از پنج مؤلفه زیر گرفته شده است:
تفاوتهای فنی SARSA و Q-Learning به نحوه بهروزرسانی ارزش اقدامها و سیاست مورد استفاده مربوط میشود.
بهطور کلی، هر دو الگوریتم در خانواده روشهای Value-Based قرار میگیرند.
روشهای Policy Gradient
در روشهای Policy Gradient بهجای اینکه مستقیماً بهترین مقدار Action را یاد بگیریم، تلاش میشود خود Policy بهینه شود.
این خانواده برای مسائل با فضای اقدام پیچیدهتر نیز اهمیت دارد.
روشهای Actor-Critic نیز از ایده ترکیب یک بخش تصمیمگیرنده با یک بخش ارزیاب استفاده میکنند و پایه بسیاری از الگوریتمهای پیشرفته RL هستند.
کاربردهای یادگیری تقویتی
یکی از دلایل اهمیت RL، توانایی آن در حل مسائل تصمیمگیری متوالی است.
بازیهای کامپیوتری
یکی از شناختهشدهترین کاربردهای RL، آموزش عاملهای هوشمند برای بازیها است.
عامل میتواند با انجام بازی و مشاهده نتیجه اقدامات خود، بهتدریج استراتژی مناسب را یاد بگیرد.
بازیها محیط مناسبی برای RL هستند، زیرا:
- وضعیتها قابل تعریف هستند.
- اقدامات مشخص هستند.
- پاداش قابل تعیین است.
- امکان اجرای تعداد زیادی تجربه وجود دارد.
رباتیک
در رباتیک، عامل باید تصمیم بگیرد چگونه حرکت کند یا چگونه یک کار را انجام دهد.
برای مثال:
- حرکت بازوی رباتیک
- کنترل حرکت ربات
- گرفتن اشیا
- مسیریابی
- حفظ تعادل
از جمله مسائلی هستند که میتوانند با RL بررسی شوند.
مزیت مهم RL در این حوزه، امکان یادگیری رفتارهای پیچیده از طریق تعامل با محیط است.
خودروهای خودران
در سیستمهای خودران، تصمیمگیری یک مسئله چندمرحلهای است.
خودرو باید با توجه به وضعیت محیط درباره مواردی مانند:
- سرعت
- ترمز
- تغییر مسیر
- فاصله با سایر خودروها
تصمیم بگیرد.
البته استفاده از RL در چنین سیستمهای ایمنیحساس نیازمند شبیهسازی، اعتبارسنجی و کنترلهای ایمنی بسیار جدی است.
مدیریت منابع و موجودی
RL میتواند در مسائلی به کار رود که تصمیمهای امروز روی وضعیت آینده سیستم اثر میگذارند.
برای مثال در مدیریت موجودی، تصمیم درباره مقدار سفارش امروز میتواند روی:
- موجودی آینده
- هزینه نگهداری
- کمبود کالا
- سطح خدمت
اثر بگذارد.
این ساختار زمانی باعث میشود RL در برخی مسائل مدیریت منابع و تحقیق در عملیات نیز جذاب باشد.
سیستمهای توصیهگر
در سیستمهای توصیهگر، انتخاب یک پیشنهاد میتواند بر رفتارهای بعدی کاربر تأثیر بگذارد.
بنابراین در برخی سناریوها میتوان مسئله را بهصورت تصمیمگیری متوالی مدل کرد و RL را برای بهینهسازی بلندمدت تعامل با کاربر به کار برد.
مدیریت ترافیک و شبکه
کنترل چراغهای راهنمایی، مدیریت منابع در شبکههای ارتباطی و تخصیص منابع در سیستمهای پیچیده از دیگر حوزههایی هستند که ساختار تصمیمگیری متوالی دارند.
در چنین مسائلی، عامل میتواند با مشاهده وضعیت سیستم و دریافت بازخورد، سیاست مناسبتری یاد بگیرد.
مزایای یادگیری تقویتی
یادگیری تقویتی در شرایط مناسب مزیتهای مهمی دارد:
۱. مناسب برای تصمیمگیری متوالی
وقتی تصمیم فعلی روی تصمیمها و نتایج آینده اثر میگذارد، RL میتواند چارچوب مناسبی ارائه کند.
۲. عدم نیاز به برچسبگذاری مستقیم
عامل به جای دریافت پاسخ صحیح برای هر نمونه، از تعامل و بازخورد محیط یاد میگیرد.
۳. امکان یادگیری رفتارهای پیچیده
با طراحی مناسب محیط و تابع پاداش، عامل میتواند استراتژیهایی را یاد بگیرد که از قبل بهصورت صریح برنامهنویسی نشدهاند.
۴. قابلیت استفاده در محیطهای پویا
در برخی مسائل، عامل میتواند با تغییر وضعیت محیط بهصورت مستمر تصمیمگیری کند.
محدودیتهای یادگیری تقویتی
با وجود قدرت زیاد، RL راهحل همه مسائل یادگیری ماشین نیست.
نیاز به تجربه زیاد
بسیاری از الگوریتمهای RL برای یادگیری مناسب به تعداد زیادی تعامل نیاز دارند.
اگر هر تعامل در دنیای واقعی هزینهبر باشد، آموزش دشوار میشود.
طراحی Reward
طراحی یک تابع پاداش مناسب همیشه ساده نیست.
اگر پاداش هدف واقعی را بهدرستی منعکس نکند، عامل ممکن است راهی برای بیشینه کردن پاداش پیدا کند که از نظر انسان مطلوب نیست.
این مسئله را میتوان بهعنوان یکی از چالشهای اصلی طراحی سیستمهای RL در نظر گرفت.
ناپایداری برخی روشها
برخی الگوریتمهای RL، بهخصوص روشهای مبتنی بر شبکههای عصبی، میتوانند نسبت به تنظیم پارامترها و شرایط آموزش حساس باشند.
بنابراین انتخاب الگوریتم، تنظیم Hyperparameterها و طراحی محیط اهمیت زیادی دارد.
دشواری ارزیابی در دنیای واقعی
در یک بازی کامپیوتری میتوان هزاران یا میلیونها بار آزمایش انجام داد.
اما برای یک ربات یا خودروی واقعی، اجرای آزمون و خطای گسترده ممکن است خطرناک یا بسیار پرهزینه باشد.
به همین دلیل، شبیهسازی در بسیاری از پروژههای RL اهمیت زیادی دارد.
چه زمانی از یادگیری تقویتی استفاده کنیم؟
یک اشتباه رایج این است که تصور کنیم هر مسئلهای را میتوان با RL حل کرد.
اگر مسئله شما صرفاً پیشبینی یک خروجی از روی دادههای تاریخی باشد، احتمالاً Supervised Learning انتخاب طبیعیتری است.
اگر هدف شما کشف ساختارهای پنهان در دادهها باشد، ممکن است Unsupervised Learning مناسبتر باشد.
اما اگر مسئله دارای ویژگیهای زیر باشد، RL میتواند گزینه مناسبی باشد:
- تصمیمها بهصورت متوالی گرفته میشوند.
- اقدام فعلی روی وضعیت آینده اثر میگذارد.
- برای اقدامات مختلف میتوان بازخورد تعریف کرد.
- هدف، بهینهسازی عملکرد در طول زمان است.
- امکان تعامل عامل با محیط وجود دارد.
- یک تابع هدف یا Reward قابل تعریف است.
در واقع سؤال اصلی این نیست که «آیا RL روش قدرتمندی است؟»
سؤال درست این است:
«آیا مسئله من ذاتاً یک مسئله تصمیمگیری متوالی است؟»
اگر پاسخ مثبت باشد، بررسی RL منطقیتر میشود.
جمعبندی
یادگیری تقویتی یا Reinforcement Learning روشی از یادگیری ماشین برای حل مسائل تصمیمگیری است که در آن یک عامل با محیط تعامل میکند، اقدام انجام میدهد و بر اساس نتیجه اقدامات خود بازخورد دریافت میکند.
مفاهیم اصلی آن شامل Agent، Environment، State، Action، Reward و Policy هستند.
تفاوت اصلی RL با یادگیری نظارتشده در این است که عامل معمولاً پاسخ صحیح هر تصمیم را از قبل دریافت نمیکند؛ بلکه باید از تجربه و پیامد اقدامات خود یاد بگیرد.
از طرف دیگر، هدف RL صرفاً بهینه کردن یک تصمیم منفرد نیست، بلکه پیدا کردن رفتاری است که بتواند پاداش تجمعی بلندمدت را افزایش دهد.
به همین دلیل، یادگیری تقویتی در حوزههایی مانند بازیها، رباتیک، کنترل، مدیریت منابع، سیستمهای خودران و برخی مسائل پیچیده تصمیمگیری کاربرد دارد.
با این حال، RL روش سادهای برای همه مسائل نیست. نیاز به تجربه زیاد، طراحی مناسب تابع پاداش، هزینه تعامل با محیط و پیچیدگی آموزش از جمله چالشهای مهم آن هستند.
بنابراین بهترین نگاه به یادگیری تقویتی این نیست که آن را صرفاً «یک الگوریتم دیگر یادگیری ماشین» بدانیم؛ بلکه باید آن را چارچوبی برای یادگیری تصمیمگیری از طریق تعامل با محیط در نظر بگیریم.
یادگیری تقویتی را بهعنوان چارچوبی برای تصمیمگیری متوالی در نظر بگیرید، نه فقط یک الگوریتم دیگر.