یادگیری بدون نظارت چیست؟ از مفهوم و انواع تا الگوریتمها
یادگیری بدون نظارت چیست؟ از مفهوم و انواع تا الگوریتمها
یادگیری بدون نظارت چیست؟
یادگیری بدون نظارت (Unsupervised Learning) یکی از مهمترین رویکردهای یادگیری ماشین است که در آن مدل بدون دریافت برچسبهای از پیش تعیینشده، تلاش میکند ساختار، الگوها و روابط موجود در دادهها را پیدا کند.
در بسیاری از مسائل واقعی، دادههای زیادی در اختیار داریم اما نمیدانیم هر نمونه دقیقاً متعلق به چه دستهای است. در چنین شرایطی، یادگیری بدون نظارت میتواند به کشف الگوهای پنهان در دادهها کمک کند.
برای مثال، میتوان مشتریان یک فروشگاه را بر اساس رفتار خرید به گروههای مختلف تقسیم کرد، دادههای پیچیده را به تعداد کمتری متغیر تبدیل کرد یا نمونههای غیرعادی را شناسایی کرد.
در این مقاله از رهیارا بررسی میکنیم یادگیری بدون نظارت چیست، چگونه کار میکند، چه الگوریتمهایی دارد، چه کاربردهایی دارد و چه تفاوتی با یادگیری نظارت شده دارد.
در این مقاله چه چیزهایی یاد میگیرید؟
-
یادگیری بدون نظارت دقیقاً چیست و چگونه کار میکند؟ -
تفاوت دادههای دارای برچسب و بدون برچسب چیست؟ -
مهمترین انواع و الگوریتمهای یادگیری بدون نظارت را بشناسید -
تفاوت یادگیری بدون نظارت با یادگیری نظارت شده
فهرست مطالب
- یادگیری بدون نظارت چیست؟
- یک مثال ساده برای درک یادگیری بدون نظارت
- یادگیری بدون نظارت چگونه کار میکند؟
- انواع روشهای یادگیری بدون نظارت
- خوشهبندی (Clustering) چیست؟
- مهمترین الگوریتمهای خوشهبندی
- کاهش بُعد (Dimensionality Reduction) چیست؟
- PCA چیست و چگونه کار میکند؟
- تشخیص ناهنجاری (Anomaly Detection) چیست؟
- چگونه عملکرد مدل بدون نظارت را ارزیابی کنیم؟
- کاربردهای یادگیری بدون نظارت
- تفاوت یادگیری بدون نظارت و یادگیری نظارت شده
- مزایا و محدودیتهای یادگیری بدون نظارت
- چه زمانی از یادگیری بدون نظارت استفاده کنیم؟
- جمعبندی
یادگیری بدون نظارت چیست؟
یادگیری بدون نظارت (Unsupervised Learning) یکی از روشهای یادگیری ماشین است که در آن الگوریتم با دادههایی کار میکند که برچسب یا خروجی هدف مشخصی ندارند.
در یادگیری نظارت شده، برای هر نمونه علاوه بر ویژگیها، یک خروجی یا برچسب نیز داریم. برای مثال، اگر بخواهیم ایمیلهای اسپم را شناسایی کنیم، دادههای آموزشی میتوانند شامل ایمیلهایی باشند که از قبل مشخص شده است اسپم هستند یا نیستند.
اما در یادگیری بدون نظارت، چنین برچسبی در اختیار مدل قرار نمیگیرد. مدل فقط دادههای ورودی را دریافت میکند و تلاش میکند ساختار، شباهتها، گروهها یا الگوهای موجود در دادهها را کشف کند.
به زبان ساده:
در یادگیری نظارت شده میگوییم «پاسخ درست چیست»؛ اما در یادگیری بدون نظارت از مدل میخواهیم «خودت الگوهای موجود در داده را پیدا کن».
اگر هنوز با مفهوم کلی یادگیری ماشین آشنا نیستید، پیشنهاد میکنیم ابتدا مقاله یادگیری ماشین چیست؟ معرفی ۴ دستهبندی اصلی را مطالعه کنید.
یک مثال ساده برای درک یادگیری بدون نظارت
فرض کنید اطلاعات خرید ۱۰ هزار مشتری یک فروشگاه را در اختیار داریم.
برای هر مشتری میدانیم:
- تعداد خریدها
- مبلغ خرید
- میانگین فاصله بین خریدها
- میزان استفاده از تخفیف
- تعداد محصولات خریداریشده
اما نمیدانیم این مشتریان به چه گروههایی تعلق دارند. برای مثال، هیچ برچسبی با عنوان «مشتری وفادار»، «مشتری کمخرید» یا «مشتری عمده» نداریم.
در این شرایط میتوانیم از الگوریتمهای خوشهبندی استفاده کنیم تا مشتریانی که رفتار مشابهی دارند، در گروههای مشترک قرار بگیرند.
ممکن است الگوریتم در نهایت گروههایی مانند این پیدا کند:
| گروه | ویژگی احتمالی |
|---|---|
| گروه ۱ | خرید زیاد و منظم |
| گروه ۲ | خرید کم اما با مبلغ بالا |
| گروه ۳ | خریدهای پراکنده و کممبلغ |
| گروه ۴ | استفاده زیاد از تخفیف |
نکته مهم این است که این گروهها از قبل به مدل داده نشدهاند؛ بلکه الگوریتم آنها را بر اساس ساختار دادهها پیدا کرده است.
یادگیری بدون نظارت چگونه کار میکند؟
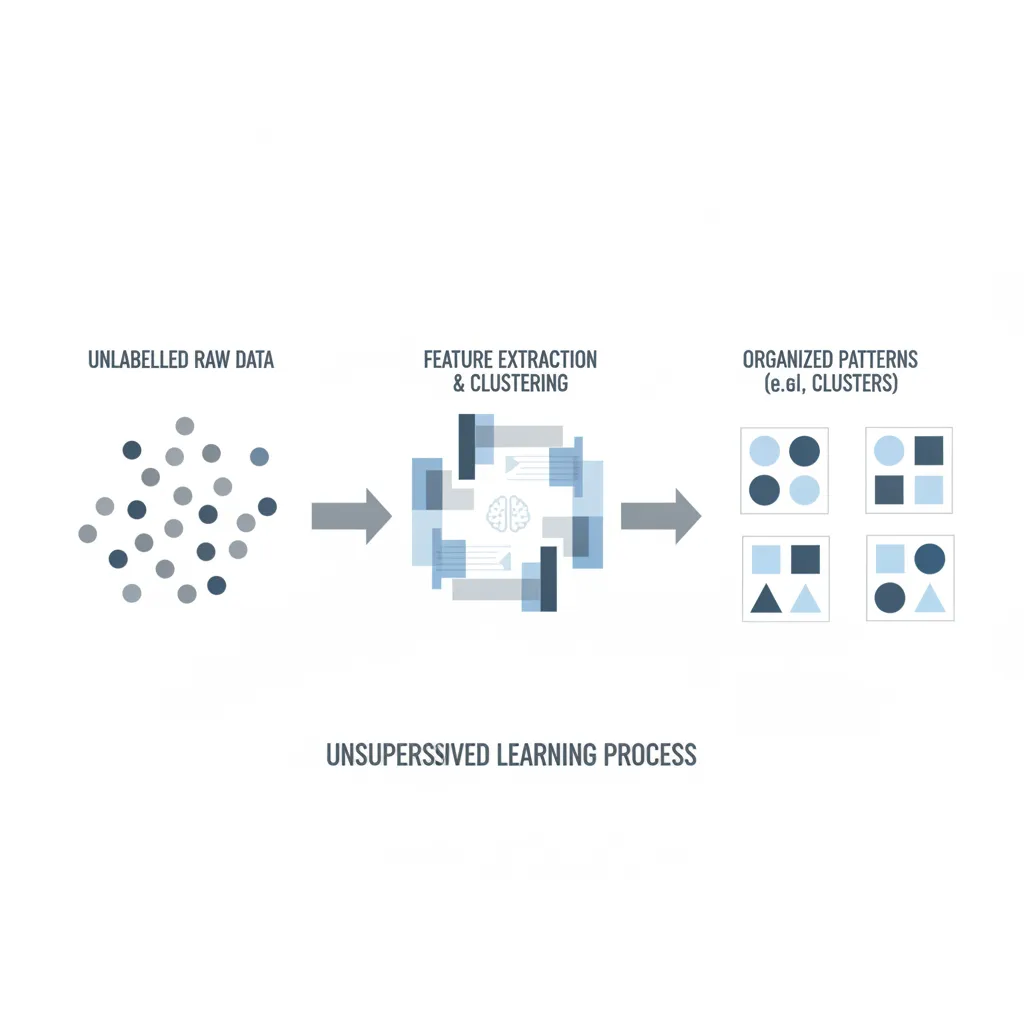
فرآیند کلی یادگیری بدون نظارت را میتوان به شکل زیر در نظر گرفت:
داده خام ← آمادهسازی داده ← انتخاب روش مناسب ← کشف الگو ← تفسیر نتایج
برای مثال، در یک مسئله خوشهبندی ممکن است مراحل زیر انجام شود:
- جمعآوری دادهها
- پاکسازی دادهها
- مدیریت دادههای گمشده
- تبدیل متغیرهای موردنیاز
- مقیاسبندی ویژگیها در صورت نیاز
- انتخاب الگوریتم مناسب
- آموزش الگوریتم
- بررسی ساختارهای کشفشده
- ارزیابی کیفیت نتایج
- تفسیر و استفاده از نتایج
در یادگیری بدون نظارت، مرحله «آموزش» به معنای یادگیری رابطه بین ورودی و یک برچسب هدف نیست؛ بلکه الگوریتم تلاش میکند ساختار درونی دادهها را پیدا کند.
انواع روشهای یادگیری بدون نظارت
یادگیری بدون نظارت یک الگوریتم مشخص نیست؛ بلکه مجموعهای از روشها و الگوریتمها است که هرکدام برای پیدا کردن نوع خاصی از ساختار یا الگو در دادههای بدون برچسب استفاده میشوند.
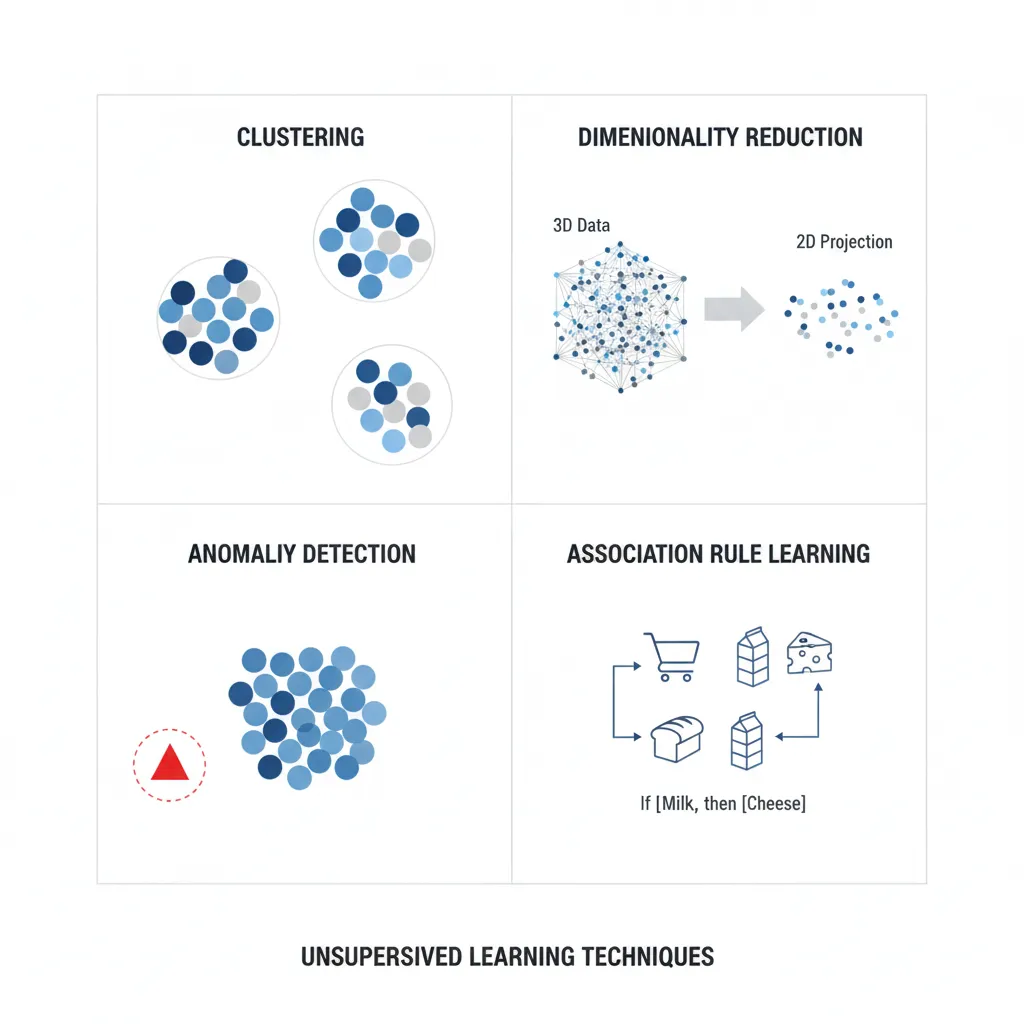
بهطور کلی، مهمترین روشهای یادگیری بدون نظارت را میتوان در چند دسته اصلی قرار داد:
۴.۱. خوشهبندی (Clustering)
در خوشهبندی، هدف این است که دادهها بر اساس شباهتشان به چند گروه یا خوشه تقسیم شوند. برای مثال، اگر اطلاعات خرید مشتریان را داشته باشیم اما ندانیم مشتریان چه گروههایی تشکیل میدهند، الگوریتم خوشهبندی میتواند مشتریانی با رفتار مشابه را در یک گروه قرار دهد.
الگوریتمهای معروف این دسته عبارتاند از: K-Means، Hierarchical Clustering، DBSCAN و Gaussian Mixture Model.
۴.۲. کاهش بُعد (Dimensionality Reduction)
در کاهش بُعد، هدف این است که دادههایی با تعداد زیادی ویژگی به یک نمایش با تعداد ویژگیهای کمتر تبدیل شوند، بهگونهای که بخش مهمی از اطلاعات داده حفظ شود. یکی از شناختهشدهترین روشهای این دسته PCA (Principal Component Analysis) است.
۴.۳. تشخیص ناهنجاری (Anomaly Detection)
در تشخیص ناهنجاری، هدف پیدا کردن نمونههایی است که رفتار آنها با الگوی غالب دادهها تفاوت زیادی دارد. از روشهای معروف این دسته میتوان به Isolation Forest، Local Outlier Factor و One-Class SVM اشاره کرد.
۴.۴. کشف روابط و الگوها (Association & Pattern Discovery)
در این دسته، هدف پیدا کردن روابط و الگوهای تکرارشونده در دادههاست. برای مثال، در دادههای مربوط به خرید مشتریان میتوان بررسی کرد که کدام محصولات معمولاً همراه با یکدیگر خریداری میشوند. روشهای Association Rule Learning مانند Apriori از نمونههای شناختهشده این رویکرد هستند.
بنابراین، وقتی از «یادگیری بدون نظارت» صحبت میکنیم، منظور یک الگوریتم خاص نیست؛ بلکه با مجموعهای از روشها روبهرو هستیم که هرکدام تلاش میکنند بدون استفاده از برچسبهای از پیش تعیینشده، بخشی از ساختار پنهان داده را کشف کنند.
خوشهبندی چیست؟
خوشهبندی (Clustering) یکی از مهمترین روشهای یادگیری بدون نظارت است.
در خوشهبندی، هدف این است که نمونههای مشابه در یک گروه قرار بگیرند و نمونههای متفاوت در گروههای متفاوت قرار بگیرند.
الگوریتم خوشهبندی تلاش میکند ساختاری در داده پیدا کند که در آن:
- اعضای یک خوشه تا حد امکان به یکدیگر شبیه باشند.
- خوشههای مختلف تا حد امکان از یکدیگر متفاوت باشند.
البته باید توجه داشت که خوشههایی که الگوریتم پیدا میکند الزاماً همان دستهبندی واقعی یا از پیش تعریفشده در دنیای واقعی نیستند. انتخاب الگوریتم، معیار فاصله و پارامترها میتواند روی نتیجه تأثیر بگذارد.
مهمترین الگوریتمهای خوشهبندی
K-Means
K-Means یکی از شناختهشدهترین الگوریتمهای خوشهبندی است. در این روش، معمولاً ابتدا تعداد خوشهها را مشخص میکنیم و الگوریتم تلاش میکند دادهها را به این تعداد گروه تقسیم کند.
بهصورت ساده، الگوریتم ابتدا مراکز اولیه خوشهها را تعیین میکند، هر نمونه را به نزدیکترین مرکز اختصاص میدهد، مرکز هر خوشه را دوباره محاسبه میکند و این فرآیند را تکرار میکند تا وضعیت خوشهها پایدار شود.
K-Means برای دادههایی که ساختار خوشهای نسبتاً مشخص دارند بسیار کاربردی است، اما انتخاب تعداد خوشهها و شکل دادهها میتواند روی عملکرد آن اثر بگذارد.
خوشهبندی سلسلهمراتبی (Hierarchical Clustering)
در این روش، خوشهها به صورت سلسلهمراتبی ساخته میشوند. دو رویکرد متداول وجود دارد: Agglomerative (ابتدا هر نمونه یک خوشه است و خوشههای مشابه به تدریج ادغام میشوند) و Divisive (ابتدا همه دادهها در یک خوشه قرار دارند و سپس به گروههای کوچکتر تقسیم میشوند). یکی از مزیتهای این روش این است که میتوان ساختار سلسلهمراتبی دادهها را بررسی کرد.
DBSCAN
DBSCAN خوشهها را بر اساس تراکم نقاط پیدا میکند. این الگوریتم برخلاف K-Means لزوماً به تعیین مستقیم تعداد خوشهها نیاز ندارد و میتواند نقاطی را که در هیچ خوشه متراکم قرار نمیگیرند، به عنوان نویز شناسایی کند. به همین دلیل، برای دادههایی با خوشههای با شکلهای متفاوت و وجود نقاط پرت میتواند انتخاب مناسبی باشد.
Gaussian Mixture Model
در مدل Gaussian Mixture فرض میشود دادهها از ترکیبی از چند توزیع گاوسی تولید شدهاند. تفاوت مهم آن با K-Means این است که به جای اختصاص قطعی هر نمونه به یک خوشه، میتواند احتمال تعلق نمونه به هر خوشه را در نظر بگیرد.
روشهای دیگر خوشهبندی
بسته به ساختار داده، روشهای دیگری نیز وجود دارند، از جمله Spectral Clustering، Mean Shift، Affinity Propagation، OPTICS، HDBSCAN و BIRCH. بنابراین نمیتوان گفت یک الگوریتم خوشهبندی همیشه بهترین انتخاب است؛ انتخاب روش باید بر اساس نوع داده، شکل خوشهها، اندازه داده و هدف مسئله انجام شود.
کاهش بُعد چیست؟
کاهش بُعد (Dimensionality Reduction) دومین دسته مهم از روشهای یادگیری بدون نظارت است.
در یادگیری بدون نظارت فقط هدف پیدا کردن گروههای مشابه نیست؛ گاهی میخواهیم ساختار داده را با تعداد کمتری متغیر یا مؤلفه نمایش دهیم.
فرض کنید یک مجموعهداده با ۱۰۰ ویژگی داریم. بررسی و تجسم چنین دادهای دشوار است و بعضی ویژگیها ممکن است اطلاعات مشابه یا همپوشان داشته باشند. کاهش بُعد تلاش میکند نمایش سادهتری از داده ایجاد کند و در عین حال بخش مهمی از اطلاعات آن را حفظ کند.
یکی از مهمترین دلایل استفاده از کاهش بُعد، سادهتر کردن تحلیل و تجسم دادههاست. Scikit-learn کاهش بُعد بدون نظارت را شامل روشهایی مانند PCA، Random Projection و Feature Agglomeration میداند.
PCA چیست و چگونه کار میکند؟
PCA یا Principal Component Analysis یکی از معروفترین الگوریتمهای کاهش بُعد و در نتیجه یکی از روشهای مهم یادگیری بدون نظارت است.
ایده اصلی PCA این است که به جای کار کردن مستقیم با تمام ویژگیهای اولیه، مجموعهای از مؤلفههای جدید ایجاد کند که بخش زیادی از تغییرپذیری داده را توضیح میدهند.
به زبان ساده، PCA تلاش میکند:
ویژگیهای زیاد ← مؤلفههای کمتر ← حفظ بیشترین اطلاعات ممکن
برای مثال، اگر دادهای ۲۰ ویژگی داشته باشد، ممکن است PCA بتواند آن را به ۲ یا ۳ مؤلفه تبدیل کند و از این نمایش برای تجسم داده یا تحلیلهای بعدی استفاده شود. از نظر ریاضی، مؤلفههای اصلی در PCA جهتهایی هستند که بیشترین واریانس داده را توضیح میدهند.
PCA چه کاربردهایی دارد؟
- کاهش تعداد ویژگیها
- تجسم دادههای چندبعدی
- کاهش پیچیدگی محاسباتی
- حذف بخشی از همبستگی میان ویژگیها
- آمادهسازی داده برای برخی مدلهای یادگیری ماشین
البته کاهش بُعد همیشه به معنای حذف «ویژگیهای بیارزش» نیست؛ PCA ویژگیهای جدیدی میسازد که ترکیبی از ویژگیهای اولیه هستند.
تشخیص ناهنجاری چیست؟
تشخیص ناهنجاری (Anomaly Detection) یکی دیگر از روشهای مهم یادگیری بدون نظارت است.
در این روش، به جای اینکه مدل را با برچسبهای «عادی» و «غیرعادی» آموزش دهیم، الگوریتم تلاش میکند الگوی معمول دادهها را شناسایی کند و نمونههایی را که تفاوت زیادی با این الگو دارند، پیدا کند.
در بسیاری از دادهها، بیشتر نمونهها رفتار مشابهی دارند و تعداد کمی از نمونهها رفتار متفاوتی نشان میدهند. به این نمونههای غیرعادی Anomaly یا Outlier گفته میشود. هدف تشخیص ناهنجاری، پیدا کردن چنین نمونههایی است.
مثلاً در یک سیستم بانکی، ممکن است بیشتر تراکنشهای یک کاربر الگوی مشابهی داشته باشند اما یک تراکنش با مبلغ و موقعیت غیرمعمول مشاهده شود. الگوریتم میتواند این نمونه را به عنوان یک مورد مشکوک علامتگذاری کند.
روشهای مختلفی برای این کار وجود دارند، مانند:
- Isolation Forest
- Local Outlier Factor
- One-Class SVM
- روشهای مبتنی بر تراکم
- روشهای آماری
بنابراین تشخیص ناهنجاری میتواند بخشی از یک سیستم کشف تقلب، پایش تجهیزات یا کنترل کیفیت باشد.
چگونه عملکرد مدل بدون نظارت را ارزیابی کنیم؟
یکی از تفاوتهای مهم یادگیری بدون نظارت با یادگیری نظارت شده، نبود برچسب واقعی در بسیاری از مسائل است.
در یادگیری نظارت شده، میتوانیم پیشبینی مدل را با مقدار واقعی مقایسه کنیم؛ اما در خوشهبندی معمولاً چنین پاسخ مشخصی در اختیار نداریم. به همین دلیل، از معیارهای مختلفی برای ارزیابی ساختار خوشهها استفاده میشود.
Silhouette Score
این معیار بررسی میکند هر نمونه چقدر به خوشه خودش نزدیک و از خوشههای دیگر دور است. مقدار بالاتر معمولاً نشاندهنده ساختار خوشهای بهتر است.
Calinski-Harabasz Index
این معیار نسبت پراکندگی بین خوشهها به پراکندگی درون خوشهها را بررسی میکند. مقدار بالاتر معمولاً مطلوبتر است.
Davies-Bouldin Index
این معیار میزان شباهت بین خوشهها را بررسی میکند. در این معیار، مقدار کمتر بهتر است.
اما یک نکته مهم وجود دارد: هیچ معیار واحدی نمیتواند به تنهایی تضمین کند که خوشهبندی از نظر کاربردی بهترین نتیجه را دارد. نتیجه باید در کنار دانش حوزه و هدف مسئله تفسیر شود.
کاربردهای یادگیری بدون نظارت
یادگیری بدون نظارت در حوزههای مختلفی کاربرد دارد.
بازاریابی و فروش
- بخشبندی مشتریان
- شناسایی الگوهای خرید
- طراحی کمپینهای هدفمند
بانکداری و مالی
- تشخیص تراکنشهای غیرعادی
- کشف الگوهای رفتاری
- تحلیل مشتریان
سلامت
- شناسایی گروههای مشابه بیماران
- کشف الگوهای موجود در دادههای پزشکی
- تحلیل دادههای ژنتیکی
تجارت الکترونیک
- تحلیل رفتار کاربران
- پیشنهاد محصولات
- کشف الگوهای خرید
امنیت سایبری
- شناسایی رفتارهای غیرعادی
- کشف الگوهای حمله
- تشخیص فعالیتهای مشکوک
پردازش تصویر
- تقسیمبندی تصاویر
- استخراج ساختارهای پنهان
- کاهش بُعد دادههای تصویری
تحلیل متن
- گروهبندی اسناد مشابه
- کشف موضوعات موجود در مجموعه اسناد
- تحلیل ساختار متون
به طور کلی، ابزارهای یادگیری بدون نظارت در خوشهبندی، کاهش بُعد، تشخیص ناهنجاری و کشف الگو کاربرد گستردهای دارند.
تفاوت یادگیری بدون نظارت و یادگیری نظارت شده
یکی از مهمترین سؤالات برای افرادی که تازه وارد یادگیری ماشین میشوند، تفاوت این دو روش است.
| ویژگی | یادگیری نظارت شده | یادگیری بدون نظارت |
|---|---|---|
| داده برچسبدار | نیاز دارد | معمولاً ندارد |
| خروجی هدف | مشخص است | از قبل مشخص نیست |
| هدف اصلی | پیشبینی | کشف ساختار و الگو |
| نمونه کاربرد | تشخیص اسپم | گروهبندی کاربران |
| مسائل رایج | Classification و Regression | Clustering و Dimensionality Reduction |
| ارزیابی | مقایسه با مقدار واقعی | بررسی کیفیت ساختار کشفشده |
برای آشنایی کاملتر با یادگیری نظارت شده میتوانید مقاله یادگیری نظارت شده چیست؟ از مفهوم و انواع تا الگوریتمها و کاربردها را مطالعه کنید.
همچنین برای مشاهده جایگاه یادگیری بدون نظارت در میان رویکردهای مختلف، مقاله تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق میتواند نقطه شروع مناسبی باشد.
مزایا و محدودیتهای یادگیری بدون نظارت
مزایای یادگیری بدون نظارت
- عدم نیاز به برچسبگذاری: تهیه دادههای برچسبدار در بسیاری از پروژهها زمانبر و پرهزینه است. روشهای بدون نظارت میتوانند از دادههای بدون برچسب استفاده کنند.
- کشف الگوهای ناشناخته: مدل میتواند ساختارهایی را پیدا کند که از قبل برای تحلیلگر مشخص نبودهاند.
- کاربرد گسترده در اکتشاف داده: این روشها میتوانند در مرحله ابتدایی تحلیل داده برای شناخت بهتر ساختار مجموعهداده مورد استفاده قرار گیرند.
- کمک به پردازش دادههای پیچیده: روشهایی مانند PCA میتوانند تعداد متغیرها را کاهش دهند و تحلیل داده را سادهتر کنند.
محدودیتهای یادگیری بدون نظارت
- تفسیر نتایج همیشه ساده نیست: ممکن است الگوریتم چند خوشه ایجاد کند، اما مشخص نباشد این خوشهها از نظر کسبوکار یا حوزه تخصصی دقیقاً چه معنایی دارند.
- انتخاب پارامترها اهمیت زیادی دارد: پارامترهایی مانند تعداد خوشهها، معیار فاصله یا حداقل تعداد نقاط میتوانند نتیجه را تغییر دهند.
- نبود پاسخ درست مشخص: در بسیاری از مسائل، نمیتوان به سادگی گفت نتیجه الگوریتم «درست» یا «غلط» است.
- حساسیت به داده: مقیاس ویژگیها، نویز، دادههای پرت و انتخاب ویژگیها میتوانند روی نتیجه اثر قابل توجهی داشته باشند.
بنابراین استفاده از الگوریتم بدون نظارت به این معنی نیست که میتوان داده را مستقیماً وارد مدل کرد و نتیجه را بدون تحلیل پذیرفت.
چه زمانی از یادگیری بدون نظارت استفاده کنیم؟
اگر هدف شما یکی از موارد زیر باشد، یادگیری بدون نظارت میتواند گزینه مناسبی باشد:
- داده برچسب ندارد؟ ← روشهای بدون نظارت را بررسی کنید.
- میخواهید گروههای طبیعی موجود در داده را پیدا کنید؟ ← سراغ Clustering بروید.
- تعداد ویژگیها بسیار زیاد است؟ ← Dimensionality Reduction مانند PCA را بررسی کنید.
- به دنبال نمونههای غیرعادی هستید؟ ← Anomaly Detection را بررسی کنید.
- نمیدانید ساختار داده چگونه است؟ ← میتوانید ابتدا از روشهای اکتشافی و بدون نظارت برای شناخت داده استفاده کنید.
اما اگر برچسب مشخصی دارید و هدف پیشبینی آن برچسب است، معمولاً مسئله شما به سمت یادگیری نظارت شده میرود.
سؤالات متداول درباره یادگیری بدون نظارت
یادگیری بدون نظارت روشی از یادگیری ماشین است که در آن مدل بدون داشتن برچسب یا خروجی هدف، تلاش میکند ساختار، الگوها و روابط موجود در دادهها را کشف کند.
دادههای دارای برچسب شامل ویژگیها و پاسخ صحیح هستند، اما دادههای بدون برچسب فقط ویژگیها را دارند و پاسخ هدف مشخصی برای آنها وجود ندارد.
خوشهبندی (Clustering)، کاهش بُعد (Dimensionality Reduction)، تشخیص ناهنجاری (Anomaly Detection) و کشف روابط و الگوها (Association & Pattern Discovery) از مهمترین انواع یادگیری بدون نظارت هستند.
K-Means ابتدا مراکز اولیه خوشهها را تعیین میکند، هر نمونه را به نزدیکترین مرکز اختصاص میدهد، مرکز خوشهها را دوباره محاسبه میکند و این فرآیند را تا پایدار شدن خوشهها تکرار میکند.
PCA یک روش کاهش بُعد است که ویژگیهای جدیدی به نام مؤلفههای اصلی میسازد و تلاش میکند با تعداد کمتری متغیر، بخش زیادی از اطلاعات داده را حفظ کند.
از معیارهایی مانند Silhouette Score، Calinski-Harabasz Index و Davies-Bouldin Index برای ارزیابی کیفیت خوشهبندی استفاده میشود، اما تفسیر نتایج باید با توجه به هدف مسئله انجام شود.
جمعبندی
یادگیری بدون نظارت یکی از رویکردهای مهم یادگیری ماشین است که در آن مدل بدون دریافت برچسبهای از پیش تعیینشده، تلاش میکند ساختار و الگوهای موجود در داده را کشف کند.
مهمترین کاربردهای آن عبارتاند از:
- خوشهبندی برای پیدا کردن گروههای مشابه
- کاهش بُعد برای سادهتر کردن نمایش داده
- تشخیص ناهنجاری برای پیدا کردن نمونههای غیرعادی
- کشف الگو و روابط در دادهها
الگوریتمهایی مانند K-Means، Hierarchical Clustering، DBSCAN، Gaussian Mixture، PCA و روشهای تشخیص ناهنجاری از ابزارهای مهم این حوزه هستند.
در نهایت، مهمترین نکته این است که یادگیری بدون نظارت صرفاً به معنای «داده بدون برچسب» نیست؛ بلکه هدف اصلی آن استخراج ساختار، الگو و اطلاعات قابل استفاده از دادههایی است که پاسخ هدف از پیش مشخصی ندارند.
برای آشنایی با جایگاه این رویکرد در مسیر کلی یادگیری ماشین، میتوانید از مقاله یادگیری ماشین چیست؟ معرفی ۴ دستهبندی اصلی شروع کنید و سپس مقاله یادگیری نظارت شده چیست؟ را برای مقایسه دقیقتر مطالعه کنید.
پژوهش موفق، ترکیبی از ابزارهای هوشمند و تفکر نقادانه است.