یادگیری ماشین چیست؟ معرفی ۴ دستهبندی اصلی
یادگیری ماشین چیست؟ معرفی کامل ۴ دستهبندی اصلی + کاربردها و تفاوتها
حتماً اسم «یادگیری ماشین» یا «Machine Learning» به گوشتان خورده. اما واقعاً یعنی چه؟ آیا یک ربات است؟ یک الگوریتم خاص است؟ یا شاید یک زبان برنامهنویسی جدید؟
واقعیت این است که یادگیری ماشین، یکی از زیرمجموعههای هوش مصنوعی است که به ماشینها توانایی یادگیری از دادهها را میدهد، بدون اینکه برای هر کاری بهطور مستقیم برنامهنویسی شوند. اما جالبتر از همه، این است که خود یادگیری ماشین به چهار دستهبندی اصلی تقسیم میشود که هرکدام کاربردها و روشهای خاص خودشان را دارند.
اگر میخواهید بدانید تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق چیست، مقاله جداگانهای داریم. اما در این مقاله، تمرکز ما صرفاً بر روی چهار دستهبندی اصلی یادگیری ماشین و کاربردهای هرکدام است.
در این مقاله، قدمبهقدم و خیلی ساده، هر چهار نوع را با مثالهای ملموس معرفی میکنیم و در نهایت به شما کمک میکنیم بفهمید هرکدام برای چه مسئلهای مناسبتر است.
در این مقاله چه چیزهایی یاد میگیرید؟
-
یادگیری ماشین چیست و چه تفاوتی با هوش مصنوعی دارد؟ -
۴ دستهبندی اصلی: یادگیری نظارتشده، نظارتنشده، نیمهنظارتی و تقویتی -
کاربردهای واقعی هر دسته: از تشخیص چهره تا خودروهای خودران -
چگونه انتخاب کنیم کدام نوع یادگیری برای مسئله ما مناسب است؟
فهرست مطالب
- یادگیری ماشین چیست؟ تعریف و تفاوت با هوش مصنوعی
- ۱. یادگیری نظارتشده (Supervised Learning)
- ۲. یادگیری نظارتنشده (Unsupervised Learning)
- ۳. یادگیری نیمهنظارتی (Semi-Supervised Learning)
- ۴. یادگیری تقویتی (Reinforcement Learning)
- جدول مقایسهای ۴ نوع یادگیری ماشین
- کدام نوع یادگیری برای پروژه شما مناسب است؟
- سؤالات متداول درباره یادگیری ماشین
- جمعبندی
یادگیری ماشین چیست؟ تعریف و تفاوت با هوش مصنوعی
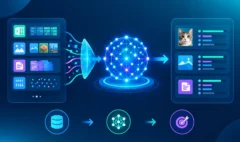
یادگیری ماشین (Machine Learning) شاخهای از هوش مصنوعی است که به سیستمها این توانایی را میدهد که بهطور خودکار و بدون برنامهریزی صریح، از دادهها یاد بگیرند و بهبود یابند. بهعبارتسادهتر، بهجای اینکه به کامپیوتر بگوییم دقیقاً چکار کند، به آن داده میدهیم و از او میخواهیم خودش الگوها را پیدا کند.
برای درک بهتر، بیایید یک تفاوت اساسی را روشن کنیم: هوش مصنوعی یک مفهوم کلی است که به هر سیستمی گفته میشود که بتواند کارهایی شبیه به هوش انسانی انجام دهد. اما یادگیری ماشین یکی از روشهای رسیدن به هوش مصنوعی است؛ روشی که بر اساس داده و الگوریتم کار میکند، نه بر اساس قوانین از پیش نوشتهشده. اگر میخواهید عمیقتر با تفاوت این مفاهیم آشنا شوید، مقاله جداگانهای داریم.
حالا که با مفهوم کلی آشنا شدید، بیایید سراغ اصل مطلب برویم: چهار دستهبندی اصلی یادگیری ماشین که هرکدام برای نوع خاصی از داده و مسئله طراحی شدهاند.
۱. یادگیری نظارتشده (Supervised Learning)
یادگیری نظارتشده رایجترین و سادهترین نوع یادگیری ماشین است. در این روش، به الگوریتم مجموعهای از دادههای «برچسبخورده» (Labeled) میدهیم؛ یعنی هر نمونه ورودی، یک خروجی مشخص دارد که بهعنوان «جواب درست» شناخته میشود. الگوریتم با مقایسه پیشبینیهای خود با جوابهای واقعی، سعی میکند خطا را کمینه کند و در نهایت به تابعی برسد که بتواند برای دادههای جدید نیز پیشبینی درست انجام دهد.
یادگیری نظارتشده خود به دو دستهٔ اصلی تقسیم میشود:
طبقهبندی (Classification)
وقتی خروجی ما یک دسته یا کلاس مشخص باشد (مثلاً «گربه» یا «سگ»، «ایمیل اسپم است» یا «اسپم نیست»)، مسئله از نوع طبقهبندی است.
رگرسیون (Regression)
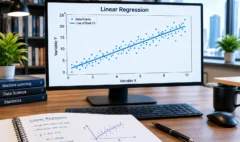
وقتی خروجی ما یک عدد پیوسته باشد (مثل قیمت خانه، دما، یا قیمت سهام)، از رگرسیون استفاده میکنیم.
کاربردهای واقعی یادگیری نظارتشده
- تشخیص چهره: تشخیص هویت افراد در عکسها.
- فیلتر اسپم: تشخیص ایمیلهای ناخواسته در جیمیل و دیگر سرویسها.
- پیشبینی قیمت مسکن: بر اساس متراژ، موقعیت، سال ساخت و…
- تشخیص پزشکی: تشخیص بیماری از روی تصاویر پزشکی مانند MRI یا اشعه ایکس.
الگوریتمهای معروف این دسته شامل رگرسیون خطی، رگرسیون لجستیک، درخت تصمیم، جنگل تصادفی، ماشین بردار پشتیبان (SVM) و شبکههای عصبی عمیق هستند.
۲. یادگیری نظارتنشده (Unsupervised Learning)
در یادگیری نظارتنشده، برخلاف نوع قبلی، به الگوریتم هیچ برچسب یا جواب درستی داده نمیشود. الگوریتم باید خودش الگوها، ساختارها و روابط پنهان در داده را کشف کند. این روش زمانی استفاده میشود که نمیدانیم به دنبال چه چیزی هستیم و میخواهیم داده را بهتر بشناسیم.
یادگیری نظارتنشده نیز به چند دسته تقسیم میشود که مهمترینشان عبارتند از:
خوشهبندی (Clustering)
دادهها را بر اساس شباهتهایشان به گروههای مختلف (خوشهها) تقسیم میکند. مثلاً مشتریان یک فروشگاه را بر اساس رفتار خریدشان دستهبندی میکند.
کاهش ابعاد (Dimensionality Reduction)
تعداد ویژگیهای داده را کاهش میدهد در حالی که اطلاعات مهم را حفظ میکند. برای دادههای با ابعاد بالا مثل تصاویر بسیار کاربردی است.
یافتن قانونهای انجمنی (Association Rule Learning)
روابط بین اقلام مختلف را کشف میکند. مثلاً «کسانی که پوشک میخرند، معمولاً آبجو هم میخرند» (یک مثال کلاسیک در تحلیل سبد خرید).
کاربردهای واقعی یادگیری نظارتنشده
- بخشبندی مشتریان: گروهبندی مشتریان برای بازاریابی هدفمند.
- تشخیص ناهنجاری (Anomaly Detection): کشف تراکنشهای مشکوک بانکی یا خطاهای صنعتی.
- موتورهای پیشنهاددهنده: توصیه فیلم در نتفلیکس یا محصول در آمازون بر اساس شباهتها.
- فشردهسازی داده: کاهش حجم تصاویر و دادههای حجیم.
الگوریتمهای معروف این دسته شامل K-Means، خوشهبندی سلسلهمراتبی، DBSCAN، تحلیل مؤلفههای اصلی (PCA) و t-SNE هستند.
۳. یادگیری نیمهنظارتی (Semi-Supervised Learning)
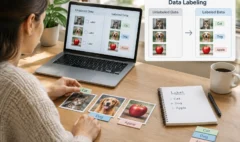
یادگیری نیمهنظارتی ترکیبی از دو روش قبلی است. در این روش، بخش کوچکی از دادهها برچسبخورده و بخش بزرگی بدون برچسب هستند. الگوریتم ابتدا از دادههای برچسبخورده یاد میگیرد و سپس از آن دانش برای برچسبگذاری دادههای بدون برچسب استفاده میکند.
این روش زمانی بسیار مفید است که برچسبگذاری دادهها هزینهبر و زمانبر باشد. مثلاً در پزشکی، تشخیص بیماری توسط متخصص برای هزاران تصویر بسیار گران است، اما با این روش میتوان با چند صد تصویر برچسبخورده، هزاران تصویر دیگر را بهطور خودکار برچسبگذاری کرد.
کاربردهای واقعی یادگیری نیمهنظارتی
- تشخیص گفتار: با مقدار کمی داده برچسبخورده صوتی.
- طبقهبندی متن: دستهبندی اسناد و مقالات با حداقل نمونههای برچسبخورده.
- تشخیص تصویر پزشکی: آموزش مدل با تعداد محدودی تصویر تشخیصدادهشده توسط پزشک.
- تشخیص ناهنجاری در شبکه: شناسایی حملات سایبری با استفاده از دادههای نیمهبرچسبخورده.
الگوریتمهای معروف این دسته شامل خودآموزی (Self-training)، همآموزی (Co-training) و روشهای مبتنی بر گراف (Graph-based methods) هستند.
۴. یادگیری تقویتی (Reinforcement Learning)
یادگیری تقویتی کاملاً با سه روش قبلی تفاوت دارد. در این روش، یک عامل (Agent) در یک محیط (Environment) قرار میگیرد و با انجام اقدامات (Actions) مختلف، پاداش (Reward) یا جریمه دریافت میکند. هدف عامل این است که با آزمون و خطا، استراتژی (Policy) بهینهای را پیدا کند که بیشترین پاداش را در طول زمان جمعآوری کند.
برای درک بهتر، یادگیری تقویتی شبیه به آموزش یک سگ است: وقتی کار درست را انجام میدهد، تشویق میشود و وقتی کار اشتباه میکند، تنبیه میشود. کمکم سگ یاد میگیرد که چه کارهایی پاداش دارند و چه کارهایی نه.
کاربردهای واقعی یادگیری تقویتی
- خودروهای خودران: یادگیری رانندگی در شرایط مختلف جاده.
- بازیهای کامپیوتری: شکست دادن بهترین بازیکنان جهان در شطرنج، گو و بازیهای ویدیویی (مانند AlphaGo و Dota 2).
- رباتیک: آموزش رباتها برای انجام کارهای پیچیده مانند راهرفتن یا مونتاژ.
- بهینهسازی سیستمهای انرژی: مدیریت مصرف انرژی در ساختمانهای هوشمند.
- معاملات مالی خودکار: تصمیمگیری برای خرید و فروش سهام در شرایط بازار.
الگوریتمهای معروف این دسته شامل Q-Learning، Deep Q-Network (DQN)، SARSA، و روشهای مبتنی بر Policy مانند PPO و A3C هستند.
جدول مقایسهای ۴ نوع یادگیری ماشین
| نوع یادگیری | نیاز به داده برچسبخورده | نظارت انسانی | کاربرد اصلی | مثال معروف |
|---|---|---|---|---|
| نظارتشده | بله، به مقدار زیاد | زیاد (برای برچسبزنی) | پیشبینی و طبقهبندی | تشخیص اسپم |
| نظارتنشده | خیر | کم | کشف الگو و خوشهبندی | بخشبندی مشتریان |
| نیمهنظارتی | مقدار کم | متوسط | هزینه برچسبزنی بالا | تشخیص تصویر پزشکی |
| تقویتی | خیر (از طریق تعامل) | بسیار کم | تصمیمگیری پیاپی | خودروهای خودران |
کدام نوع یادگیری برای پروژه شما مناسب است؟
انتخاب نوع مناسب یادگیری ماشین، یکی از مهمترین تصمیمهایی است که در یک پروژه دادهکاوی باید بگیرید. اینجا یک راهنمای ساده برای انتخاب داریم:
- اگر داده برچسبخورده دارید و میخواهید پیشبینی کنید: از یادگیری نظارتشده استفاده کنید.
- اگر داده بدون برچسب دارید و میخواهید الگو کشف کنید: سراغ یادگیری نظارتنشده بروید.
- اگر برچسبزنی داده بسیار گران است و فقط مقدار کمی داده برچسبخورده دارید: یادگیری نیمهنظارتی بهترین گزینه است.
- اگر مسئله شما شامل تصمیمگیری پیاپی در یک محیط پویاست: (مثل بازی، رباتیک یا خودروهای خودران) از یادگیری تقویتی استفاده کنید.
سؤالات متداول درباره یادگیری ماشین
هوش مصنوعی یک مفهوم کلی است که به هر سیستمی با رفتار هوشمندانه گفته میشود. یادگیری ماشین یکی از زیرمجموعههای هوش مصنوعی است که بر اساس داده و الگوریتم کار میکند، نه بر اساس قوانین دستنویس. برای مطالعه بیشتر، مقاله تفاوت هوش مصنوعی، یادگیری ماشین و یادگیری عمیق را ببینید.
تشخیص تصویر معمولاً با یادگیری نظارتشده و استفاده از شبکههای عصبی کانولوشنی (CNN) انجام میشود، زیرا به دادههای برچسبخورده (تصویر با برچسب شیء موجود در آن) نیاز دارد.
یادگیری تقویتی به داده تاریخی نیاز ندارد؛ بلکه از طریق تعامل با محیط و دریافت پاداش/جریمه، خودش داده تولید میکند و از آن یاد میگیرد. این تفاوت اساسی آن با سه روش دیگر است.
زمانی که برچسبزنی دادهها هزینهبر یا زمانبر است. مثلاً در پزشکی که تشخیص توسط متخصص برای هر تصویر هزینه دارد. با مقدار کمی داده برچسبخورده، میتوان دادههای بدون برچسب زیاد را بهخوبی دستهبندی کرد.
بله، در بسیاری از سیستمهای پیچیده مثل خودروهای خودران، رباتهای هوشمند و دستیارهای صوتی، از ترکیب چند نوع یادگیری ماشین بهطور همزمان استفاده میشود تا بهترین عملکرد ممکن حاصل شود.
جمعبندی
یادگیری ماشین دنیایی وسیع و هیجانانگیز است که هر روز کاربردهای جدیدی پیدا میکند. چهار دستهبندی اصلی آن – نظارتشده، نظارتنشده، نیمهنظارتی و تقویتی – هرکدام برای نوع خاصی از مسئله طراحی شدهاند و درک تفاوتهایشان، اولین قدم برای ورود به این حوزه است.
اگر تازه شروع کردهاید، پیشنهاد ما این است که با یادگیری نظارتشده شروع کنید؛ چون سادهترین و پرکاربردترین نوع است و منابع آموزشی فراوانی برای آن وجود دارد. سپس به تدریج سراغ سایر روشها بروید.
آیا تجربهای در استفاده از یادگیری ماشین دارید؟ کدام نوع را بیشتر دوست دارید؟ در بخش نظرات برایمان بنویسید.