Label چیست و چه زمانی به آن نیاز داریم؟ راهنمای کامل در یادگیری ماشین
Label چیست و چه زمانی به آن نیاز داریم؟ راهنمای کامل در یادگیری ماشین
Label چیست و چه زمانی به آن نیاز داریم؟
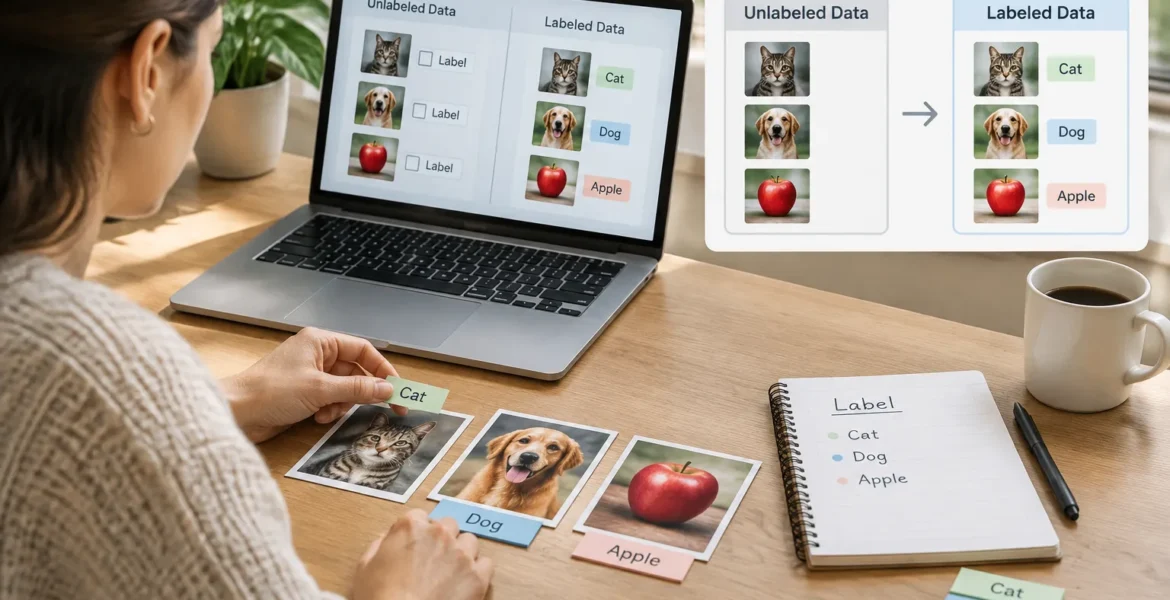
در بسیاری از پروژههای یادگیری ماشین، دادهها فقط شامل اطلاعاتی دربارهی هر نمونه نیستند؛ بلکه برای آموزش مدل باید مشخص باشد که پاسخ مورد انتظار برای هر نمونه چیست. این پاسخ که مدل قرار است آن را یاد بگیرد و برای دادههای جدید پیشبینی کند، معمولاً با نام Label یا «برچسب» شناخته میشود.
برای مثال، اگر هدف ساخت مدلی برای تشخیص ایمیلهای اسپم باشد، متن و سایر اطلاعات ایمیل میتوانند بهعنوان Feature در نظر گرفته شوند و مقدار «اسپم» یا «غیراسپم» نقش Label را داشته باشد. در یک مسئلهی پیشبینی قیمت خانه نیز قیمت واقعی خانه میتواند Label باشد.
در این مقاله، مفهوم Label، تفاوت آن با Feature و Target، انواع Label، منابع تولید Label، کیفیت برچسبها، Label Noise، Proxy Label و اشتباهات رایج دربارهی آن بررسی میشود.
در این مقاله چه چیزهایی یاد میگیرید؟
-
Label در یادگیری ماشین چیست و چه تفاوتی با Feature دارد؟ -
رابطهی Label با Target و تفاوت آن با Ground Truth و Annotation -
انواع Label؛ دودویی، چندکلاسه، چندبرچسبی و Regression -
Labelها از کجا به دست میآیند و Data Labeling چیست؟ -
Label Noise، Proxy Label و تأثیر کیفیت Label بر مدل -
چگونه Label مناسب برای یک Dataset انتخاب کنیم؟
فهرست مطالب
- Label در یادگیری ماشین چیست؟
- Feature و Label چه تفاوتی دارند؟
- Label و Target چه تفاوتی دارند؟
- نقش Label در یادگیری نظارتشده
- انواع Label در یادگیری ماشین
- Label در مسائل Regression
- آیا Label همیشه یک ستون در Dataset است؟
- Label از کجا به دست میآید؟
- Data Labeling چیست؟
- آیا هر Annotation یک Label است؟
- Ground Truth چیست؟
- آیا همیشه به Label نیاز داریم؟
- Label Noise چیست؟
- چرا کیفیت Label مهم است؟
- Proxy Label چیست؟
- Label Encoding چیست؟
- Label در Train، Validation و Test
- یک مثال کامل از Feature و Label
- از کجا بفهمیم یک متغیر باید Label باشد؟
- چند اشتباه رایج درباره Label
- Label خوب چه ویژگیهایی دارد؟
- Label چرا در یادگیری ماشین مهم است؟
- سوالات متداول
- جمعبندی
Label در یادگیری ماشین چیست؟
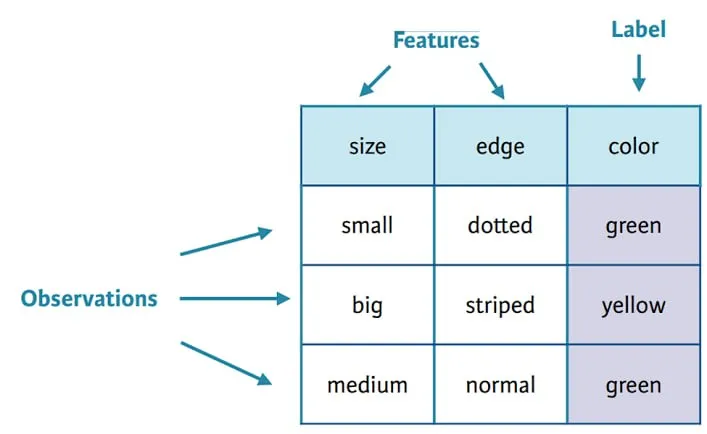
Label مقداری است که مشخص میکند پاسخ مورد انتظار برای یک نمونه چیست و مدل باید بتواند آن را پیشبینی کند.
فرض کنید مجموعهدادهای برای پیشبینی قبولی دانشجویان داریم:
| ساعت مطالعه | معدل | تعداد غیبت | نتیجه |
|---|---|---|---|
| 10 | 17.5 | 1 | قبول |
| 4 | 13.2 | 6 | مردود |
| 15 | 18.7 | 0 | قبول |
در این مثال:
- ساعت مطالعه یک Feature است.
- معدل یک Feature است.
- تعداد غیبت یک Feature است.
- «قبول» یا «مردود» Label است.
مدل با مشاهدهی نمونههای مختلف تلاش میکند رابطهای بین Featureها و Label پیدا کند تا بتواند برای یک دانشجوی جدید، نتیجهی احتمالی را پیشبینی کند.
به همین دلیل، در یک مسئلهی یادگیری نظارتشده، ساختار سادهی داده را میتوان به شکل زیر در نظر گرفت:
هنگام آموزش: Features + Label واقعی → Model Training
در منابع آموزشی Google نیز Label بهعنوان مقدار یا پاسخی تعریف میشود که مدل قصد دارد آن را از روی Featureها پیشبینی کند.
Feature و Label چه تفاوتی دارند؟
یکی از مهمترین مفاهیم برای درک Label، تشخیص تفاوت آن با Feature است.
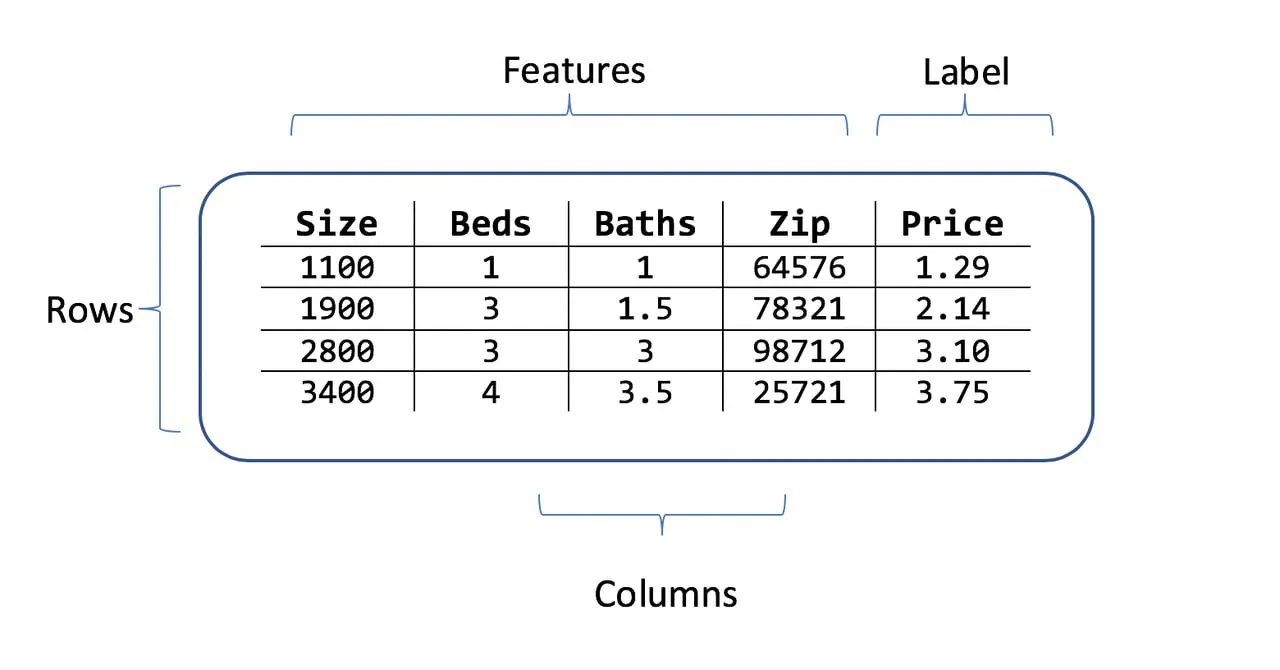
Feature اطلاعاتی است که مدل برای رسیدن به پیشبینی در اختیار دارد؛ در حالی که Label همان خروجی یا پاسخ مورد انتظار است که مدل باید آن را یاد بگیرد.
برای مثال، در پیشبینی قیمت خانه:
| متراژ | تعداد اتاق | سن ساختمان | موقعیت | قیمت |
|---|---|---|---|---|
| 120 | 3 | 5 | مرکز شهر | 8 میلیارد |
| 90 | 2 | 10 | شمال شهر | 6 میلیارد |
| 150 | 4 | 2 | مرکز شهر | 11 میلیارد |
در اینجا:
Featureها:
- متراژ
- تعداد اتاق
- سن ساختمان
- موقعیت
Label:
- قیمت خانه
بنابراین میتوان گفت:
این تفاوت بسیار مهم است، زیرا انتخاب اشتباه Feature و Label میتواند کل مسئلهی یادگیری ماشین را تغییر دهد.
Label و Target چه تفاوتی دارند؟
در بسیاری از منابع یادگیری ماشین، دو واژهی Label و Target تقریباً به یک معنا استفاده میشوند.
برای مثال، اگر هدف پیشبینی قیمت خانه باشد:
- Label = قیمت خانه
- Target = قیمت خانه
Google نیز در واژهنامهی یادگیری ماشین، Target را بهعنوان مترادف Label معرفی میکند.
با این حال، در کاربردهای عملی ممکن است تفاوت ظریفی در نحوهی استفاده از این دو واژه وجود داشته باشد.
Target بیشتر بر «متغیری که مسئله قصد پیشبینی آن را دارد» تأکید میکند، در حالی که Label معمولاً به مقدار پاسخ همراه یک نمونه اشاره دارد.
مثلاً اگر هدف مدل پیشبینی قیمت باشد:
- Target variable = Price
و برای یک خانهی مشخص:
- Label = 8 میلیارد تومان
این تفاوت همیشه در منابع رعایت نمیشود و در بسیاری از پروژهها این دو اصطلاح به جای یکدیگر استفاده میشوند.
Label چه نقشی در یادگیری نظارتشده دارد؟
Label یکی از عناصر اصلی Supervised Learning یا یادگیری نظارتشده است.
در یادگیری نظارتشده، مدل با نمونههایی آموزش داده میشود که پاسخ مورد انتظار آنها مشخص است.
برای مثال:
- ورودی: مشخصات یک ایمیل ← Label: اسپم
- ورودی: مشخصات یک خانه ← Label: قیمت خانه
- ورودی: سوابق مشتری ← Label: احتمال ترک سرویس
مدل با مقایسهی پیشبینی خود با Label واقعی، پارامترهای خود را در طول فرآیند آموزش تنظیم میکند.
بنابراین، میتوان فرآیند را به شکل ساده زیر تصور کرد:
سپس: Prediction ↔ Label واقعی
و اختلاف میان پیشبینی و مقدار واقعی، در فرآیند آموزش برای بهروزرسانی مدل مورد استفاده قرار میگیرد.
انواع Label در یادگیری ماشین
Label همیشه یک مقدار متنی مانند «بله» یا «خیر» نیست. نوع Label به مسئلهای که قصد حل آن را داریم بستگی دارد.
۱. Label دودویی یا Binary Label
در این حالت Label فقط دو مقدار ممکن دارد.
برای مثال:
- اسپم / غیر اسپم
- قبول / مردود
- بیمار / سالم
- تقلب / غیرتقلب
- خرید / عدم خرید
مثلاً:
| سن | درآمد | Label |
|---|---|---|
| 25 | 15 | خیر |
| 42 | 35 | بله |
| 31 | 22 | خیر |
در اینجا مسئله یک Binary Classification است.
۲. Label چندکلاسه یا Multi-Class
گاهی Label بیشتر از دو مقدار ممکن دارد.
مثلاً یک مدل تشخیص نوع خودرو ممکن است سه Label داشته باشد:
- خودرو
- موتورسیکلت
- کامیون
یا در تشخیص نوع گل:
- Setosa
- Versicolor
- Virginica
در این حالت هر نمونه فقط به یکی از کلاسهای تعریفشده تعلق دارد و مدل باید کلاس مناسب را پیشبینی کند.
۳. Label چندبرچسبی یا Multi-Label
در بعضی مسائل، یک نمونه میتواند همزمان چند Label داشته باشد.
برای مثال، یک تصویر ممکن است شامل:
- خودرو
- انسان
- دوچرخه
باشد.
در این حالت برخلاف Multi-Class، نمونه الزاماً فقط یک Label ندارد.
مثلاً:
| تصویر | Labelها |
|---|---|
| تصویر ۱ | خودرو، انسان |
| تصویر ۲ | خودرو |
| تصویر ۳ | انسان، دوچرخه |
این نوع مسئله با Multi-Class Classification یکسان نیست.
در Multi-Class معمولاً هر نمونه یکی از کلاسها را دریافت میکند؛ اما در Multi-Label یک نمونه میتواند چند برچسب داشته باشد.
Label در مسائل Regression چگونه است؟
Label فقط برای Classification نیست.
در Regression نیز یک Label داریم، اما این Label معمولاً یک مقدار عددی است.
برای مثال، اگر هدف پیشبینی مصرف برق یک خانه باشد:
| متراژ | تعداد ساکنان | دمای میانگین | مصرف برق |
|---|---|---|---|
| 100 | 3 | 24 | 320 |
| 140 | 4 | 27 | 450 |
| 80 | 2 | 22 | 240 |
در اینجا:
Featureها:
- متراژ
- تعداد ساکنان
- دمای میانگین
Label:
- مصرف برق
از آنجا که Label یک مقدار عددی است، مسئله در این مثال Regression است. بنابراین یک تصور اشتباه رایج این است که Label را فقط با «کلاس» یا «دسته» مرتبط بدانیم. Label میتواند یک کلاس، یک عدد یا حتی یک ساختار پیچیدهتر باشد.
آیا Label همیشه یک ستون در Dataset است؟
خیر.
در دادههای جدولی، Label معمولاً به شکل یک ستون مشخص دیده میشود؛ اما در دادههای تصویری، متنی، صوتی یا ویدئویی ممکن است ساختار متفاوتی داشته باشد.
برای مثال، در یک مسئلهی تشخیص اشیا در تصویر، Label ممکن است فقط نام یک کلاس نباشد و شامل اطلاعاتی دربارهی موقعیت شیء نیز باشد.
برای یک تصویر ممکن است اطلاعاتی مانند:
- نوع شیء
- مختصات Bounding Box
- ناحیهی مربوط به شیء
بهعنوان اطلاعات هدف ذخیره شود.
در مسائل Segmentation نیز ممکن است Label به شکل یک Mask ذخیره شود که مشخص میکند هر پیکسل متعلق به چه ناحیهای است.
بنابراین Label را نباید صرفاً «یک ستون آخر Dataset» در نظر گرفت.
مفهوم اصلی این است:
Label از کجا به دست میآید؟
یکی از سؤالهای مهم در پروژههای واقعی این است که:
چه کسی یا چه چیزی Label را تعیین میکند؟
Label میتواند از منابع مختلفی به دست بیاید.
- برچسبگذاری انسانی: در بسیاری از پروژهها، انسانها دادهها را بررسی و برچسبگذاری میکنند؛ مانند بررسی تصاویر پزشکی، تشخیص احساسات متن، شناسایی اشیاء در تصاویر، تشخیص اسپم بودن ایمیل یا طبقهبندی درخواستهای مشتریان. در این حالت متخصص یا Annotator مشخص میکند که هر نمونه چه Labelی داشته باشد.
- Labelهای موجود در دادههای واقعی: گاهی لازم نیست دادهها را از ابتدا بهصورت دستی Label کنیم. فرض کنید میخواهیم مدلی برای پیشبینی بازگشت مشتری بسازیم و سیستم شرکت از قبل ثبت کرده است که هر مشتری بعد از خرید آیا محصول را مرجوع کرده یا خیر. در این حالت، رویداد واقعی ثبتشده میتواند برای ساخت Label استفاده شود؛ مثلاً
Returned = Yes / No. - Label تولیدشده از قوانین یا سیستمهای دیگر: در برخی پروژهها، Label با استفاده از قوانین مشخص، سیستمهای موجود یا مدلهای دیگر ایجاد میشود. این نوع Labelها باید با دقت بررسی شوند، زیرا هر Label تولیدشده توسط یک فرآیند خودکار لزوماً معادل حقیقت قطعی نیست.
Data Labeling چیست؟
Data Labeling یا برچسبگذاری داده، فرآیندی است که طی آن برای دادههای خام، اطلاعات هدف یا برچسب مناسب تعیین میشود.
فرض کنید 100 هزار تصویر دارید، اما هیچکدام مشخص نمیکنند که تصویر مربوط به «گربه» است یا «سگ».
برای استفاده از این تصاویر در یک مسئلهی یادگیری نظارتشده، باید برای نمونههای آموزشی مشخص شود که هر تصویر متعلق به چه کلاس یا کلاسهایی است.
به این فرآیند Labeling یا Annotation گفته میشود.
در پروژههای بزرگ، ایجاد Dataset برچسبخورده میتواند بخش قابلتوجهی از زمان و هزینهی پروژه را به خود اختصاص دهد. AWS نیز در مستندات خود بر اهمیت وجود Targetهای مشخص در دادههای آموزشی و فرآیند ایجاد دادههای برچسبخورده تأکید میکند.
آیا هر Annotation یک Label است؟
این دو اصطلاح به هم نزدیکاند، اما کاملاً یکسان نیستند.
Annotation مفهوم گستردهتری دارد و به اطلاعاتی گفته میشود که به یک داده اضافه میشود تا معنای مشخصی پیدا کند.
برای مثال، در یک تصویر ممکن است Annotation شامل:
- نام شیء
- مختصات Bounding Box
- Mask
- ویژگیهای شیء
باشد.
اگر یکی از این اطلاعات بهعنوان خروجی موردنظر مدل استفاده شود، در آن مسئله میتواند نقش Label را پیدا کند.
بنابراین:
Label → اطلاعات هدفی که مدل باید یاد بگیرد یا پیشبینی کند
Ground Truth چیست؟
اصطلاح دیگری که معمولاً در کنار Label دیده میشود، Ground Truth است.
Ground Truth به داده یا پاسخی اشاره میکند که بهعنوان مرجع برای مقایسه و ارزیابی پیشبینی مدل در نظر گرفته میشود.
مثلاً فرض کنید یک مدل تشخیص بیماری برای یک بیمار میگوید:
- Prediction = بیمار
و نتیجهی ثبتشده توسط فرآیند مرجع:
- Ground Truth = سالم
در اینجا مدل اشتباه کرده است.
اما یک نکته مهم وجود دارد:
اگر Label توسط انسان اشتباه تعیین شده باشد یا فرآیند تولید Label دارای خطا باشد، دادهی مرجع نیز میتواند اشتباه باشد.
بنابراین عبارت «Ground Truth» نباید باعث شود تصور کنیم Label همیشه بدون خطا است.
آیا همیشه به Label نیاز داریم؟
خیر.
این یکی از مهمترین نکات دربارهی Label است.
در یادگیری نظارتشده، Label نقش اصلی دارد، زیرا مدل باید رابطهی بین Featureها و خروجی مشخص را یاد بگیرد.
اما همهی روشهای یادگیری ماشین به Labelهای دستی نیاز ندارند.
یادگیری بدون نظارت
در Unsupervised Learning مدل بدون داشتن Label از پیش تعیینشده تلاش میکند ساختار یا الگوهای موجود در داده را پیدا کند.
برای مثال، در Clustering ممکن است دادههای مشتریان را داشته باشیم اما از قبل ندانیم هر مشتری متعلق به چه گروهی است.
در اینجا میتوانیم از ویژگیهای مشتریان برای پیدا کردن گروههای مشابه استفاده کنیم، بدون اینکه یک Label مشخص مانند «مشتری وفادار» از قبل در Dataset وجود داشته باشد.
آیا در Semi-Supervised Learning به Label نیاز داریم؟
در Semi-Supervised Learning بخشی از دادهها Label دارند و بخشی دیگر بدون Label هستند.
مثلاً از 1000 نمونه داده:
- 100 نمونه → Labelدار
- 900 نمونه → بدون Label
مدل میتواند از هر دو بخش داده استفاده کند.
این روش زمانی اهمیت بیشتری پیدا میکند که جمعآوری داده آسان باشد اما برچسبگذاری آن دشوار، زمانبر یا پرهزینه باشد. Google نیز Semi-Supervised Learning را بهعنوان روشی برای آموزش با ترکیبی از نمونههای Labelدار و بدون Label تعریف میکند.
آیا Self-Supervised Learning بدون Label است؟
اینجا یک نکتهی ظریف وجود دارد.
در Self-Supervised Learning معمولاً Label انسانی از قبل وجود ندارد؛ اما مدل میتواند از خود داده یک Target یا Label مصنوعی ایجاد کند.
برای مثال، در یک متن میتوان بخشی از کلمات را پنهان کرد و از مدل خواست کلمهی اصلی را پیشبینی کند.
در این حالت:
بنابراین بهتر است نگوییم:
«Self-Supervised Learning هیچ Labelی ندارد.»
عبارت دقیقتر این است که:
«در Self-Supervised Learning، Target موردنیاز برای آموزش میتواند از خود داده ایجاد شود و الزاماً به Labelگذاری دستی انسان نیاز ندارد.»
Google نیز Self-Supervised Learning را شامل روشهایی میداند که از دادههای بدون برچسب، هدفهای جایگزین ایجاد میکنند.
Label Noise چیست؟
یکی از مهمترین مشکلات Datasetهای واقعی، Label Noise یا نویز در برچسبهاست.
فرض کنید تصویر یک گربه به اشتباه با Label «سگ» ذخیره شده باشد.
یا در یک Dataset پزشکی، نتیجهی یک بیمار به اشتباه ثبت شده باشد.
در چنین شرایطی، مدل اطلاعات نادرست را بهعنوان نمونهی آموزشی دریافت میکند.
مثلاً:
| Feature | Label واقعی | Label ثبتشده |
|---|---|---|
| تصویر گربه | گربه | سگ |
| تصویر سگ | سگ | سگ |
| تصویر گربه | گربه | گربه |
ردیف اول دارای Label اشتباه است.
اگر تعداد این خطاها زیاد شود، مدل ممکن است الگوهای نامناسبی را یاد بگیرد.
بنابراین:
چرا کیفیت Label مهم است؟
در یادگیری نظارتشده، Label همان پاسخی است که مدل تلاش میکند آن را پیشبینی کند.
اگر این پاسخها دارای خطا، تناقض یا ابهام باشند، مدل نیز با یک سیگنال آموزشی نامطمئن مواجه میشود.
مشکل میتواند از موارد مختلفی ناشی شود:
- خطای انسانی
- دستورالعمل نامشخص برای Annotatorها
- اختلاف نظر بین متخصصان
- تغییر تعریف کلاسها در طول زمان
- اشتباه در ثبت اطلاعات
- استفاده از یک معیار نامناسب برای ساخت Label
بنابراین فقط تعداد دادهها مهم نیست؛ کیفیت و سازگاری Labelها نیز اهمیت دارد.
اگر دو متخصص دربارهی Label اختلاف نظر داشته باشند چه میشود؟
این اتفاق در پروژههای واقعی کاملاً ممکن است.
فرض کنید دو متخصص باید یک تصویر پزشکی را بررسی کنند:
- متخصص اول: مثبت
- متخصص دوم: منفی
در چنین شرایطی نمیتوان بدون بررسی بیشتر فرض کرد که یکی از آنها حتماً درست و دیگری حتماً اشتباه است.
بسته به مسئله میتوان از روشهایی مانند:
- تعریف دستورالعمل دقیق Labelگذاری
- بررسی توسط متخصص سوم
- فرآیند داوری یا Adjudication
- ثبت میزان توافق بین Annotatorها
استفاده کرد.
در مسائل دارای ابهام، حتی ممکن است خودِ اختلاف نظر بخشی از اطلاعات ارزشمند Dataset باشد.
Proxy Label چیست؟
گاهی Label واقعی مستقیماً در Dataset وجود ندارد.
در این شرایط ممکن است از یک متغیر قابلاندازهگیری بهعنوان Proxy Label استفاده شود.
فرض کنید هدف واقعی ما پیشبینی «رضایت مشتری» باشد، اما اطلاعات مستقیمی دربارهی رضایت مشتری نداریم.
ممکن است تعداد شکایتها را بهعنوان یک شاخص جایگزین در نظر بگیریم.
اما این کار یک خطر دارد:
ممکن است تعداد شکایتها تحت تأثیر عوامل دیگری نیز باشد.
به همین دلیل، قبل از استفاده از Proxy Label باید بررسی شود که آیا این متغیر واقعاً نمایندهی مناسبی برای هدف اصلی است یا خیر. Google نیز Proxy Label را دادهای تعریف میکند که برای تقریب یک Label در دسترسنبوده استفاده میشود.
Label Encoding چیست و چه ارتباطی با Label دارد؟
گاهی Labelها متنی هستند:
- Yes / No
- Male / Female
- Cat / Dog
- Low / Medium / High
اما بسیاری از الگوریتمهای یادگیری ماشین برای کار با این مقادیر، به نمایش عددی نیاز دارند.
در این شرایط میتوان Label را به یک نمایش عددی تبدیل کرد.
مثلاً:
- No → 0
- Yes → 1
این فرآیند میتواند با روشهایی مانند Label Encoding انجام شود.
اما یک نکته مهم وجود دارد:
مثلاً اگر:
- Cat → 0
- Dog → 1
باشد، مقدار 1 به این معنا نیست که «Dog بیشتر» یا «بزرگتر» از Cat است.
در نتیجه باید بین Label بهعنوان مفهوم هدف و روش نمایش عددی Label تفاوت قائل شد.
آیا Label با ستون هدف در Dataset یکی است؟
در بسیاری از Datasetهای جدولی، بله.
برای مثال:
| Age | Income | Credit Score | Default |
|---|---|---|---|
| 25 | 20 | 710 | No |
| 43 | 45 | 650 | Yes |
| 31 | 28 | 730 | No |
اگر هدف پیشبینی Default باشد:
- Target Column = Default
و مقادیر این ستون:
- No / Yes
Labelهای نمونههای مختلف هستند.
اما در پروژههای پیچیدهتر، Target میتواند ساختار متفاوتی داشته باشد و الزاماً به یک ستون ساده محدود نشود.
Label در Train، Validation و Test چه نقشی دارد؟
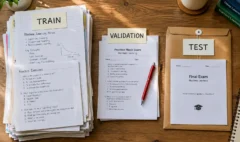
در یک پروژهی یادگیری نظارتشده معمولاً دادهها به بخشهایی مانند:
- Training
- Validation
- Test
تقسیم میشوند.
در مجموعهی Training، مدل Featureها و Labelهای واقعی را میبیند و از آنها یاد میگیرد.
در Validation، Label واقعی برای ارزیابی عملکرد و انتخاب تنظیمات مناسب استفاده میشود.
در Test نیز Label واقعی برای ارزیابی نهایی عملکرد مدل مورد نیاز است؛ اگرچه مدل نباید در فرآیند آموزش به Labelهای Test دسترسی داشته باشد.
به زبان ساده:
Validation → تنظیم و ارزیابی در فرآیند توسعه
Test → ارزیابی نهایی
بنابراین داشتن Label مناسب فقط برای آموزش مدل اهمیت ندارد؛ Labelهای معتبر برای ارزیابی مدل نیز ضروری هستند.
یک مثال کامل از Feature و Label
فرض کنید میخواهیم مدلی برای پیشبینی مصرف برق سالانهی یک خانه بسازیم.
Dataset میتواند به این شکل باشد:
| متراژ | تعداد ساکنان | میانگین دما | تعداد وسایل برقی | مصرف سالانه |
|---|---|---|---|---|
| 80 | 2 | 21 | 8 | 2400 |
| 120 | 4 | 25 | 12 | 4200 |
| 150 | 5 | 27 | 15 | 5700 |
در این مسئله:
Featureها:
- متراژ
- تعداد ساکنان
- میانگین دما
- تعداد وسایل برقی
Label:
- مصرف سالانه برق
مدل از نمونههای موجود یاد میگیرد که بین Featureها و مصرف برق چه رابطهای وجود دارد.
سپس اگر اطلاعات یک خانهی جدید را به مدل بدهیم:
| متراژ | تعداد ساکنان | میانگین دما | تعداد وسایل برقی |
|---|---|---|---|
| 110 | 3 | 24 | 10 |
مدل میتواند مقدار مصرف برق را پیشبینی کند.
در این مرحله، چون مقدار واقعی مصرف خانهی جدید هنوز مشخص نیست، این نمونه برای مدل یک Unlabeled Example است.
Google نیز در تعریف Labeled و Unlabeled Example دقیقاً بر همین تفاوت تأکید میکند: نمونهی Labelدار شامل Feature و Label است، در حالی که نمونهی بدون Label فقط Featureها را دارد.
از کجا بفهمیم یک متغیر باید Label باشد؟
برای انتخاب Label، ابتدا باید سؤال اصلی پروژه را مشخص کنیم.
به جای اینکه از Dataset شروع کنیم و بپرسیم:
«کدام ستون را Label قرار بدهم؟»
بهتر است ابتدا بپرسیم:
«مدل قرار است چه چیزی را پیشبینی کند؟»
برای مثال:
- هدف: تشخیص تقلب در تراکنشها ← Label = Fraud
- هدف: پیشبینی قیمت خانه ← Label = Price
- هدف: پیشبینی میزان مصرف برق ← Label = Energy Consumption
به عبارت دیگر، Label از هدف مسئله میآید، نه صرفاً از ساختار Dataset.
چند اشتباه رایج درباره Label
اشتباه اول: هر ستون Dataset میتواند Label باشد
از نظر فنی ممکن است چند متغیر مختلف را بتوان بهعنوان Target تعریف کرد، اما انتخاب Label باید بر اساس هدف واقعی مسئله انجام شود.
اشتباه دوم: Label همیشه یک مقدار متنی است
خیر. Label میتواند عدد، کلاس، چند کلاس، چند برچسب، محدوده یا مختصات، Mask یا ساختار دیگری باشد.
اشتباه سوم: Label همیشه Ground Truth مطلق است
خیر. Label ممکن است دارای خطا، ابهام یا سوگیری ناشی از فرآیند تولید داده باشد.
اشتباه چهارم: همهی الگوریتمهای یادگیری ماشین به Label نیاز دارند
خیر. یادگیری نظارتشده به Label نیاز دارد، اما روشهای بدون نظارت میتوانند بدون Label از پیش تعیینشده روی داده کار کنند. روشهای Self-Supervised نیز میتوانند Targetهای آموزشی را از خود داده ایجاد کنند.
اشتباه پنجم: Label و Prediction یکی هستند
این دو مفهوم دقیقاً برعکس نقش یکدیگر را دارند. Label پاسخ مورد انتظار یا مرجع موجود در داده است، اما Prediction پاسخی است که مدل تولید میکند. مثلاً Label = Spam و Prediction = Not Spam؛ در این نمونه مدل اشتباه کرده است.
Label خوب چه ویژگیهایی دارد؟
یک Label مناسب باید تا حد امکان با هدف واقعی مسئله هماهنگ باشد.
هنگام طراحی Dataset بهتر است موارد زیر مشخص باشند:
- تعریف دقیق Label: باید معلوم باشد هر Label دقیقاً چه معنایی دارد.
- دستورالعمل برچسبگذاری: اگر Labelها توسط انسان تولید میشوند، معیار تصمیمگیری باید مشخص باشد.
- سازگاری: نمونههای مشابه باید تا حد امکان Labelهای سازگار دریافت کنند.
- قابلیت ارزیابی: باید مشخص باشد که چگونه میتوان Label را بررسی و اعتبارسنجی کرد.
- ارتباط با هدف واقعی: Label باید تا حد امکان همان خروجیای را نشان دهد که مدل در دنیای واقعی برای آن ساخته میشود.
- توجه به تغییرات زمانی: اگر تعریف یا فرآیند تولید Label در طول زمان تغییر کند، Dataset نیز ممکن است دچار ناسازگاری شود.
Label چرا در یادگیری ماشین مهم است؟
اگر Featureها را اطلاعاتی بدانیم که مدل در اختیار دارد، Label همان چیزی است که به مدل میگوید:
بدون این پاسخ، در یک مسئلهی معمولی Supervised Learning مشخص نیست مدل باید دقیقاً چه خروجیای را پیشبینی کند.
به همین دلیل، کیفیت Label میتواند روی کل فرآیند یادگیری اثر بگذارد:
این موضوع بهخصوص در پروژههایی مهم است که Labelگذاری بهصورت دستی انجام میشود یا تعریف خروجی دارای ابهام است.
سوالات متداول درباره Label
تفاوت Label و Feature چیست؟
آیا Label و Target با هم تفاوت دارند؟
آیا همیشه به Label نیاز داریم؟
آیا Label همیشه Ground Truth مطلق است؟
Label Noise چیست و چه تأثیری دارد؟
Proxy Label چیست؟
Label Encoding چه ارتباطی با Label دارد؟
چگونه بفهمیم کدام متغیر باید Label باشد؟
جمعبندی
Label یکی از مفاهیم بنیادی یادگیری ماشین است و به مقدار یا پاسخ هدفی اشاره دارد که مدل باید آن را از روی Featureها یاد بگیرد و برای نمونههای جدید پیشبینی کند.
در یک Dataset ساده:
Label = خروجی مورد انتظار
Label میتواند در مسائل مختلف شکلهای متفاوتی داشته باشد؛ از یک مقدار دودویی مانند «بله/خیر» گرفته تا چند کلاس، مقدار عددی در Regression یا ساختارهای پیچیدهتر در مسائل تصویری.
Label نقش اصلی را در Supervised Learning دارد، اما همهی روشهای یادگیری ماشین به Labelهای دستی نیاز ندارند. در Unsupervised Learning مدل میتواند بدون Label مشخص به دنبال ساختارهای موجود در داده باشد و در Self-Supervised Learning نیز Target آموزشی میتواند از خود داده ایجاد شود.
از طرف دیگر، داشتن Label بهتنهایی کافی نیست. کیفیت، سازگاری و ارتباط Label با هدف واقعی مسئله اهمیت زیادی دارد. Label اشتباه یا نامناسب میتواند باعث شود مدل الگوهایی را یاد بگیرد که با هدف واقعی پروژه سازگار نیستند.
در نهایت، برای تشخیص اینکه چه چیزی باید Label باشد، بهترین سؤال این نیست که:
«کدام ستون Dataset را Label قرار بدهم؟»
بلکه باید پرسید:
پاسخ این سؤال معمولاً نقطهی شروع تعیین Label در یک مسئلهی یادگیری ماشین است.
اگر تجربهای از تعیین Label در پروژههای یادگیری ماشین دارید یا سؤالی درباره تفاوت Label با Feature و Target برایتان پیش آمده، آن را در کامنت بنویسید. کدام بخش از فرآیند انتخاب و تولید Label برای شما چالشبرانگیزتر بوده است؟