یادگیری نظارت شده چیست؟ از مفهوم و انواع تا الگوریتمها و کاربردها
یادگیری نظارت شده چیست؟
یادگیری ماشین یکی از مهمترین شاخههای هوش مصنوعی است که به سیستمها اجازه میدهد بدون برنامهنویسی مستقیم برای تکتک تصمیمها، از دادهها الگو یاد بگیرند. در میان روشهای مختلف یادگیری ماشین، یادگیری نظارت شده (Supervised Learning) پرکاربردترین و پایهایترین روش است.
بسیاری از مسائل واقعی مانند تشخیص ایمیلهای اسپم، پیشبینی قیمت خانه، تشخیص بیماری، اعتبارسنجی مشتریان و پیشبینی فروش با استفاده از این روش حل میشوند.
اما یادگیری نظارت شده دقیقاً چیست؟ چگونه کار میکند؟ چه تفاوتی با یادگیری بدون نظارت دارد؟ چه الگوریتمهایی در آن استفاده میشوند و چه زمانی باید از آن استفاده کنیم؟
در این راهنما از رهیارا، این مفاهیم را مرحلهبهمرحله بررسی میکنیم.
در این مقاله چه چیزهایی یاد میگیرید؟
-
یادگیری نظارت شده دقیقاً چیست و چگونه کار میکند؟ -
تفاوت Classification و Regression در یادگیری نظارت شده -
مهمترین الگوریتمهای Supervised Learning را بشناسید -
تفاوت یادگیری نظارت شده با بدون نظارت و تقویتی
فهرست مطالب
- یادگیری نظارت شده چیست؟
- یادگیری نظارت شده چگونه کار میکند؟
- داده برچسبدار چیست؟
- اجزای اصلی یادگیری نظارت شده
- انواع مسائل: Classification و Regression
- الگوریتمهای مهم یادگیری نظارت شده
- یک مثال ساده از یادگیری نظارت شده
- تفاوت یادگیری نظارت شده و بدون نظارت
- تفاوت یادگیری نظارت شده و تقویتی
- کاربردهای یادگیری نظارت شده
- مزایا و محدودیتها
- چه زمانی از یادگیری نظارت شده استفاده کنیم؟
- سؤالات متداول
- جمعبندی
یادگیری نظارت شده چیست؟
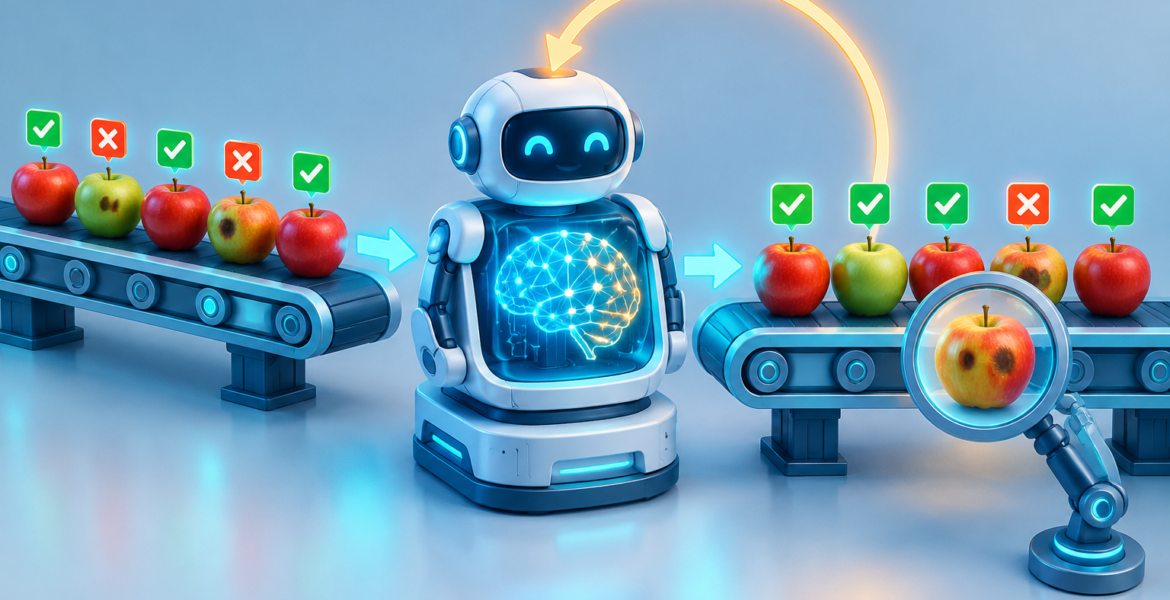
یادگیری نظارت شده (Supervised Learning) یکی از روشهای اصلی یادگیری ماشین است که در آن مدل با استفاده از دادههای دارای برچسب (Labeled Data) آموزش داده میشود.
به زبان ساده، در یادگیری نظارت شده، علاوه بر اطلاعات ورودی، پاسخ صحیح یا همان خروجی مورد انتظار نیز در اختیار مدل قرار میگیرد.
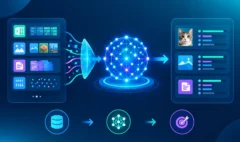
مدل با مشاهدهی نمونههای مختلف تلاش میکند رابطهای میان ورودیها و خروجیهای صحیح پیدا کند و سپس از این رابطه برای پیشبینی نمونههای جدید استفاده کند.
برای مثال، فرض کنید میخواهیم مدلی بسازیم که قیمت خانه را پیشبینی کند. برای آموزش مدل، اطلاعاتی مانند متراژ خانه، تعداد اتاقها، سن ساختمان، موقعیت مکانی و تعداد پارکینگ را در اختیار آن قرار میدهیم. در کنار این اطلاعات، قیمت واقعی خانه نیز مشخص است.
مدل با بررسی تعداد زیادی خانه یاد میگیرد که چگونه ویژگیهای خانه با قیمت آن ارتباط دارند. سپس اگر اطلاعات یک خانهی جدید را به مدل بدهیم، مدل میتواند قیمت آن را پیشبینی کند.
بهصورت ساده:
ورودیها ← مدل یادگیری ماشین ← خروجی پیشبینیشده
بنابراین مهمترین ویژگی یادگیری نظارت شده این است که در زمان آموزش، پاسخ صحیح نمونههای آموزشی را در اختیار داریم.
یادگیری نظارت شده چگونه کار میکند؟
فرآیند یادگیری نظارت شده را میتوان در چند مرحله خلاصه کرد.
مرحله ۱: جمعآوری داده
ابتدا دادههای مربوط به مسئله موردنظر جمعآوری میشوند. برای مثال، اگر هدف پیشبینی قیمت خانه باشد، میتوان اطلاعات هزاران خانه را جمعآوری کرد.
مرحله ۲: مشخص کردن ویژگیها و برچسب
دادهها معمولاً از دو بخش اصلی تشکیل میشوند:
- ویژگیها (Features): اطلاعاتی که مدل از آنها برای پیشبینی استفاده میکند.
- برچسب (Label/Target): پاسخ صحیحی که میخواهیم مدل آن را پیشبینی کند.
مثلاً:
| متراژ | تعداد اتاق | سن ساختمان | قیمت |
|---|---|---|---|
| 80 | 2 | 10 | 4 میلیارد |
| 120 | 3 | 5 | 7 میلیارد |
| 150 | 3 | 2 | 9 میلیارد |
در اینجا متراژ، تعداد اتاق و سن ساختمان Features و قیمت Target است.
مرحله ۳: آموزش مدل
دادههای آموزشی در اختیار الگوریتم قرار میگیرند. مدل تلاش میکند رابطهای بین ویژگیهای ورودی و خروجی واقعی پیدا کند.
مرحله ۴: ارزیابی مدل
پس از آموزش، مدل روی دادههایی که در فرآیند آموزش استفاده نشدهاند آزمایش میشود. هدف این است که ببینیم مدل تا چه اندازه میتواند روی دادههای جدید عملکرد مناسبی داشته باشد.
مرحله ۵: پیشبینی دادههای جدید
در نهایت، مدل میتواند برای نمونههایی که پاسخ آنها را نمیدانیم، خروجی پیشبینی کند.
داده برچسبدار چیست؟
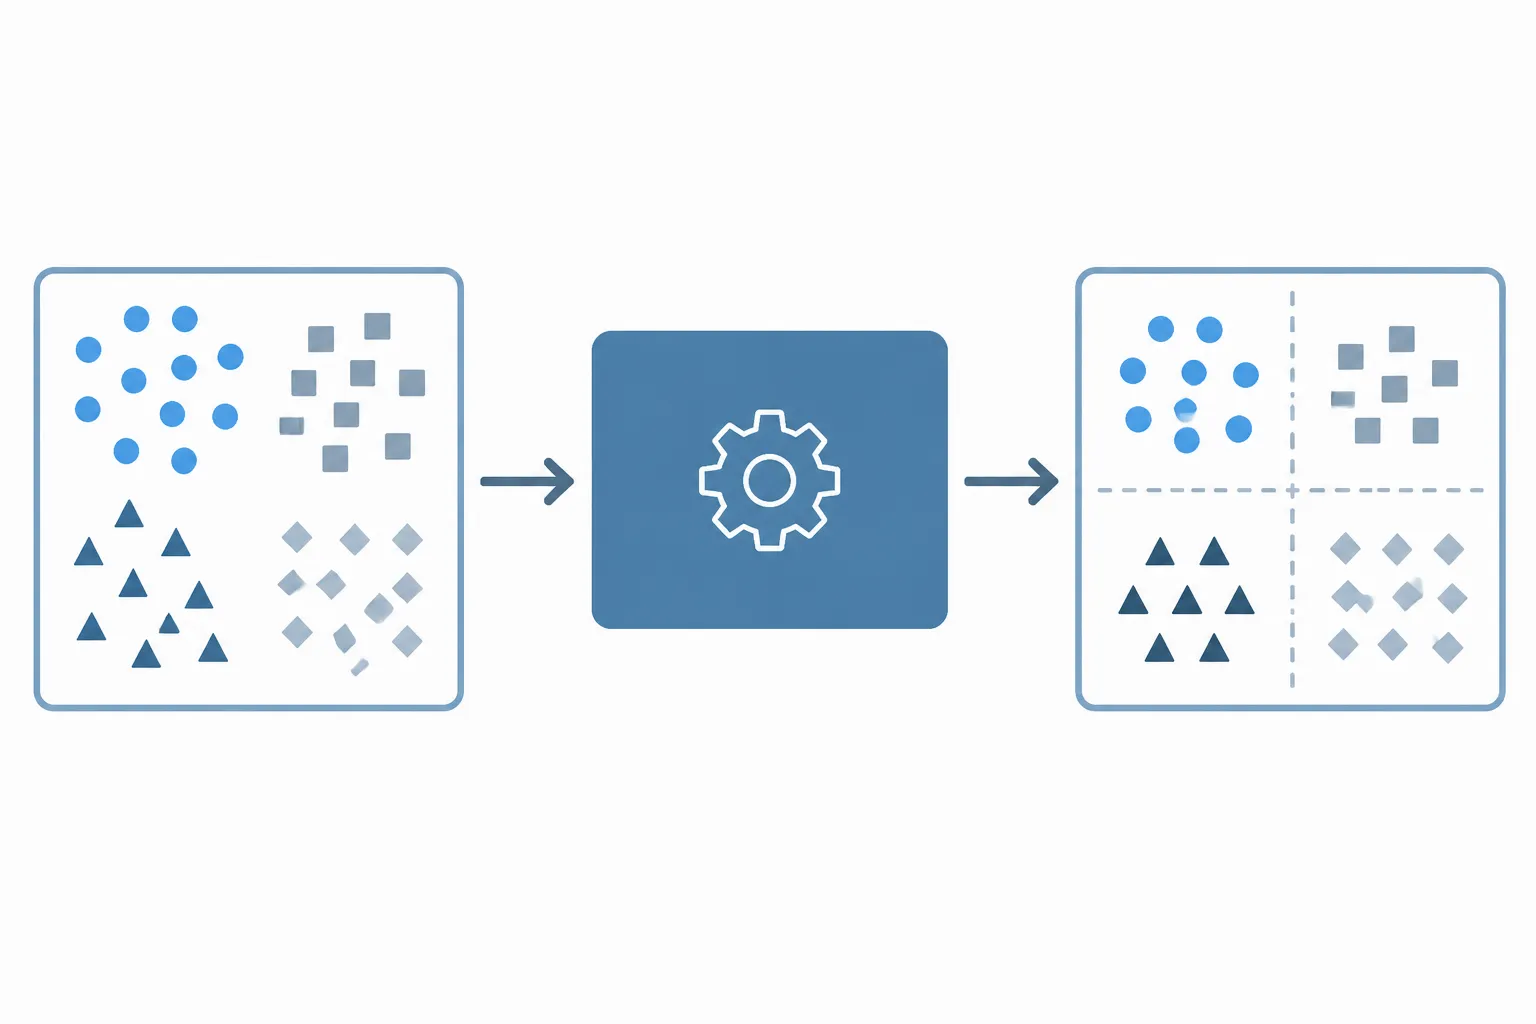
مفهوم برچسب یا Label یکی از مهمترین مفاهیم در یادگیری نظارت شده است. فرض کنید مجموعهای از ایمیلها داریم و میخواهیم مشخص کنیم هر ایمیل اسپم است یا غیراسپم.
در این حالت:
- متن ایمیل و ویژگیهای آن ← ورودی
- اسپم یا غیراسپم ← برچسب
مثلاً:
| متن ایمیل | برچسب |
|---|---|
| برنده جایزه شدید | Spam |
| جلسه فردا ساعت ۱۰ برگزار میشود | Not Spam |
| برای دریافت جایزه کلیک کنید | Spam |
مدل با مشاهدهی این نمونههای برچسبدار، الگوهای مرتبط با هر کلاس را یاد میگیرد. پس اگر یک ایمیل جدید وارد شود، مدل میتواند احتمال اسپم بودن آن را پیشبینی کند.
اجزای اصلی یادگیری نظارت شده
یک مسئله یادگیری نظارت شده معمولاً شامل اجزای زیر است:
- دادههای ورودی: اطلاعاتی که مدل بر اساس آنها تصمیمگیری میکند.
- ویژگیها: متغیرهایی که نماینده خصوصیات هر نمونه هستند.
- برچسب یا Target: مقداری که مدل باید یاد بگیرد آن را پیشبینی کند.
- الگوریتم یادگیری: روشی که برای پیدا کردن رابطه میان ورودی و خروجی استفاده میشود.
- تابع خطا: اختلاف میان مقدار واقعی و مقدار پیشبینیشده را اندازهگیری میکند.
- مدل آموزشدیده: مدلی که پس از یادگیری الگوهای موجود در داده آماده پیشبینی نمونههای جدید است.
انواع مسائل در یادگیری نظارت شده
مسائل یادگیری نظارت شده را میتوان به دو گروه اصلی تقسیم کرد:
- Classification یا طبقهبندی
- Regression یا رگرسیون
طبقهبندی یا Classification چیست؟
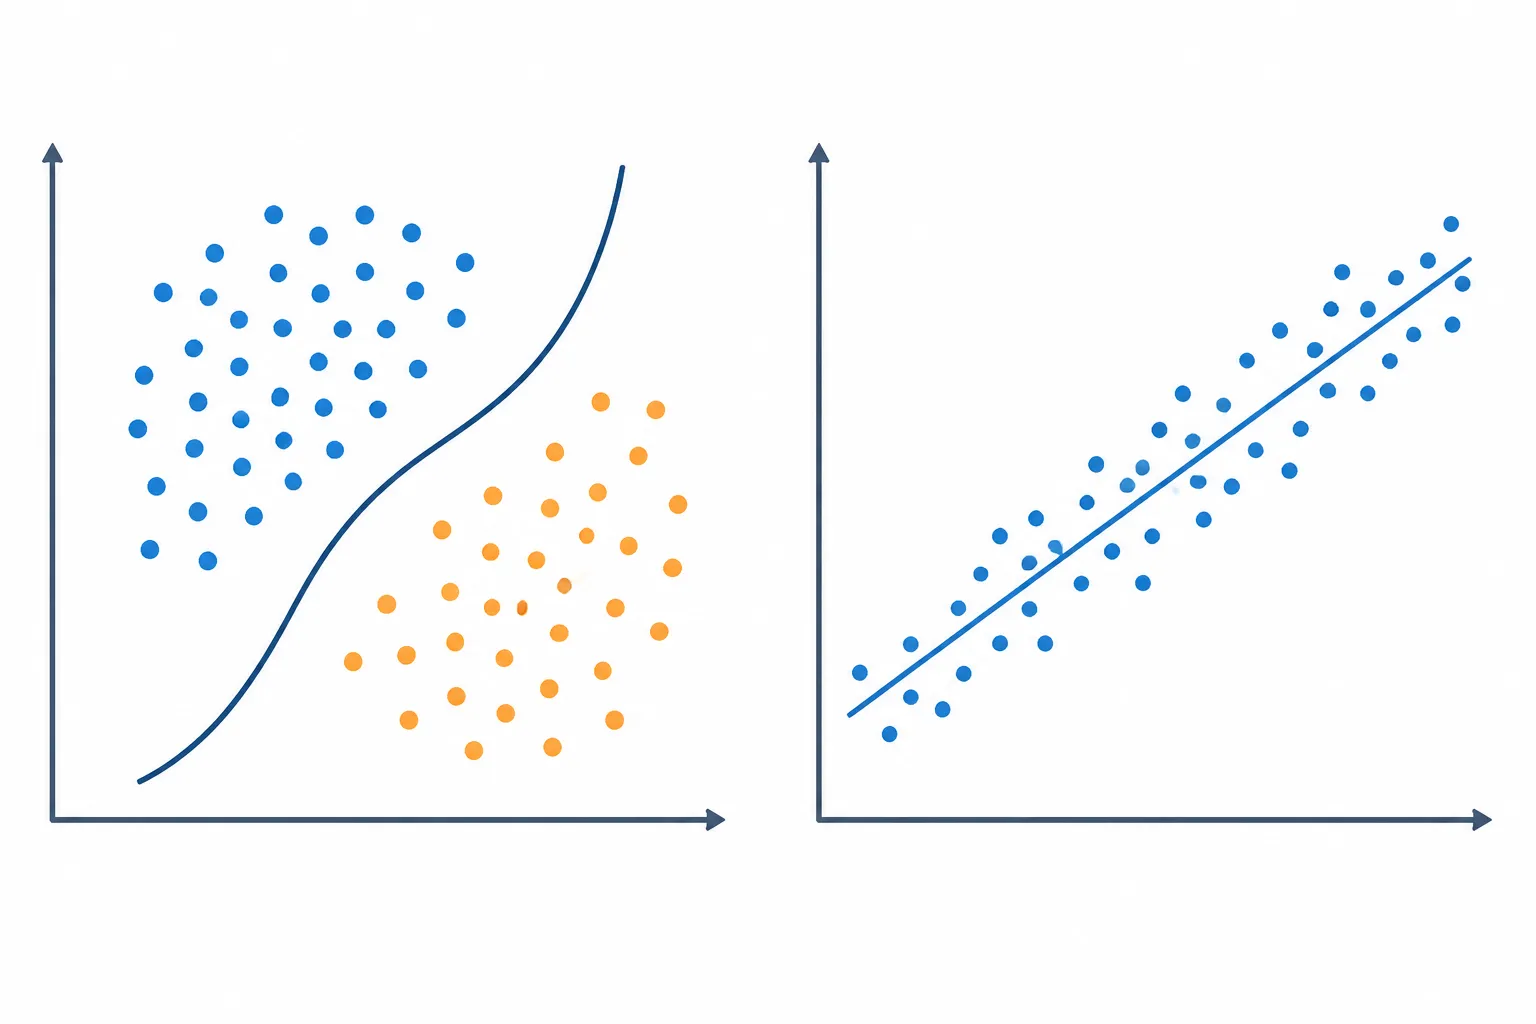
در Classification هدف این است که مدل یک نمونه را در یکی از کلاسهای مشخص قرار دهد. مثالها: تشخیص اسپم یا غیر اسپم، تشخیص بیمار یا سالم، تشخیص تقلبی یا واقعی بودن تراکنش، تشخیص نوع گل، تشخیص احساس مثبت یا منفی در متن.
در این مسائل خروجی معمولاً یک کلاس یا دسته است.
طبقهبندی دودویی: اگر فقط دو کلاس داشته باشیم، مسئله Binary Classification نام دارد. مثلاً بیمار/سالم یا اسپم/غیر اسپم.
طبقهبندی چندکلاسه: اگر بیش از دو کلاس داشته باشیم، مسئله Multiclass Classification است. مثلاً تشخیص نوع حیوان: گربه، سگ، اسب، پرنده.
طبقهبندی چندبرچسبی: در Multilabel Classification یک نمونه میتواند همزمان چند برچسب داشته باشد. برای مثال، یک تصویر ممکن است همزمان شامل سگ + خودرو + انسان باشد.
رگرسیون یا Regression چیست؟
در رگرسیون، هدف پیشبینی یک مقدار عددی است. مثالها: پیشبینی قیمت خانه، پیشبینی فروش ماه آینده، پیشبینی دمای هوا، پیشبینی مدت زمان یک فرآیند، پیشبینی میزان مصرف انرژی.
بنابراین یک تفاوت ساده میان این دو نوع مسئله:
| نوع مسئله | نوع خروجی | مثال |
|---|---|---|
| Classification | کلاس یا دسته | اسپم / غیر اسپم |
| Regression | مقدار عددی | قیمت خانه |
مهمترین الگوریتمهای یادگیری نظارت شده
الگوریتمهای متعددی برای حل مسائل یادگیری نظارت شده وجود دارند. مهمترین آنها عبارتاند از:
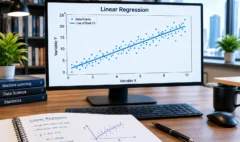
رگرسیون خطی (Linear Regression)
یکی از سادهترین الگوریتمها برای مسائل رگرسیون است. این الگوریتم تلاش میکند رابطهای میان متغیرهای ورودی و یک خروجی عددی پیدا کند.
رگرسیون لجستیک (Logistic Regression)
با وجود نام آن، یکی از الگوریتمهای رایج Classification است و بهخصوص در مسائل طبقهبندی دودویی کاربرد زیادی دارد.
درخت تصمیم (Decision Tree)
مدل با ایجاد مجموعهای از تصمیمها یا شرطها، دادهها را به گروههای مختلف تقسیم میکند. مزیت مهم درخت تصمیم این است که منطق تصمیمگیری آن نسبتاً قابل تفسیر است.
جنگل تصادفی (Random Forest)
Random Forest مجموعهای از چندین درخت تصمیم است که با ترکیب خروجی آنها، پیشبینی نهایی را انجام میدهد. این روش معمولاً نسبت به یک درخت تصمیم منفرد پایداری و قدرت تعمیم بیشتری دارد.
ماشین بردار پشتیبان (SVM)
Support Vector Machine تلاش میکند مرزی مناسب برای جداسازی کلاسها پیدا کند و در مسائل مختلف طبقهبندی کاربرد دارد.
K-Nearest Neighbors
در روش KNN، مدل برای پیشبینی یک نمونه جدید به نمونههای نزدیک به آن در دادههای آموزشی توجه میکند.
شبکههای عصبی مصنوعی
شبکههای عصبی با استفاده از لایهها و نورونهای متعدد میتوانند روابط پیچیده میان ورودی و خروجی را یاد بگیرند. این روشها بهویژه در مسائل پیچیده مانند پردازش تصویر، صوت و زبان کاربرد گستردهای دارند.
الگوریتمهای Boosting
روشهایی مانند XGBoost، LightGBM و CatBoost با ترکیب مدلهای ضعیفتر، یک مدل قدرتمند ایجاد میکنند و در بسیاری از مسائل دادهمحور عملکرد بسیار خوبی دارند.
یک مثال ساده از یادگیری نظارت شده
فرض کنید یک فروشگاه اینترنتی میخواهد احتمال خرید یک محصول توسط مشتری را پیشبینی کند. برای هر مشتری اطلاعاتی مانند سن، تعداد خریدهای قبلی، مبلغ خریدهای قبلی، تعداد دفعات ورود به سایت و مدت زمان حضور در سایت در اختیار داریم. همچنین میدانیم که هر مشتری در نهایت محصول را خریده یا نخریده است.
بنابراین:
- Features = اطلاعات مشتری
- Label = خرید / عدم خرید
مدل با استفاده از مشتریان قبلی آموزش میبیند و سپس میتواند برای یک مشتری جدید احتمال خرید را پیشبینی کند. این دقیقاً یک مسئله یادگیری نظارت شده است.
تفاوت یادگیری نظارت شده و بدون نظارت
یکی از مهمترین تفاوتها در یادگیری ماشین، تفاوت میان Supervised Learning و Unsupervised Learning است. در یادگیری نظارت شده، دادهها دارای برچسب هستند. اما در یادگیری بدون نظارت، مدل با دادههایی مواجه میشود که پاسخ صحیح یا برچسب مشخصی برای آنها وجود ندارد.
برای مثال، اگر اطلاعات مشتریان یک فروشگاه را داشته باشیم: در یادگیری نظارت شده ممکن است بخواهیم پیشبینی کنیم کدام مشتری خرید خواهد کرد. اما در یادگیری بدون نظارت ممکن است بخواهیم مشتریان را بر اساس رفتارشان گروهبندی کنیم.
بهصورت خلاصه:
| ویژگی | یادگیری نظارت شده | یادگیری بدون نظارت |
|---|---|---|
| برچسب | دارد | ندارد |
| هدف | پیشبینی خروجی | کشف الگو |
| نمونه مسئله | تشخیص بیماری | گروهبندی بیماران |
| خروجی | معمولاً مشخص و هدفدار | ساختار کشفشده از داده |
تفاوت یادگیری نظارت شده و یادگیری تقویتی
یادگیری تقویتی یا Reinforcement Learning نیز با یادگیری نظارت شده تفاوت اساسی دارد. در یادگیری نظارت شده، مدل نمونههایی را مشاهده میکند که پاسخ صحیح آنها مشخص است. اما در یادگیری تقویتی، یک عامل (Agent) با یک محیط تعامل میکند و بر اساس نتیجه اقدامات خود پاداش یا جریمه دریافت میکند.
مثلاً در یک بازی:
Agent ← Action ← Environment ← Reward
بنابراین در یادگیری تقویتی لزوماً برای هر وضعیت، پاسخ صحیح از قبل در اختیار مدل قرار ندارد.
کاربردهای یادگیری نظارت شده
یادگیری نظارت شده در حوزههای مختلف کاربرد دارد.
پزشکی
- تشخیص بیماری
- پیشبینی ریسک بیماری
- تحلیل تصاویر پزشکی
- پیشبینی پاسخ بیمار به درمان
مالی
- تشخیص تقلب
- اعتبارسنجی مشتریان
- پیشبینی ریسک اعتباری
- پیشبینی قیمت یا بازده
بازاریابی
- پیشبینی رفتار مشتری
- پیشبینی ریزش مشتری
- دستهبندی مشتریان
- پیشبینی احتمال خرید
تجارت الکترونیک
- پیشنهاد محصول
- پیشبینی فروش
- تشخیص تراکنشهای مشکوک
- پیشبینی تقاضا
پردازش زبان طبیعی
- تشخیص احساسات
- طبقهبندی متن
- تشخیص اسپم
- دستهبندی اسناد
بینایی ماشین
- تشخیص اشیا
- طبقهبندی تصاویر
- تشخیص چهره
- تشخیص عیوب محصولات
مزایا و محدودیتهای یادگیری نظارت شده
مزایا
- قابلیت پیشبینی: هدف اصلی بسیاری از مسائل یادگیری نظارت شده، پیشبینی خروجی برای دادههای جدید است.
- ارزیابی نسبتاً مشخص: از آنجا که پاسخ صحیح دادههای آزمون مشخص است، میتوان عملکرد مدل را با معیارهای مختلف اندازهگیری کرد.
- کاربردهای گسترده: این روش در پزشکی، مالی، بازاریابی، صنعت، حملونقل و بسیاری از حوزههای دیگر کاربرد دارد.
- وجود الگوریتمهای متنوع: از مدلهای ساده مانند Linear Regression تا مدلهای پیچیده مانند شبکههای عصبی و الگوریتمهای Boosting میتوان استفاده کرد.
محدودیتها
- نیاز به دادههای برچسبدار: مهمترین چالش، تهیه دادههای دارای برچسب است. در بسیاری از پروژهها، برچسبگذاری دادهها به زمان، هزینه و نیروی انسانی زیادی نیاز دارد.
- کیفیت برچسبها: اگر برچسبهای آموزشی اشتباه یا ناسازگار باشند، مدل نیز ممکن است الگوهای اشتباه را یاد بگیرد.
- وابستگی به داده آموزشی: عملکرد مدل تا حد زیادی به کیفیت و نمایندگی دادههای آموزشی بستگی دارد.
- خطر Overfitting: اگر مدل بیش از حد پیچیده باشد یا فرآیند آموزش بهدرستی کنترل نشود، احتمال Overfitting افزایش پیدا میکند.
- سوگیری داده: اگر دادههای آموزشی دارای Bias باشند، مدل نیز ممکن است همان سوگیریها را در پیشبینیهای خود منعکس کند.
چه زمانی از یادگیری نظارت شده استفاده کنیم؟
یک سؤال مهم این است که آیا هر مسئله یادگیری ماشین را باید با Supervised Learning حل کنیم؟ خیر. یادگیری نظارت شده زمانی گزینه مناسبی است که:
- داده کافی در اختیار داشته باشیم؛
- برای نمونههای آموزشی برچسب مشخص داشته باشیم؛
- هدف مشخصی برای پیشبینی وجود داشته باشد؛
- بخواهیم مقدار یا کلاس یک نمونه جدید را پیشبینی کنیم؛
- بتوانیم عملکرد مدل را با یک معیار مشخص ارزیابی کنیم.
برای مثال اگر هدف شما این باشد که «با توجه به مشخصات مشتری، احتمال خرید او را پیشبینی کنم» یادگیری نظارت شده انتخاب مناسبی است. اما اگر هدف شما این باشد که «بدون داشتن برچسب، گروههای مختلف مشتریان را کشف کنم» احتمالاً باید به سراغ روشهای یادگیری بدون نظارت بروید.
سؤالات متداول درباره یادگیری نظارت شده
یادگیری نظارت شده روشی از یادگیری ماشین است که در آن مدل با استفاده از دادههای دارای برچسب (Labeled Data) آموزش میبیند و یاد میگیرد برای ورودیهای جدید خروجی مناسب پیشبینی کند.
در Classification خروجی یک کلاس یا دسته است (مثلاً اسپم/غیراسپم)، اما در Regression خروجی یک مقدار عددی پیوسته است (مثلاً قیمت خانه).
داده برچسبدار دادهای است که علاوه بر ویژگیها، پاسخ صحیح یا خروجی مورد انتظار نیز در آن مشخص است. مثلاً در تشخیص اسپم، برچسب «اسپم» یا «غیراسپم» برای هر ایمیل موجود است.
در یادگیری نظارت شده دادهها برچسب دارند و هدف پیشبینی خروجی است، اما در یادگیری بدون نظارت دادهها برچسب ندارند و هدف کشف الگوها یا ساختارهای پنهان در داده است.
خیر. یادگیری نظارت شده هم برای مسائل طبقهبندی (Classification) و هم برای مسائل رگرسیون (Regression) استفاده میشود.
زمانی که دادههای برچسبدار کافی داریم و هدف مشخصی برای پیشبینی (کلاس یا عدد) وجود دارد، یادگیری نظارت شده گزینه مناسبی است.
جمعبندی
یادگیری نظارت شده یا Supervised Learning یکی از مهمترین روشهای یادگیری ماشین است که در آن مدل با استفاده از دادههای دارای برچسب آموزش میبیند. مدل با مشاهدهی رابطه میان ورودیها (Features) و خروجی صحیح (Label/Target) تلاش میکند الگوی موجود در دادهها را یاد بگیرد و سپس از این الگو برای پیشبینی نمونههای جدید استفاده کند.
دو نوع اصلی مسئله در یادگیری نظارت شده عبارتاند از:
- Classification ← پیشبینی یک کلاس یا دسته
- Regression ← پیشبینی یک مقدار عددی
الگوریتمهایی مانند Linear Regression، Logistic Regression، Decision Tree، Random Forest، SVM، KNN، Boosting و Neural Networks از مهمترین روشهایی هستند که برای حل این مسائل استفاده میشوند.
با این حال، ساخت یک مدل خوب تنها به انتخاب الگوریتم محدود نمیشود. کیفیت داده، نحوه تقسیم دادهها، انتخاب ویژگیها، جلوگیری از Overfitting و انتخاب معیار ارزیابی مناسب نیز نقش مهمی در موفقیت مدل دارند.
برای درک جایگاه این روش در تصویر بزرگتر هوش مصنوعی و یادگیری ماشین، میتوانید مقالات زیر را مطالعه کنید:
پژوهش موفق، ترکیبی از ابزارهای هوشمند و تفکر نقادانه است.