Model در Machine Learning چیست؟ آشنایی کامل با مدل در یادگیری ماشین
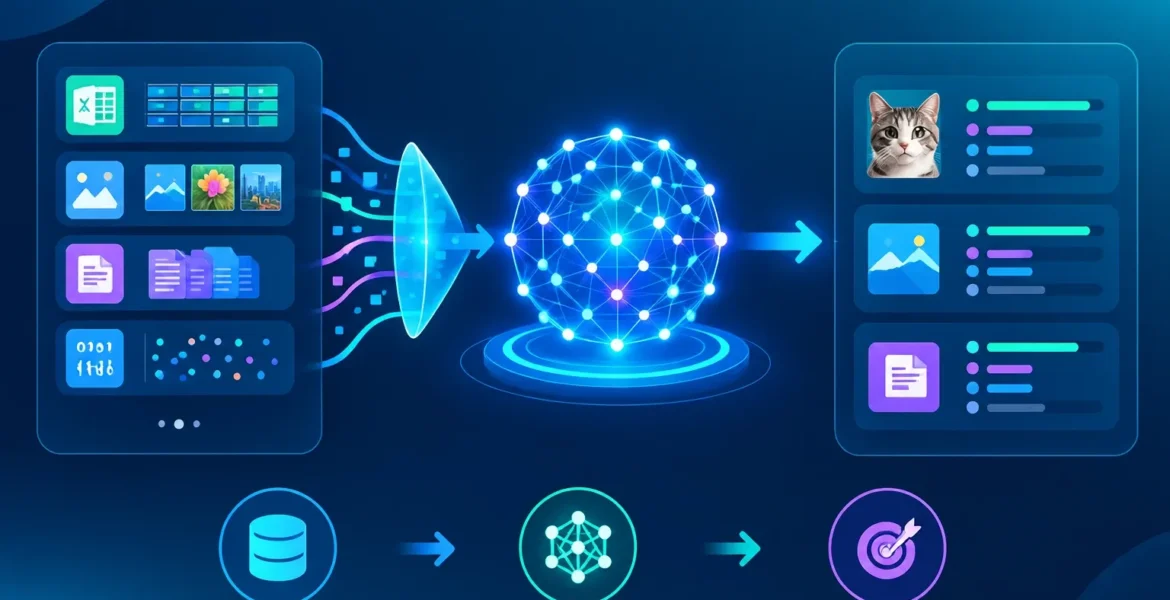
Model در Machine Learning چیست؟ آشنایی کامل با مدل در یادگیری ماشین
Model در Machine Learning دقیقاً چیست؟
وقتی دربارهی یادگیری ماشین صحبت میکنیم، معمولاً با واژههایی مثل Dataset، Algorithm، Training، Feature، Label و Model روبهرو میشویم. اما یکی از مهمترین مفاهیمی که گاهی بهسادگی از کنار آن عبور میکنیم، خود Model یا مدل یادگیری ماشین است.
مدل دقیقاً چیست؟ آیا همان الگوریتم است؟ آیا مدل همان دادههای آموزشی است؟ وقتی میگوییم یک مدل «یاد گرفته»، دقیقاً چه چیزی در آن تغییر کرده است؟
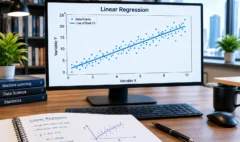
برای مثال، اگر دادههایی از قیمت خانهها داشته باشیم و بخواهیم قیمت یک خانهی جدید را پیشبینی کنیم، الگوریتمی مانند Linear Regression میتواند برای یادگیری رابطهی بین ویژگیها و قیمت استفاده شود. اما چیزی که پس از فرایند آموزش به دست میآید و میتواند برای پیشبینی دادههای جدید استفاده شود، Model است.
در این مقاله، مفهوم Model در Machine Learning را از پایه بررسی میکنیم و تفاوت آن را با Dataset، Algorithm، Parameter و Hyperparameter توضیح میدهیم.
در این مقاله چه چیزهایی یاد میگیرید؟
- Model در Machine Learning چیست؟
- تفاوت Model با Algorithm و Dataset چیست؟
- Parameter و Hyperparameter چه تفاوتی دارند؟
- Training و Inference چه تفاوتی دارند و مدل چگونه ذخیره و استفاده میشود؟
فهرست مطالب
- Model در Machine Learning چیست؟
- یک مثال ساده برای درک مفهوم Model
- مدل دقیقاً چه چیزی را یاد میگیرد؟
- تفاوت Model و Algorithm چیست؟
- تفاوت Model و Dataset چیست؟
- Parameter در مدل چیست؟
- Hyperparameter چیست؟
- فرایند تبدیل داده به Model
- Training چیست؟
- Inference یا Prediction چیست؟
- مدل چگونه روی دادههای جدید کار میکند؟
- Model در Classification و Regression
- ارتباط Model با Overfitting و Underfitting
- آیا مدل همیشه یک فرمول ریاضی است؟
- مدل را چگونه ذخیره و استفاده میکنیم؟
- یک مثال کامل از ابتدا تا انتها
- اشتباهات رایج درباره مفهوم Model
- ارتباط Model، Algorithm، Dataset و Prediction
- سؤالات متداول
- جمعبندی
Model در Machine Learning چیست؟
Model یا مدل یادگیری ماشین، یک ساختار یادگرفتهشده از دادههای آموزشی است که میتواند برای پیشبینی، طبقهبندی، تخمین یا کشف الگو در دادههای جدید استفاده شود.
به زبان سادهتر، مدل نتیجهی فرایند یادگیری از دادههاست.
فرض کنید مجموعهای از اطلاعات مربوط به خانههای مختلف را در اختیار داریم:
| متراژ | تعداد اتاق | سن ساختمان | قیمت |
|---|---|---|---|
| 80 | 2 | 8 | 4 میلیارد |
| 100 | 2 | 5 | 5 میلیارد |
| 120 | 3 | 4 | 6.5 میلیارد |
| 150 | 3 | 2 | 8 میلیارد |
در این مثال:
- متراژ، تعداد اتاق و سن ساختمان Feature هستند.
- قیمت خانه Target است.
- دادههای موجود، Training Dataset را تشکیل میدهند.
- الگوریتم یادگیری، رابطهی بین ویژگیها و قیمت را پیدا میکند.
- نتیجهی یادگیری این رابطه، Model است.
حالا اگر اطلاعات یک خانهی جدید را به مدل بدهیم، مدل میتواند قیمت احتمالی آن را پیشبینی کند.
بنابراین میتوان این فرایند را به شکل ساده زیر در نظر گرفت:
مدل در واقع چیزی است که از مرحلهی آموزش باقی میماند و میتوان از آن برای کار روی دادههای جدید استفاده کرد.
یک مثال ساده برای درک مفهوم Model
برای درک بهتر، یک مثال بسیار ساده را در نظر بگیرید.
فرض کنید میخواهیم ایمیلها را به دو گروه تقسیم کنیم:
- Spam
- Not Spam
برای آموزش مدل، هزاران ایمیل قبلی داریم که مشخص شده کدام Spam بوده و کدام Spam نبوده است.
الگوریتم یادگیری ماشین با استفاده از این دادهها الگوهایی را پیدا میکند که بین ویژگیهای ایمیل و برچسب آن ارتباط دارند.
پس از پایان آموزش، دیگر لازم نیست هر ایمیل را بهصورت دستی بررسی کنیم.
ایمیل جدید وارد مدل میشود:
در اینجا، چیزی که تصمیم میگیرد ایمیل جدید در کدام گروه قرار بگیرد، مدل آموزشدیده است.
نکتهی مهم این است که مدل فقط نمونههای آموزشی را حفظ نمیکند؛ هدف این است که الگوهای موجود در داده را یاد بگیرد تا بتواند روی نمونههای جدید نیز عملکرد مناسبی داشته باشد.
مدل دقیقاً چه چیزی را یاد میگیرد؟
یکی از پرسشهای مهم این است که وقتی میگوییم «مدل از داده یاد میگیرد»، منظور دقیقاً چیست؟
مدل معمولاً تلاش میکند رابطه یا الگوی موجود بین ورودیها و خروجی موردنظر را پیدا کند.
برای مثال، در یک مسئلهی پیشبینی قیمت خانه، مدل ممکن است یاد بگیرد که:
- افزایش متراژ معمولاً با افزایش قیمت همراه است.
- سن ساختمان ممکن است با قیمت رابطه داشته باشد.
- تعداد اتاقها میتواند در قیمت مؤثر باشد.
اما مدل الزاماً این روابط را به شکل جملات انسانی ذخیره نمیکند.
در بسیاری از الگوریتمها، یادگیری به معنای پیدا کردن مقادیری از Parameters است که باعث میشوند مدل روی دادههای آموزشی عملکرد مناسبی داشته باشد.
برای مثال، در یک مدل رگرسیون خطی ساده:
مقادیر \(w_1\)، \(w_2\) و \(b\) در فرایند آموزش یاد گرفته میشوند.
بنابراین میتوان گفت:
البته این موضوع در همهی الگوریتمها دقیقاً به همین شکل نیست، اما ایدهی کلی مشابه است: الگوریتم فرایند یادگیری را انجام میدهد و مدلِ آموزشدیده شامل ساختار و مقادیر لازم برای انجام پیشبینی یا تصمیمگیری است.
تفاوت Model و Algorithm چیست؟
یکی از رایجترین اشتباهات در یادگیری ماشین، یکی دانستن Algorithm و Model است.
این دو مفهوم مرتبطاند اما یکسان نیستند.
Algorithm چیست؟
Algorithm یا الگوریتم، روش یا فرایندی است که برای یادگیری الگو از داده استفاده میشود.
برای مثال:
- Linear Regression
- Decision Tree
- K-Nearest Neighbors
- Support Vector Machine
- Random Forest
همگی الگوریتمهای یادگیری ماشین هستند.
Model چیست؟
مدل، نتیجهی استفاده از یک الگوریتم روی دادههای آموزشی است.
برای مثال، الگوریتم Decision Tree را در نظر بگیرید.
الگوریتم تعیین میکند چگونه یک درخت از دادهها ساخته شود. وقتی این الگوریتم روی یک Dataset مشخص آموزش داده میشود، یک درخت آموزشدیده به دست میآید که میتواند برای پیشبینی دادههای جدید استفاده شود.
بنابراین:
Model = نتیجهی یادگیری با استفاده از آن روش
یک الگوریتم میتواند روی Datasetهای مختلف آموزش داده شود و مدلهای متفاوتی ایجاد کند.
تفاوت Model و Dataset چیست؟
Dataset مجموعهای از دادههاست؛ در حالی که Model ساختاری است که از دادهها یاد گرفته است.
برای مثال، فرض کنید ۱۰ هزار رکورد مربوط به مشتریان یک فروشگاه داریم.
این ۱۰ هزار رکورد، Dataset هستند.
اگر از این دادهها برای آموزش یک مدل پیشبینی ریزش مشتری استفاده کنیم، خروجی آموزش یک Model خواهد بود.
بهصورت ساده:
بنابراین مدل را نباید با دادههای آموزشی یکی دانست.
ممکن است مدل پس از آموزش دیگر به Dataset کامل نیاز نداشته باشد و فقط پارامترها و ساختار یادگرفتهشده را برای پیشبینیهای جدید استفاده کند.
Parameter در مدل چیست؟
Parameter مقداری است که مدل در فرایند آموزش آن را از دادهها یاد میگیرد.
برای مثال، در رگرسیون خطی:
مقادیر:
پارامترهای مدل هستند.
مدل با بررسی دادههای آموزشی، این مقادیر را به گونهای تعیین میکند که خطای پیشبینی کاهش پیدا کند.
بنابراین یک نکتهی مهم:
تعداد و نوع پارامترها به الگوریتم و ساختار مدل بستگی دارد.
Hyperparameter چیست؟
Hyperparameter مقداری است که معمولاً قبل یا در جریان فرایند آموزش توسط کاربر یا یک روش تنظیم پارامترها تعیین میشود و مستقیماً مانند Parameter از دادهها یاد گرفته نمیشود.
برای مثال، در بعضی الگوریتمها مواردی مانند:
- تعداد درختها
- عمق درخت
- مقدار \(k\) در KNN
- مقدار \(C\) در SVM
- Learning Rate در شبکههای عصبی
میتوانند Hyperparameter باشند.
تفاوت را میتوان اینگونه خلاصه کرد:
| مفهوم | چگونه تعیین میشود؟ |
|---|---|
| Parameter | از دادهها در فرایند آموزش یاد گرفته میشود |
| Hyperparameter | معمولاً قبل از آموزش یا با فرایند تنظیم مدل تعیین میشود |
برای مثال، در Random Forest، تعداد درختها میتواند یک Hyperparameter باشد، در حالی که ساختار و مقادیر مربوط به درختهای آموزشدیده بخشی از مدل یادگرفتهشده هستند.
فرایند تبدیل داده به Model
برای ساخت یک مدل معمولاً چند مرحله طی میشود.
فرایند کلی را میتوان به شکل زیر نمایش داد:
ابتدا داده جمعآوری میشود.
سپس داده در صورت نیاز پاکسازی و آمادهسازی میشود؛ برای مثال، مقادیر گمشده، دادههای پرت یا متغیرهای دستهای ممکن است نیاز به پردازش داشته باشند.
بعد یک الگوریتم مناسب انتخاب میشود.
الگوریتم روی دادههای آموزشی اجرا میشود و پارامترهای مدل را یاد میگیرد.
در نهایت، مدل آموزشدیده برای پیشبینی دادههای جدید استفاده میشود.
انتخاب روش یادگیری نیز به ماهیت مسئله و نوع داده بستگی دارد. برای آشنایی با تفاوت یادگیری نظارتشده، نظارتنشده، نیمهنظارتی و تقویتی میتوانید مقاله زیر را مطالعه کنید:
Training چیست؟
Training یا آموزش، فرایندی است که طی آن مدل با استفاده از دادههای آموزشی، الگوهای موردنیاز برای انجام وظیفهی خود را یاد میگیرد.
فرض کنید مسئله، پیشبینی قیمت خانه باشد.
در طول آموزش:
- دادهی ورودی به مدل داده میشود.
- مدل یک پیشبینی تولید میکند.
- پیشبینی با مقدار واقعی مقایسه میشود.
- میزان خطا محاسبه میشود.
- پارامترهای مدل در صورت نیاز تغییر میکنند.
- این فرایند تا رسیدن به وضعیت مناسب ادامه پیدا میکند.
در بسیاری از الگوریتمها، مفهوم Loss Function یا تابع زیان نیز برای اندازهگیری میزان خطا استفاده میشود.
به شکل ساده:
هدف Training این است که مدل بتواند الگوی مناسبی را از دادهها یاد بگیرد؛ نه اینکه صرفاً نمونههای آموزشی را حفظ کند.
Inference یا Prediction چیست؟
بعد از Training، مدل آمادهی استفاده روی دادههای جدید است.
فرایند استفاده از مدل آموزشدیده برای تولید خروجی را میتوان Inference یا در بسیاری از مسائل Prediction نامید.
برای مثال:
سپس:
فرض کنید یک مدل برای تشخیص اسپم آموزش دادهایم.
وقتی یک ایمیل جدید وارد سیستم میشود، مدل بدون اینکه دوباره از ابتدا آموزش ببیند، خروجی خود را تولید میکند.
این مرحله با Training متفاوت است.
در Training، مدل پارامترهای خود را یاد میگیرد.
در Inference، مدل از اطلاعاتی که قبلاً یاد گرفته برای پردازش دادهی جدید استفاده میکند.
مدل چگونه روی دادههای جدید کار میکند؟
هدف اصلی یک مدل یادگیری ماشین، فقط عملکرد مناسب روی دادههای آموزشی نیست.
اگر مدلی روی دادههای آموزشی بسیار خوب عمل کند اما روی دادههای جدید عملکرد ضعیفی داشته باشد، ارزش عملی آن محدود خواهد بود.
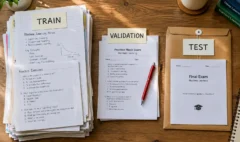
به همین دلیل معمولاً دادهها به بخشهایی مانند:
- Training Set
- Validation Set
- Test Set
تقسیم میشوند.
Training Set برای یادگیری مدل استفاده میشود.
Validation Set میتواند برای انتخاب یا تنظیم مدل به کار رود.
Test Set نیز برای ارزیابی عملکرد مدل روی دادههایی که در فرایند آموزش استفاده نشدهاند، مورد استفاده قرار میگیرد.
این موضوع با مفهوم Generalization ارتباط مستقیم دارد.
Generalization یعنی مدل بتواند الگوهای یادگرفتهشده را به دادههای جدید نیز تعمیم دهد.
Model در Classification و Regression
مدلهای یادگیری ماشین بسته به نوع مسئله میتوانند وظایف متفاوتی انجام دهند.
Classification
در Classification هدف، پیشبینی یک کلاس یا دسته است.
برای مثال:
- Spam / Not Spam
- بیمار / سالم
- تقلب / غیرتقلب
- قبولی / عدم قبولی
مدل در این حالت خروجی را به یک یا چند کلاس اختصاص میدهد.
Regression
در Regression هدف، پیشبینی یک مقدار عددی است.
برای مثال:
- قیمت خانه
- میزان مصرف انرژی
- دما
- فروش ماه آینده
بنابراین تفاوت اصلی در اینجا به نوع خروجی مسئله مربوط میشود.
ارتباط Model با Overfitting و Underfitting
کیفیت یک مدل فقط به این بستگی ندارد که روی دادههای آموزشی چقدر خوب عمل میکند.
یکی از مفاهیم مهم در ارزیابی مدل، Overfitting است.
Overfitting چیست؟
در Overfitting، مدل بیش از حد به ویژگیهای خاص دادههای آموزشی وابسته میشود و در نتیجه ممکن است روی دادههای جدید عملکرد مناسبی نداشته باشد.
برای مثال، فرض کنید یک مدل روی دادههای آموزشی دقت بسیار بالایی دارد، اما وقتی دادههای جدید وارد آن میشوند، خطای زیادی ایجاد میکند.
در این حالت ممکن است مدل بیش از حد دادههای آموزشی را یاد گرفته باشد.
Underfitting چیست؟
در Underfitting، مدل به اندازهی کافی الگوی موجود در داده را یاد نمیگیرد.
در نتیجه ممکن است هم روی دادههای آموزشی و هم روی دادههای جدید عملکرد ضعیفی داشته باشد.
بنابراین میتوان گفت یکی از اهداف اصلی فرایند مدلسازی، رسیدن به مدلی است که بتواند بین یادگیری الگوهای واقعی داده و تعمیم به دادههای جدید تعادل مناسبی برقرار کند.
آیا مدل همیشه یک فرمول ریاضی است؟
خیر.
این تصور که هر Model حتماً یک فرمول سادهی ریاضی است، اشتباه است.
نوع ساختار مدل به الگوریتم مورد استفاده بستگی دارد.
برای مثال:
Linear Regression
مدل میتواند به شکل یک رابطهی ریاضی نمایش داده شود:
Decision Tree
مدل میتواند مجموعهای از قوانین و تقسیمبندیهای سلسلهمراتبی باشد.
Random Forest
مدل شامل مجموعهای از درختهای تصمیم است که با یکدیگر برای تولید خروجی استفاده میشوند.
Neural Network
مدل شامل لایهها، وزنها و پارامترهای متعدد است که رابطهی پیچیدهای بین ورودی و خروجی ایجاد میکنند.
بنابراین:
مدل را چگونه ذخیره و استفاده میکنیم؟
پس از آموزش، معمولاً نمیخواهیم هر بار مدل را از ابتدا آموزش دهیم.
به همین دلیل، مدل آموزشدیده میتواند در قالبی مناسب ذخیره شود.
برای مثال، در یک پروژهی واقعی ممکن است فرایند به این شکل باشد:
مدل ذخیرهشده میتواند بعداً در یک برنامه، وبسایت، API یا سیستم تصمیمگیری مورد استفاده قرار گیرد.
برای مثال، فرض کنید یک شرکت مدلی برای پیشبینی ریزش مشتری ساخته است.
پس از آموزش مدل، میتوان آن را در یک سیستم عملیاتی قرار داد تا اطلاعات مشتری جدید را دریافت کند و احتمال ریزش او را پیشبینی کند.
بنابراین Model فقط یک مفهوم تئوری نیست؛ بلکه میتواند به بخشی از یک سیستم نرمافزاری یا تصمیمگیری واقعی تبدیل شود.
یک مثال کامل از ابتدا تا انتها
فرض کنید یک فروشگاه اینترنتی میخواهد احتمال خرید مشتری را پیشبینی کند.
دادههای قبلی مشتریان شامل موارد زیر است:
- سن
- تعداد بازدید از سایت
- تعداد محصولات مشاهدهشده
- سابقه خرید
- زمان سپریشده در سایت
- خرید نهایی
در این مثال:
Features:
سن، تعداد بازدید، تعداد محصولات مشاهدهشده و زمان حضور در سایت
Target:
خرید یا عدم خرید
ابتدا دادهها آماده میشوند.
سپس یک الگوریتم یادگیری ماشین، مثلاً Decision Tree، انتخاب میشود.
الگوریتم روی دادههای آموزشی اجرا میشود.
درخت تصمیم از دادهها الگوهایی را یاد میگیرد.
برای مثال ممکن است مدل به ساختاری برسد که به شکل مفهومی بیان کند:
- اگر تعداد بازدید زیاد باشد، احتمال خرید بیشتر است.
- اگر سابقه خرید وجود داشته باشد، احتمال خرید تغییر میکند.
- ترکیب چند ویژگی میتواند به تصمیم نهایی منجر شود.
این ساختار یادگرفتهشده، Model است.
حالا اگر مشتری جدیدی وارد سایت شود، اطلاعات او به مدل داده میشود:
مدل میتواند خروجی موردنظر را تولید کند.
نکته مهم این است که مدل جدید برای هر مشتری از ابتدا ساخته نمیشود؛ بلکه همان مدل آموزشدیده برای نمونههای جدید مورد استفاده قرار میگیرد.
اشتباهات رایج درباره مفهوم Model
۱. Model همان Algorithm است
خیر. Algorithm روش یادگیری است و Model نتیجهی آموزش با استفاده از آن روش است.
۲. Model همان Dataset است
خیر. Dataset دادههایی است که برای یادگیری یا ارزیابی استفاده میشوند؛ Model ساختار و اطلاعات یادگرفتهشده از دادهها را در خود دارد.
۳. Model همیشه یک فرمول است
خیر. مدل میتواند درخت تصمیم، مجموعهای از درختها، شبکه عصبی، ماشین بردار پشتیبان یا ساختارهای دیگر باشد.
۴. مدل فقط روی دادههای آموزشی استفاده میشود
خیر. هدف اصلی مدل این است که بتواند روی دادههای جدید نیز عملکرد مناسبی داشته باشد.
۵. هرچه مدل پیچیدهتر باشد، بهتر است
لزومی ندارد. پیچیدگی بیشتر میتواند قدرت مدل را افزایش دهد، اما ممکن است خطر Overfitting را نیز افزایش دهد. انتخاب مدل باید با توجه به مسئله، داده، هدف، محدودیتها و معیار ارزیابی انجام شود.
۶. Training و Prediction یک فرایند هستند
این دو مرحله متفاوتاند. در Training، مدل یاد میگیرد. در Prediction یا Inference، مدل آموزشدیده برای تولید خروجی روی دادههای جدید استفاده میشود.
Model، Algorithm، Dataset و Prediction چه ارتباطی با هم دارند؟
برای اینکه کل مفهوم را یکجا ببینیم:
- Dataset — دادههایی که در اختیار داریم.
- Algorithm — روش مورد استفاده برای یادگیری از دادهها.
- Training — فرایند یادگیری الگو و پارامترها.
- Model — نتیجهی آموزش.
- New Data — دادهی جدید.
- Prediction — خروجی تولیدشده توسط مدل.
این زنجیره یکی از سادهترین راهها برای درک جایگاه Model در یک پروژهی یادگیری ماشین است.
سؤالات متداول درباره Model در Machine Learning
آیا Model همان هوش مصنوعی است؟
آیا یک Algorithm میتواند چند Model بسازد؟
آیا Model بدون Dataset ساخته میشود؟
آیا مدل بعد از Training ثابت میماند؟
آیا مدل باید حتماً قابل تفسیر باشد؟
آیا یک مدل فقط برای یک مسئله قابل استفاده است؟
جمعبندی
Model یکی از مفاهیم بنیادی در Machine Learning است.
مدل را میتوان نتیجهی فرایند یادگیری از دادهها دانست؛ ساختاری که پس از آموزش میتواند برای پیشبینی، طبقهبندی، تخمین یا انجام وظایف دیگر روی دادههای جدید استفاده شود.
برای درک دقیقتر این مفهوم، باید چهار اصطلاح را از یکدیگر جدا کنیم:
Algorithm → روش یادگیری از داده
Training → فرایند یادگیری
Model → نتیجهی یادگیری
بعد از آموزش نیز:
به همین دلیل، وقتی گفته میشود «یک مدل یادگیری ماشین ساخته شده است»، منظور صرفاً یک فایل یا یک الگوریتم نیست؛ بلکه یک ساختار آموزشدیده است که اطلاعات لازم برای انجام وظیفهی موردنظر را از دادهها یاد گرفته است.
شناخت مفهوم Model، پایهی درک بسیاری از مفاهیم بعدی یادگیری ماشین مانند Training، Prediction، Parameter، Hyperparameter، Overfitting، Underfitting، Model Evaluation و Model Deployment است.
اگر در مورد مفهوم Model در یادگیری ماشین سؤالی دارید یا تجربهای از ساخت مدل دارید، تجربهتان را در کامنت بنویسید. کدام بخش از این مبحث برایتان چالشبرانگیزتر بود؟