یادگیری نیمهنظارتی چیست؟ از مفهوم و نحوه کار تا الگوریتمها و کاربردها
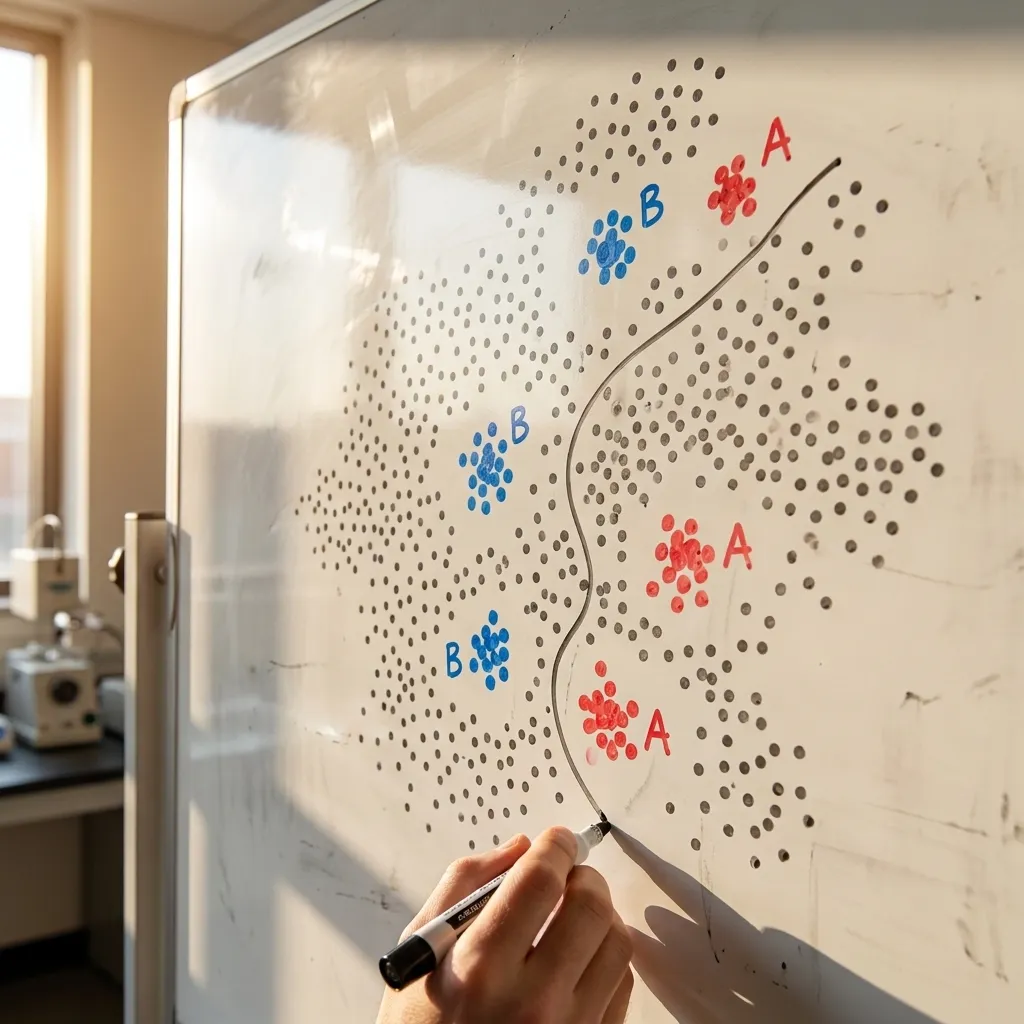
یادگیری نیمهنظارتی چیست؟ از مفهوم و نحوه کار تا الگوریتمها و کاربردها
یادگیری نیمهنظارتی چیست؟
یادگیری ماشین تنها به مدلهایی محدود نمیشود که برای آموزش به حجم زیادی از دادههای برچسبگذاریشده نیاز دارند. در بسیاری از مسائل واقعی، دادههای خام فراوانی در اختیار داریم، اما برچسبگذاری همه آنها به زمان، هزینه و نیروی انسانی زیادی نیاز دارد. یادگیری نیمهنظارتی (Semi-Supervised Learning) برای حل همین مسئله شکل گرفته است.
در یادگیری نیمهنظارتی، بخشی از دادهها دارای برچسب هستند و بخش بزرگتری از دادهها بدون برچسب باقی میمانند. مدل با استفاده همزمان از این دو نوع داده تلاش میکند الگوهای موجود در کل مجموعه داده را بهتر یاد بگیرد.
این رویکرد در شرایطی اهمیت زیادی دارد که تهیه داده آسان است، اما تعیین برچسب صحیح برای آنها دشوار یا پرهزینه است؛ برای مثال در تشخیص تصاویر پزشکی، طبقهبندی اسناد، تشخیص تقلب و برخی مسائل پیشبینی.
نکته: یادگیری نیمهنظارتی بین دو رویکرد یادگیری نظارتشده و یادگیری بدون نظارت قرار نمیگیرد، بلکه یک چارچوب یادگیری است که از اطلاعات هر دو نوع داده، یعنی دادههای برچسبدار و بدون برچسب، استفاده میکند.
در این مقاله چه چیزهایی یاد میگیرید؟
-
یادگیری نیمهنظارتی چیست و چرا به وجود آمده است؟ -
داده برچسبدار و بدون برچسب چه تفاوتی دارند؟ -
یادگیری نیمهنظارتی چگونه کار میکند؟ -
تفاوت آن با یادگیری نظارتشده و بدون نظارت چیست؟
فهرست مطالب
- یادگیری نیمهنظارتی چیست؟
- چرا به یادگیری نیمهنظارتی نیاز داریم؟
- داده برچسبدار و بدون برچسب چیست؟
- یادگیری نیمهنظارتی چگونه کار میکند؟
- تفاوت با یادگیری نظارتشده و بدون نظارت
- در چه مسائلی مناسب است؟
- مهمترین روشهای یادگیری نیمهنظارتی
- Pseudo-Labeling چیست؟
- روشهای مبتنی بر Graph
- روشهای Consistency-Based
- کاربردهای یادگیری نیمهنظارتی
- مزایا
- محدودیتها و چالشها
- یک مثال ساده
- جمعبندی
۱. یادگیری نیمهنظارتی چیست؟
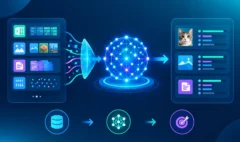
یادگیری نیمهنظارتی روشی در یادگیری ماشین است که در آن مدل برای یادگیری از ترکیبی از دادههای برچسبدار (Labeled Data) و دادههای بدون برچسب (Unlabeled Data) استفاده میکند.
فرض کنید یک مجموعه داده شامل ۱۰٬۰۰۰ نمونه در اختیار داریم. ممکن است تنها ۱٬۰۰۰ نمونه توسط متخصصان برچسبگذاری شده باشند و ۹٬۰۰۰ نمونه دیگر فاقد برچسب باشند.
در یادگیری نظارتشده، معمولاً مدل تنها از همان ۱٬۰۰۰ نمونه برچسبدار برای یادگیری استفاده میکند. اما در یادگیری نیمهنظارتی، هدف این است که اطلاعات موجود در ۹٬۰۰۰ نمونه بدون برچسب نیز تا حد امکان وارد فرایند یادگیری شود.
به صورت ساده:
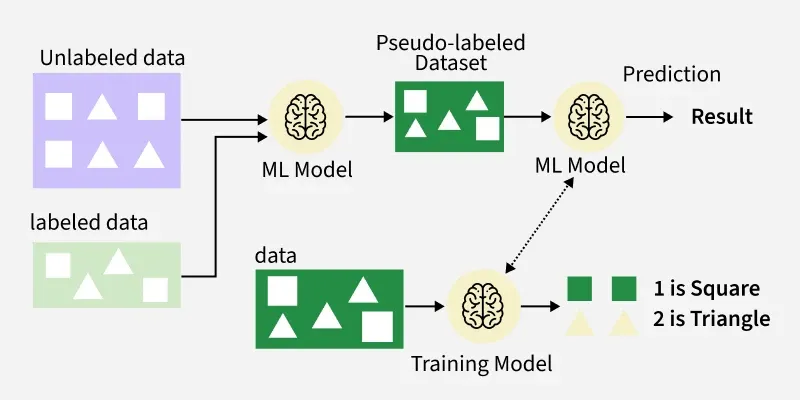
ایده اصلی این است که اگرچه دادههای بدون برچسب مستقیماً پاسخ درست را به مدل نمیگویند، اما میتوانند اطلاعات ارزشمندی درباره ساختار، توزیع و روابط میان نمونههای موجود در داده فراهم کنند.
۲. چرا به یادگیری نیمهنظارتی نیاز داریم؟
یکی از چالشهای مهم پروژههای یادگیری ماشین، تهیه داده برچسبدار است.
جمعآوری داده خام ممکن است نسبتاً ساده باشد، اما مشخص کردن برچسب صحیح برای هر نمونه همیشه آسان نیست.
برای مثال، فرض کنید هدف ساخت مدلی برای تشخیص یک بیماری از روی تصاویر پزشکی باشد. جمعآوری تعداد زیادی تصویر ممکن است امکانپذیر باشد، اما تعیین اینکه هر تصویر مربوط به کدام وضعیت پزشکی است، ممکن است به بررسی متخصص نیاز داشته باشد.
در چنین شرایطی ممکن است:
- داده بدون برچسب فراوان باشد؛
- داده برچسبدار محدود باشد؛
- برچسبگذاری به متخصص نیاز داشته باشد؛
- هزینه برچسبگذاری بالا باشد؛
- یا فرایند برچسبگذاری زمان زیادی ببرد.
یادگیری نیمهنظارتی تلاش میکند از دادههای بدون برچسب نیز برای بهبود فرایند یادگیری استفاده کند.
۳. داده برچسبدار و بدون برچسب چیست؟
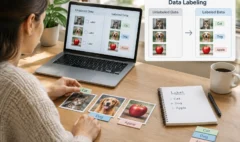
برای درک بهتر یادگیری نیمهنظارتی، ابتدا باید تفاوت این دو نوع داده را مشخص کنیم.
۳.۱. داده برچسبدار
در داده برچسبدار، علاوه بر ویژگیهای ورودی، پاسخ یا خروجی موردنظر نیز مشخص است.
برای مثال در مسئله تشخیص ایمیل:
| متن ایمیل | برچسب |
|---|---|
| پیام تبلیغاتی | Spam |
| پیام کاری | Not Spam |
| پیام تبلیغاتی | Spam |
در این حالت مدل میتواند رابطه میان ویژگیهای ورودی و برچسب خروجی را یاد بگیرد.
۳.۲. داده بدون برچسب
در داده بدون برچسب، اطلاعات ورودی در اختیار مدل قرار دارد اما پاسخ صحیح مشخص نشده است.
| متن ایمیل | برچسب |
|---|---|
| پیام جدید | ؟ |
| پیام جدید | ؟ |
| پیام جدید | ؟ |
مدل نمیداند هر نمونه دقیقاً به کدام کلاس تعلق دارد.
یادگیری نیمهنظارتی از ترکیب این دو نوع داده استفاده میکند.
۴. یادگیری نیمهنظارتی چگونه کار میکند؟
نحوه عملکرد دقیق یادگیری نیمهنظارتی به الگوریتم مورد استفاده بستگی دارد، اما ایده کلی را میتوان در چند مرحله توضیح داد.
مرحله اول: جمعآوری داده
ابتدا مجموعهای از دادههای برچسبدار و بدون برچسب در اختیار قرار میگیرد.
مرحله دوم: آموزش اولیه
مدل با استفاده از دادههای برچسبدار موجود آموزش داده میشود.
مرحله سوم: استفاده از دادههای بدون برچسب
مدل نمونههای بدون برچسب را بررسی میکند و بر اساس الگوهایی که یاد گرفته است، درباره آنها پیشبینی انجام میدهد.
مرحله چهارم: استفاده از اطلاعات قابل اعتماد
در برخی روشها، پیشبینیهایی که مدل نسبت به آنها اطمینان بالایی دارد، به عنوان برچسبهای موقت مورد استفاده قرار میگیرند.
مرحله پنجم: آموزش مجدد
مدل با استفاده از دادههای برچسبدار اولیه و اطلاعات استخراجشده از دادههای بدون برچسب، دوباره آموزش داده میشود.
این فرایند میتواند به شکل تکراری ادامه پیدا کند تا مدل به عملکرد مطلوب برسد.
۵. تفاوت یادگیری نیمهنظارتی با یادگیری نظارتشده و بدون نظارت
سه رویکرد را میتوان از نظر نوع داده مورد استفاده با یکدیگر مقایسه کرد:
| روش یادگیری | داده برچسبدار | داده بدون برچسب | ایده اصلی |
|---|---|---|---|
| یادگیری نظارتشده | زیاد | معمولاً استفاده نمیشود | یادگیری رابطه ورودی و خروجی |
| یادگیری بدون نظارت | ندارد | زیاد | کشف الگو و ساختار داده |
| یادگیری نیمهنظارتی | محدود | زیاد | استفاده همزمان از هر دو نوع داده |
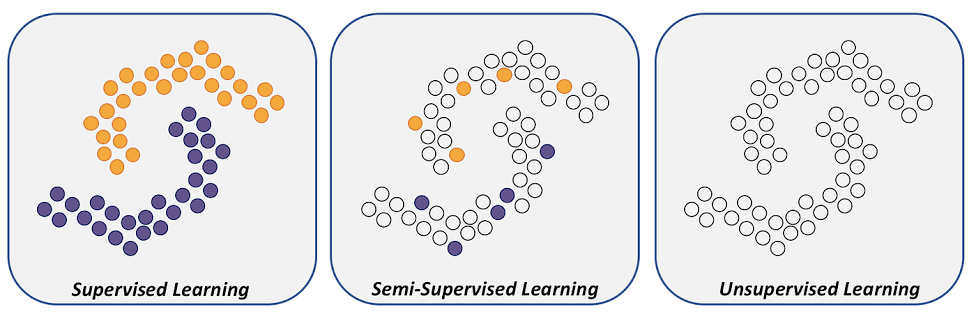
در یادگیری نظارتشده، وجود برچسب صحیح برای آموزش مدل اهمیت اساسی دارد.
در یادگیری بدون نظارت، مدل بدون دریافت پاسخ مشخص تلاش میکند ساختار موجود در داده را پیدا کند.
اما در یادگیری نیمهنظارتی، تعداد محدودی داده برچسبدار در کنار حجم بیشتری از دادههای بدون برچسب قرار میگیرد.
۶. یادگیری نیمهنظارتی در چه مسائلی مناسب است؟
یادگیری نیمهنظارتی زمانی جذابتر میشود که دو شرط اصلی وجود داشته باشد:
- دادههای بدون برچسب به مقدار قابل توجهی در دسترس باشند.
- تهیه برچسب برای دادهها دشوار، پرهزینه یا زمانبر باشد.
برای مثال، فرض کنید یک شرکت میلیونها رکورد تراکنش در اختیار دارد، اما تنها بخش کوچکی از تراکنشها توسط کارشناسان بررسی و به عنوان «تقلبی» یا «سالم» مشخص شدهاند.
در این وضعیت، دور ریختن تمام دادههای بدون برچسب منطقی نیست. یادگیری نیمهنظارتی میتواند امکان استفاده از اطلاعات این دادهها را فراهم کند.
۷. مهمترین روشهای یادگیری نیمهنظارتی
روشهای یادگیری نیمهنظارتی را میتوان بر اساس نحوه استفاده از دادههای بدون برچسب به چند گروه اصلی تقسیم کرد.
۷.۱. Self-Training
در روش Self-Training، ابتدا یک مدل با دادههای برچسبدار آموزش داده میشود.
سپس مدل دادههای بدون برچسب را پیشبینی میکند. نمونههایی که مدل نسبت به پیشبینی آنها اطمینان بالایی دارد، میتوانند به صورت موقت برچسبگذاری شوند.
پس از آن، این نمونهها همراه با دادههای اصلی برای آموزش مجدد مدل استفاده میشوند.
فرایند کلی:
این فرایند میتواند چندین بار تکرار شود.
یک نکته مهم: اگر مدل در ابتدا پیشبینی اشتباهی داشته باشد و همان پیشبینی اشتباه وارد داده آموزشی شود، خطا میتواند در مراحل بعدی نیز گسترش پیدا کند. بنابراین انتخاب نمونههای قابل اعتماد اهمیت زیادی دارد.
۸. Pseudo-Labeling چیست؟
Pseudo-Labeling یکی از روشهای رایج برای استفاده از دادههای بدون برچسب است.
در این روش، مدل روی دادههای بدون برچسب پیشبینی انجام میدهد و خروجی مدل به عنوان یک برچسب شبهواقعی یا Pseudo-Label برای برخی نمونهها مورد استفاده قرار میگیرد.
برای مثال، اگر مدل برای یک نمونه احتمال ۹۷ درصدی برای کلاس A و ۳ درصدی برای کلاس B پیشبینی کند، میتوان با تعیین یک آستانه مشخص، آن نمونه را با برچسب A وارد مرحله آموزش کرد.
البته این برچسب توسط انسان تعیین نشده است؛ بلکه خود مدل آن را ایجاد کرده است.
به همین دلیل، کیفیت و میزان اطمینان مدل اولیه در این روش اهمیت زیادی دارد.
۹. روشهای مبتنی بر Graph
در برخی مسائل، ارتباط میان نمونهها اهمیت زیادی دارد. در این شرایط میتوان دادهها را به صورت یک گراف (Graph) نمایش داد.
در این نمایش:
- هر نمونه میتواند یک گره باشد؛
- شباهت میان نمونهها میتواند به صورت یال نمایش داده شود؛
- برخی گرهها دارای برچسب هستند؛
- بسیاری از گرهها ممکن است بدون برچسب باشند.
ایده اصلی این است که اطلاعات موجود در گرههای برچسبدار از طریق ساختار گراف به نمونههای بدون برچسب منتقل شود.
این رویکرد بهویژه زمانی میتواند مفید باشد که نمونههای مشابه در داده احتمالاً برچسبهای مشابهی داشته باشند.
۱۰. روشهای Consistency-Based
یکی دیگر از ایدههای مهم در یادگیری نیمهنظارتی، یادگیری مبتنی بر سازگاری (Consistency) است.
در این روش فرض میشود اگر تغییرات کوچک و منطقی در یک نمونه ایجاد شود، پیشبینی مدل نیز نباید به شکل شدید تغییر کند.
برای مثال، اگر یک تصویر کمی تغییر کند، مدل همچنان باید همان کلاس را برای آن پیشبینی کند.
بنابراین مدل علاوه بر یادگیری از دادههای برچسبدار، تشویق میشود که برای نسخههای مختلف یک نمونه بدون برچسب نیز پیشبینیهای سازگار داشته باشد.
این ایده در بسیاری از روشهای مدرن یادگیری نیمهنظارتی، بهویژه در یادگیری عمیق، اهمیت زیادی پیدا کرده است.
۱۱. روشهای مبتنی بر فرض ساختار داده
بخش مهمی از الگوریتمهای نیمهنظارتی بر این فرض استوارند که دادهها در فضای ویژگی دارای ساختار خاصی هستند.
یکی از ایدههای شناختهشده در این زمینه، فرض خوشهای (Cluster Assumption) است.
بر اساس این ایده، اگر نمونهها در چند ناحیه یا خوشه قرار گرفته باشند، نمونههایی که در یک ناحیه قرار دارند، احتمالاً برچسبهای مشابهی دارند.
به عنوان مثال، اگر دادهها در فضای ویژگی به دو خوشه کاملاً جدا تقسیم شده باشند و تنها چند نمونه از هر خوشه برچسب داشته باشند، ساختار داده میتواند به مدل در تعیین برچسب نمونههای دیگر کمک کند.
۱۲. کاربردهای یادگیری نیمهنظارتی
یادگیری نیمهنظارتی در مسائلی کاربرد دارد که داده خام فراوان اما داده برچسبدار محدود است.
۱۲.۱. تشخیص پزشکی
در حوزه پزشکی، دادههایی مانند تصاویر پزشکی، پروندهها و سیگنالهای زیستی میتوانند حجم زیادی داشته باشند، اما برچسبگذاری دقیق آنها معمولاً به متخصص نیاز دارد.
یادگیری نیمهنظارتی میتواند برای استفاده از دادههای برچسبدار محدود در کنار حجم بیشتری از دادههای بدون برچسب مورد استفاده قرار گیرد.
۱۲.۲. پردازش تصویر
در مسائل طبقهبندی و تشخیص تصویر، تهیه مجموعه داده بزرگ و کاملاً برچسبگذاریشده ممکن است هزینهبر باشد.
استفاده از دادههای بدون برچسب میتواند به کاهش وابستگی مدل به دادههای کاملاً برچسبدار کمک کند.
۱۲.۳. تشخیص تقلب
در تشخیص تراکنشهای مشکوک، معمولاً تعداد بسیار زیادی تراکنش ثبت میشود، اما بررسی و برچسبگذاری همه آنها امکانپذیر نیست.
دادههای بدون برچسب در کنار نمونههای بررسیشده میتوانند برای ساخت مدلهای تشخیص تقلب مورد استفاده قرار گیرند.
۱۲.۴. طبقهبندی اسناد و متن
در مسائل طبقهبندی اسناد، ممکن است میلیونها متن در اختیار باشد اما تنها بخش کوچکی از آنها توسط متخصصان دستهبندی شده باشند.
یادگیری نیمهنظارتی میتواند از اطلاعات موجود در مجموعه بزرگتر برای بهبود مدل استفاده کند.
۱۲.۵. پیشبینی در حوزه انرژی
در حوزه انرژی نیز ممکن است حجم زیادی از دادههای مصرف، تولید یا رفتار کاربران در دسترس باشد، در حالی که ایجاد برچسبهای دقیق برای تمام نمونهها دشوار باشد.
در چنین شرایطی، روشهای نیمهنظارتی میتوانند در برخی مسائل طبقهبندی، تشخیص وضعیت و تحلیل الگوهای مصرف مورد استفاده قرار گیرند.
۱۳. مزایای یادگیری نیمهنظارتی
مهمترین مزایای این رویکرد عبارتاند از:
کاهش نیاز به دادههای برچسبدار
مهمترین مزیت یادگیری نیمهنظارتی این است که مدل الزاماً به مجموعه بزرگی از دادههای برچسبدار وابسته نیست.
استفاده از دادههای موجود
اگر حجم زیادی داده بدون برچسب در اختیار باشد، میتوان از آنها در کنار دادههای برچسبدار استفاده کرد.
کاهش هزینه برچسبگذاری
در بسیاری از پروژهها، برچسبگذاری توسط متخصصان یکی از پرهزینهترین مراحل آمادهسازی داده است. کاهش نیاز به برچسبگذاری کامل میتواند هزینه پروژه را کاهش دهد.
افزایش امکان استفاده از دادههای واقعی
در بسیاری از محیطهای واقعی، دادهها به صورت طبیعی تولید میشوند اما برچسب ندارند. یادگیری نیمهنظارتی برای چنین شرایطی طراحی شده است.
۱۴. محدودیتها و چالشهای یادگیری نیمهنظارتی
با وجود مزایای قابل توجه، یادگیری نیمهنظارتی همیشه بهترین انتخاب نیست.
۱۴.۱. انتشار خطا
اگر مدل برچسب اشتباهی برای داده بدون برچسب ایجاد کند و این برچسب وارد فرایند آموزش شود، خطا میتواند به مراحل بعدی منتقل شود.
۱۴.۲. وابستگی به کیفیت داده
اگر دادههای بدون برچسب بسیار متفاوت از دادههای برچسبدار باشند، استفاده از آنها ممکن است حتی به عملکرد مدل آسیب برساند.
۱۴.۳. حساسیت به آستانه اطمینان
در روشهایی مانند Pseudo-Labeling باید مشخص شود چه پیشبینیهایی به اندازه کافی مطمئن هستند که به عنوان برچسب مورد استفاده قرار گیرند.
انتخاب آستانه نامناسب میتواند باعث ورود تعداد زیادی برچسب اشتباه یا حذف بیش از حد نمونههای مفید شود.
۱۴.۴. پیچیدگی مدل و آموزش
برخی روشهای نیمهنظارتی، بهویژه روشهای پیشرفته مبتنی بر یادگیری عمیق، ممکن است نسبت به یک مدل نظارتشده ساده پیچیدگی بیشتری داشته باشند.
۱۵. چه زمانی نباید از یادگیری نیمهنظارتی استفاده کرد؟
وجود داده بدون برچسب به تنهایی به این معنی نیست که استفاده از یادگیری نیمهنظارتی حتماً مفید خواهد بود.
اگر دادههای بدون برچسب:
- کیفیت بسیار پایینی داشته باشند؛
- با دادههای برچسبدار تفاوت اساسی داشته باشند؛
- دارای نویز شدید باشند؛
- یا ساختار مناسبی برای انتقال اطلاعات نداشته باشند،
استفاده از آنها ممکن است بهبود قابل توجهی ایجاد نکند.
همچنین اگر مقدار کافی داده برچسبدار با کیفیت بالا در اختیار باشد و مدل نظارتشده عملکرد مناسبی ارائه دهد، لزوماً نیازی به استفاده از یک روش نیمهنظارتی پیچیده وجود ندارد.
بنابراین، انتخاب روش باید بر اساس ماهیت داده، هدف مسئله، هزینه برچسبگذاری و عملکرد مورد انتظار انجام شود.
۱۶. یک مثال ساده از یادگیری نیمهنظارتی
فرض کنید یک فروشگاه اینترنتی ۱۰۰٬۰۰۰ نظر مشتری درباره محصولات خود دارد.
تنها ۵٬۰۰۰ نظر توسط کارشناسان به دو گروه «مثبت» و «منفی» تقسیم شدهاند و ۹۵٬۰۰۰ نظر دیگر بدون برچسب هستند.
اگر از یادگیری نظارتشده استفاده شود، مدل عمدتاً از همان ۵٬۰۰۰ نظر برچسبدار برای یادگیری استفاده خواهد کرد.
اما در یک روش نیمهنظارتی میتوان ابتدا مدل را با ۵٬۰۰۰ نظر آموزش داد و سپس از آن برای تحلیل ۹۵٬۰۰۰ نظر بدون برچسب استفاده کرد.
اگر مدل برای برخی نظرات اطمینان بالایی داشته باشد، میتوان از این پیشبینیها به عنوان برچسبهای شبهواقعی استفاده کرد و مدل را با مجموعه داده بزرگتری آموزش داد.
در این مثال، هدف اصلی این نیست که دادههای بدون برچسب را صرفاً «برچسبگذاری» کنیم؛ بلکه هدف استفاده از اطلاعات موجود در آنها برای یادگیری بهتر الگوی کلی داده است.
۱۷. چگونه یک روش نیمهنظارتی مناسب انتخاب کنیم؟
انتخاب الگوریتم باید با توجه به ویژگیهای مسئله انجام شود.
پیش از انتخاب روش، بهتر است چند سؤال مطرح شود:
چه مقدار داده برچسبدار داریم؟
اگر داده برچسبدار بسیار محدود باشد، روشهایی که به شکل مؤثرتری از داده بدون برچسب استفاده میکنند میتوانند جذابتر باشند.
دادههای بدون برچسب چقدر به دادههای برچسبدار شباهت دارند؟
اگر این دو مجموعه از یک توزیع متفاوت باشند، استفاده از دادههای بدون برچسب ممکن است نتیجه مطلوبی نداشته باشد.
کیفیت برچسبهای موجود چقدر است؟
روشهای نیمهنظارتی معمولاً از داده برچسبدار برای شروع یا هدایت فرایند یادگیری استفاده میکنند. بنابراین کیفیت این دادهها اهمیت زیادی دارد.
هزینه خطا چقدر است؟
در کاربردهای حساس، مانند پزشکی یا تصمیمگیریهای مالی، استفاده از برچسبهای تولیدشده توسط مدل باید با دقت بیشتری کنترل شود.
۱۸. آیا یادگیری نیمهنظارتی همیشه باعث بهبود مدل میشود؟
خیر.
یکی از اشتباهات رایج این است که تصور کنیم اضافه کردن دادههای بدون برچسب همیشه عملکرد مدل را بهتر میکند.
مزیت یادگیری نیمهنظارتی به این موضوع وابسته است که دادههای بدون برچسب واقعاً اطلاعات مفیدی درباره مسئله داشته باشند.
اگر مدل از دادههای بدون برچسب الگوهای اشتباه یاد بگیرد، ممکن است عملکرد آن کاهش پیدا کند.
بنابراین، عملکرد یک مدل نیمهنظارتی باید با یک مدل نظارتشده مناسب مقایسه شود و استفاده از دادههای بدون برچسب نیز به صورت تجربی ارزیابی شود.
۱۹. جمعبندی
یادگیری نیمهنظارتی (Semi-Supervised Learning) روشی در یادگیری ماشین است که از ترکیب دادههای برچسبدار و بدون برچسب برای آموزش مدل استفاده میکند.
اهمیت این رویکرد بیشتر در شرایطی مشخص میشود که تهیه داده آسان باشد، اما برچسبگذاری آنها به تخصص، زمان یا هزینه زیادی نیاز داشته باشد.
در این روش، الگوریتمهایی مانند Self-Training، Pseudo-Labeling، روشهای مبتنی بر Graph و روشهای Consistency-Based تلاش میکنند از اطلاعات موجود در دادههای بدون برچسب نیز استفاده کنند.
با این حال، یادگیری نیمهنظارتی یک راهحل جادویی نیست. کیفیت داده، شباهت میان دادههای برچسبدار و بدون برچسب، میزان خطای مدل اولیه و نحوه انتخاب نمونههای قابل اعتماد، همگی میتوانند بر نتیجه نهایی تأثیر بگذارند.
در نتیجه، بهترین زمان برای استفاده از یادگیری نیمهنظارتی زمانی است که دادههای بدون برچسب فراوان، دادههای برچسبدار محدود و هزینه برچسبگذاری قابل توجه باشد و در عین حال ساختار داده امکان استخراج اطلاعات مفید از نمونههای بدون برچسب را فراهم کند.
این روش در کنار یادگیری نظارتشده و یادگیری بدون نظارت، یکی از رویکردهای مهم برای حل مسائل واقعی یادگیری ماشین است.
برای درک بهتر یادگیری ماشین، همیشه تفاوت دادههای برچسبدار، بدون برچسب و روشهای ترکیبی را در نظر بگیرید.